Principal Engineer & Cloud Architect. Focado em arquitetura de software, IA agêntica, governança de código (SDD/Harness) e FinOps de inferência local. Menos hype, mais fundamentos e cicatrizes reais de produção.
·
12 min. de leitura
O mito do imposto de token e a soberania de infraestrutura em IA
Parece cena de ficção científica: uma cancela de pedágio aos pés da pirâmide da Tyrell Corp cobrando uma taxa por cada bit do seu código. Daria pra chamar de “imposto de token” essa tentativa de criar um lock-in onde três ou quatro fornecedores de IA precificam cada linha de código que o seu time digita.
A armadilha é conveniente para quem vende: empacota modelos como caixas-pretas e convence todo mundo de que o único jeito de inovar é manter a bandeira 2 rodando na API deles 24 horas por dia. Se você não pagar, sua empresa fica para trás.
Só esqueceram de combinar com a matemática da infraestrutura e com quem realmente audita a fatura no fim do mês.
A economia real dos pesos abertos e evolução dos modelos chineses estão implodindo esse pseudo-cartel. Inteligência agora é capacidade computacional fungível. Insistir em pagar pedágio por token para APIs fechadas não é um padrão técnico, é miopia financeira.
1. O “Sócio Oculto” e a Mecânica da Janela de Contexto
Para entender por que a fatura de API explode sem aviso prévio, basta olhar como o desenvolvimento moderno assistido por IA realmente funciona na trincheira.
Ninguém mais programa abrindo aba de navegador para pedir regex isolada. A gente pluga agentes direto no editor (Zed Agent, Claude Code, extensões via MCP). Esses agentes varrem a árvore de arquivos, puxam definições de tipos, leem logs de teste e mantêm o histórico da sessão para não perder o fio da meada.
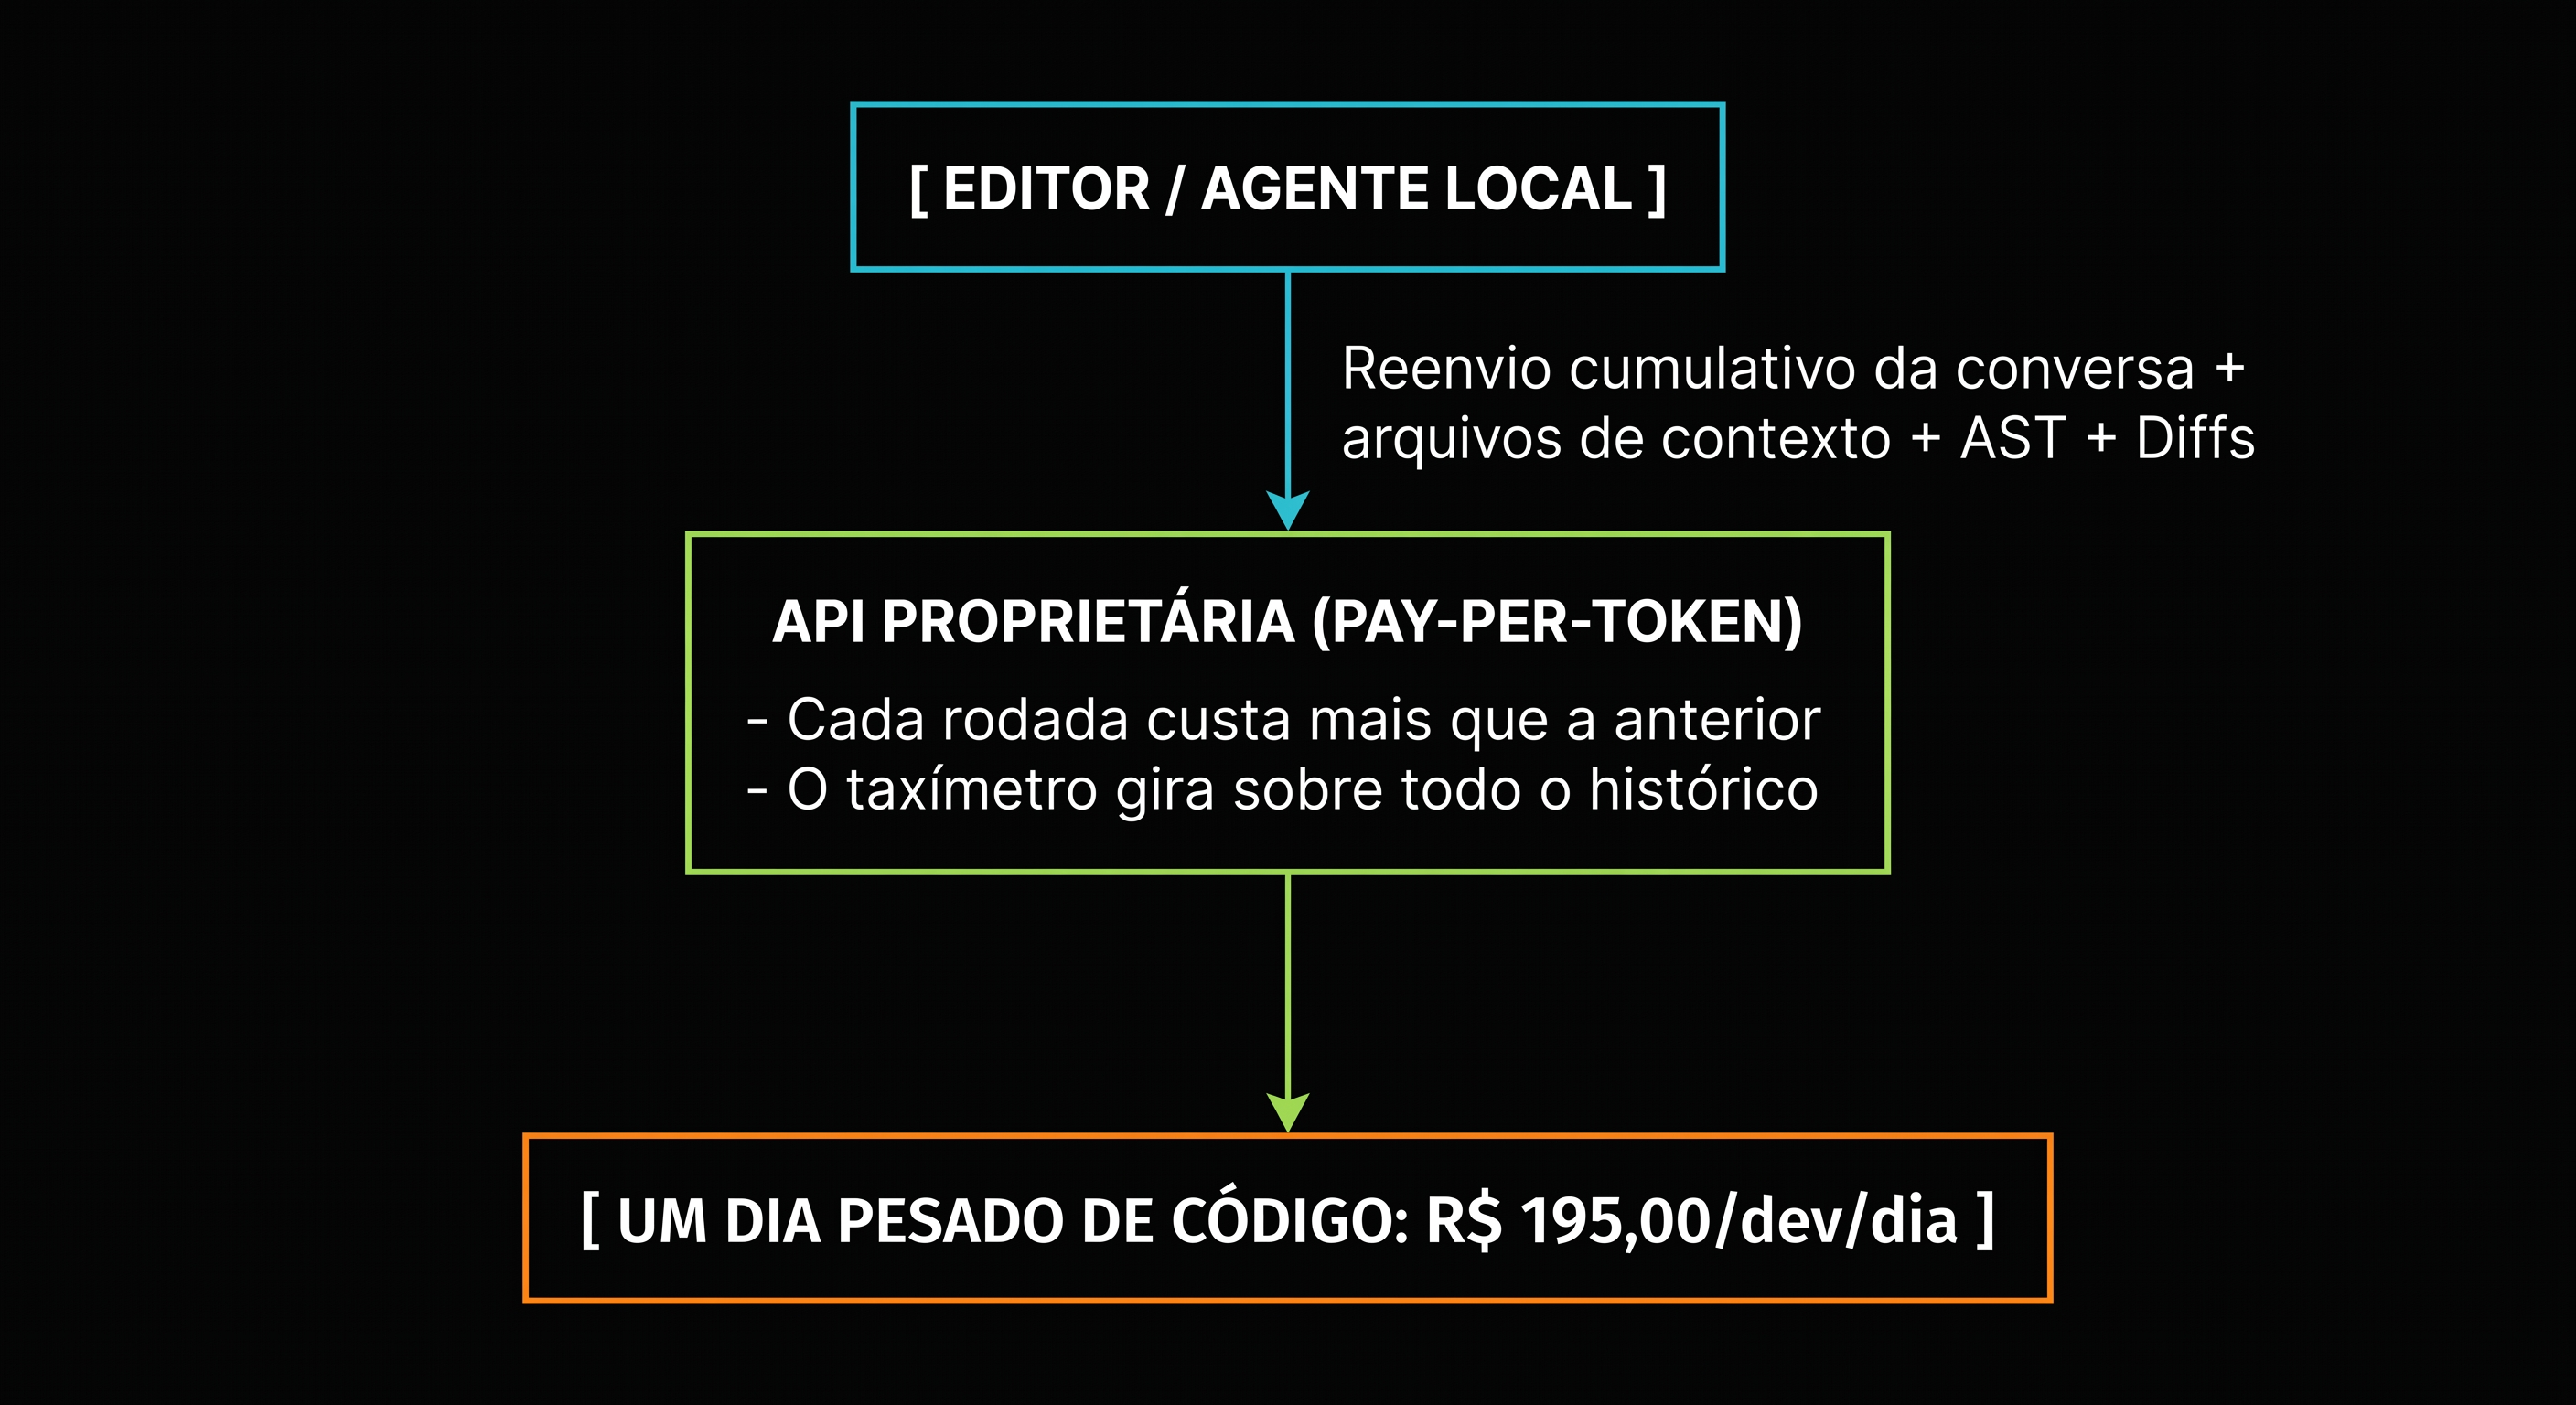
E aqui mora a pegadinha: o modelo pay-per-token pune de maneira exponencial qualquer fluxo com sessões longas e contexto acumulado.
O sócio oculto na sua IDE: faturando em cima de cada Enter enquanto o seu time tenta fechar a sprint.
A cada mensagem em uma sessão de debug, o editor não envia só os 15 caracteres que você acabou de digitar. Ele empacota todo o histórico acumulado, os diffs e os arquivos abertos. Se a sua sessão já tem 80k tokens de contexto, cada Enter faz o taxímetro rodar sobre esses 80k inteiros de entrada, além dos tokens gerados na resposta.
A Conta Real da Trincheira
Quando você audita o tráfego real de agentes em produção, o volume assusta quem ainda calcula custo achando que IA é prompt de uma linha:
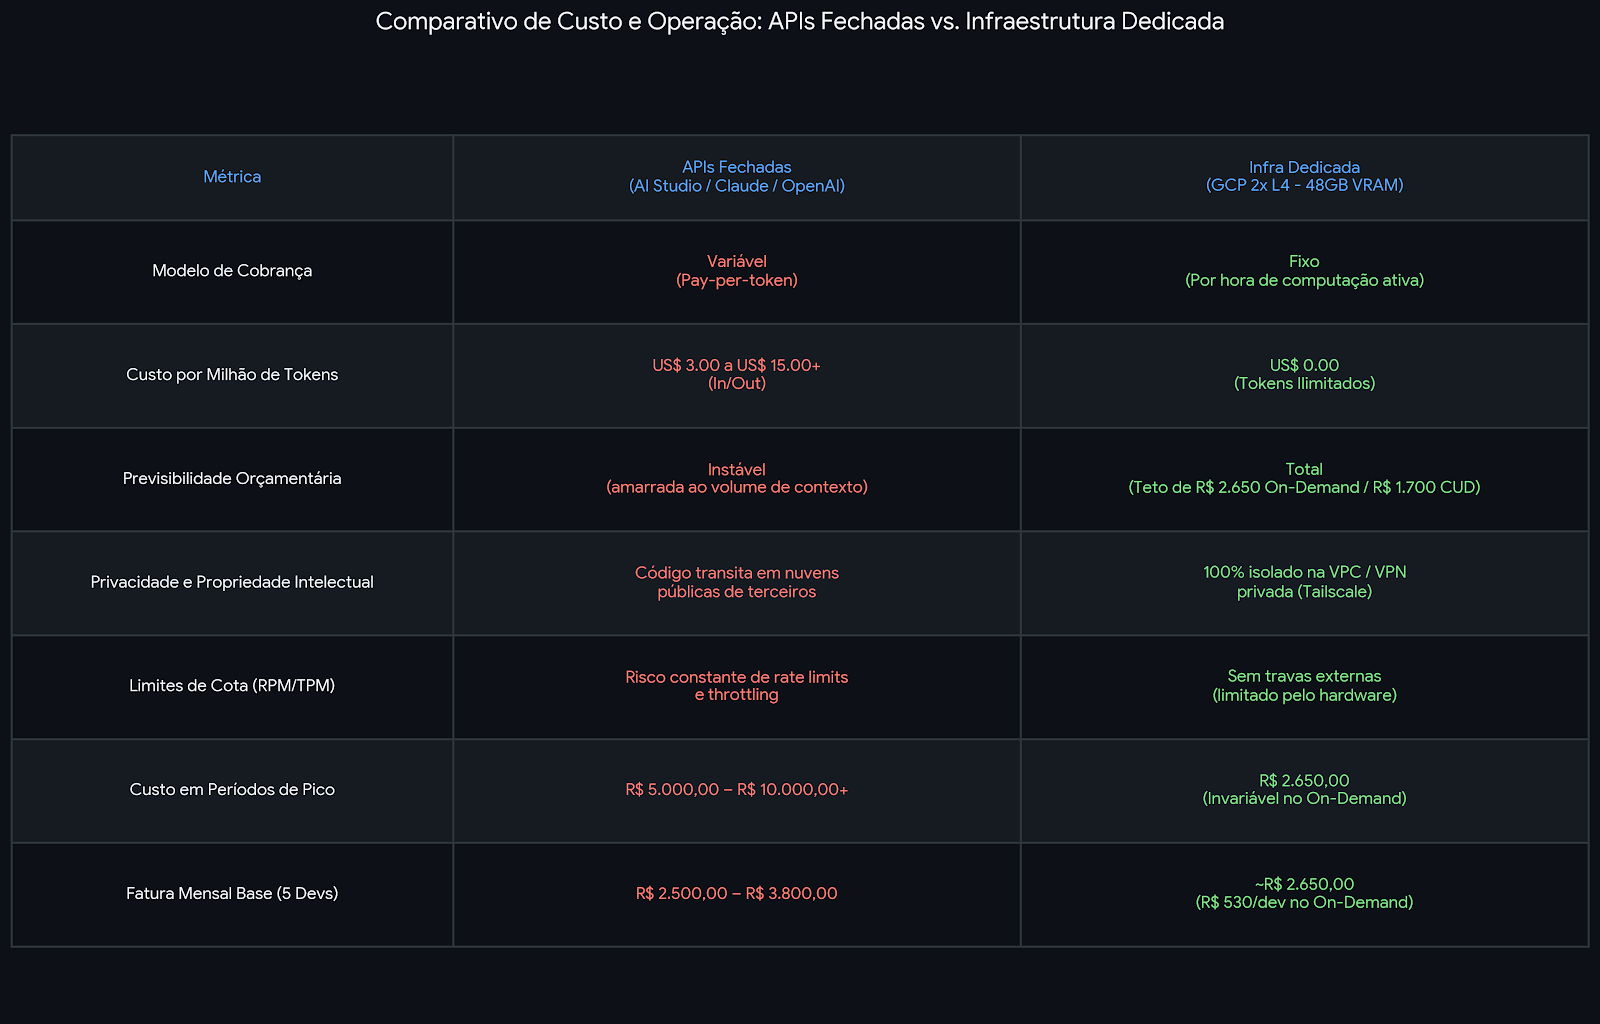
Dia a dia comum (Ritmo padrão): Um desenvolvedor ativo gera fácil ~20 milhões de tokens/dia entre leituras de contexto, diffs de PR e rodadas de teste. A um custo médio de ~R$ 35,00/dia, isso dá R$ 500 a R$ 770/mês por dev no cenário mais calmo.
Dia de refatoração pesada (O ralo de dinheiro): Em dias de épico novo, migração de banco ou caça a bugs em sistemas distribuídos, o consumo bate tranquilamente 100 milhões de tokens em 24 horas.
O susto no cartão: Um único engenheiro queimando R$ 195,00 em um único dia de trabalho.
Multiplique isso por um time de 5 a 8 pessoas acelerando para entregar uma release: a conta salta de R$ 2.500,00 para R$ 6.000,00 a R$ 10.000,00+ no final do mês sem você nem ver a cor do dinheiro.
Parabéns: você colocou um sócio oculto dentro da sua IDE. Alguém que lucra mais a cada vez que o seu time resolve trabalhar duro.
2. A Comoditização Acelerada: Pesos Abertos vs. APIs Fechadas
Countermeasures_Electronics) corporativo: o firewall de 1 milhão de tokens tentando vender como privilégio o que já virou commodity.*
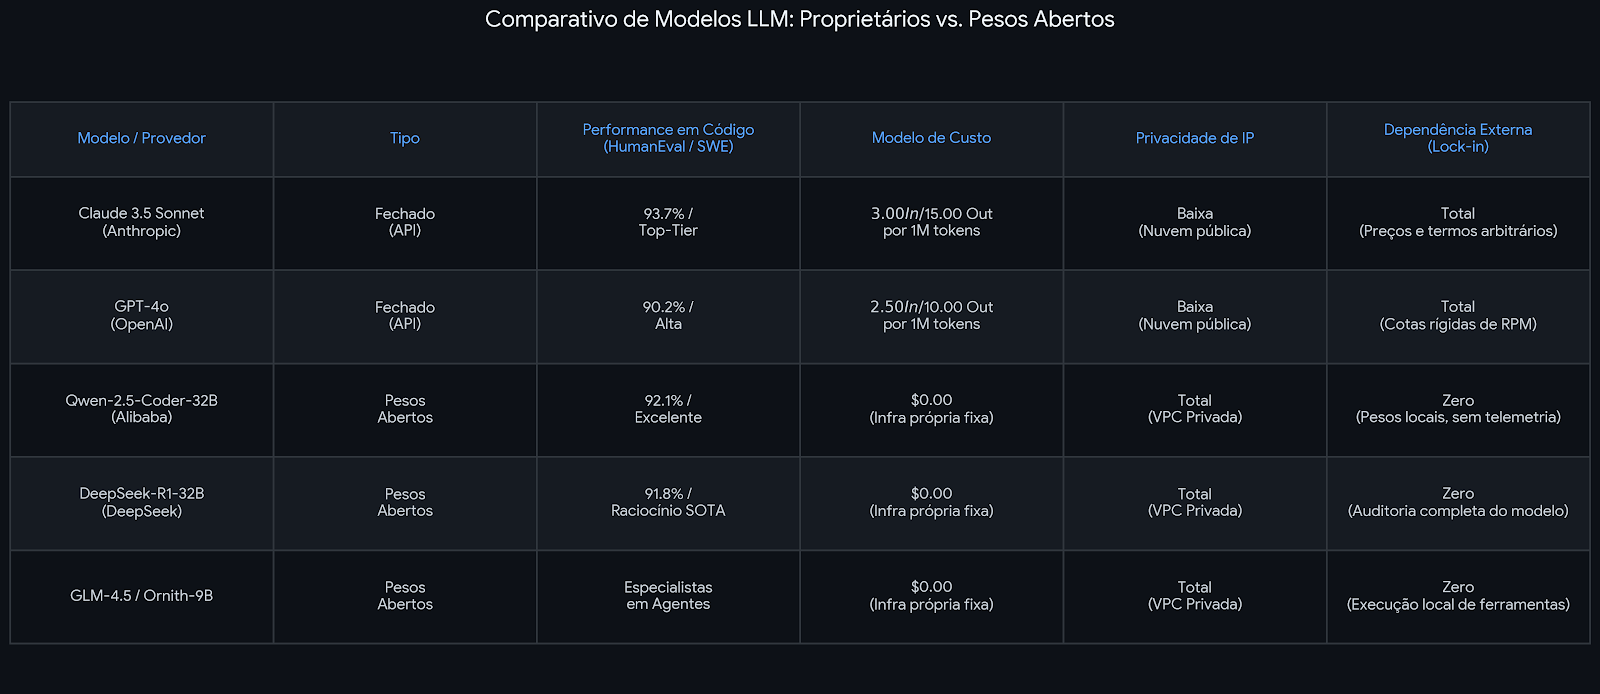
A narrativa de que só superclusters de 100 bilhões de dólares conseguem gerar código de ponta envelheceu rápido. As megacorps adoram estampar “1M de tokens” e “acesso exclusivo” em murais corporativos para justificar o lock-in, mas no dia a dia da engenharia de software, modelos abertos modernos já entregam paridade técnica com as APIs mais caras do mercado.
Tabela Comparativa de Mercado
Com a maturidade das técnicas de quantização (AWQ, FP8, GGUF) e engines de inferência de alto throughput como o vLLM e o Ollama, a barreira de entrada despencou: rodar esses modelos deixou de ser ficção e virou computação padrão de nuvem.
3. A Arquitetura Real: 48 GB de VRAM e Gestão Ativa de Ciclo
O Cyberdeck moderno: infraestrutura dedicada e controle total da sua própria computação.
Para dimensionar um cenário real, considere esta arquitetura provisionada na Google Cloud (GCP):
Instância:g2-standard-24 (24 vCPUs, 96 GB de RAM de sistema).
Aceleração Gráfica:2x NVIDIA L4 (24 GB de VRAM cada = 48 GB de VRAM total).
Modo de Execução:Tensor Parallelism (tp=2) rodando vLLM ou Ollama.
Gestão Ativa de Ciclo (Cloud Scheduler / Cron): A máquina sobe às 08:45 e desliga às 19:15 em dias úteis.
Janela Ativa: ~10,5 horas por dia útil (22 dias úteis = 231 horas/mês), com custo zero em madrugadas e finais de semana.
Por que 48 GB de VRAM é o Ponto de Equilíbrio?
Em uma GPU isolada de 24 GB, um modelo de 32B consome quase toda a memória só para carregar os pesos. Sobra quase nada para o contexto — no primeiro Enter simultâneo de dois desenvolvedores, a placa bate no teto de VRAM ou estrangula a fila de inferência.
Dobrando para 48 GB de VRAM (2x L4 ou 1x RTX 6000 Ada), a física da memória joga a seu favor:
Carga dos Pesos: O Qwen-2.5-Coder-32B quantizado (FP8 ou AWQ) consome ~22 GB de VRAM, divididos limpos entre as placas via Tensor Parallelism (tp=2).
Área de Manobra para KV Cache: Sobram mais de 20 GB de VRAM dedicados para PagedAttention.
Concorrência Real de Time: A máquina segura de 5 a 8 desenvolvedores trabalhando ao mesmo tempo em janelas longas (16k a 32k tokens), sem fila, sem degradação de Time to First Token (TTFT) e com risco zero de Out Of Memory (OOM).
4. A Matemática da Infraestrutura Própria: Fixo vs. Variável
O custo sob demanda (On-Demand) da g2-standard-24 com 2x L4 fica em aproximadamente $2,00/hora (computação + 2 GPUs). Em 231 horas ativas no mês (apenas horário de expediente), a fatura fecha em ~$462 USD (cerca de R$ 2.650,00/mês convertidos com impostos).
Com desconto de uso contínuo (CUD de 1 ano na GCP), esse valor cai para cerca de R$ 1.700/mês.
A Alternativa em Nuvens Especializadas de GPU (RunPod / Lambda Labs)
Se a operação não tem amarras com os grandes provedores tradicionais de nuvem, plataformas focadas em GPU derrubam ainda mais a conta:
Hardware: 1x NVIDIA RTX 6000 Ada (48 GB VRAM em placa única) no Secure Cloud do RunPod.
Ganho prático: Com 48 GB em uma única placa, o vLLM roda direto (tp=1), sem a sobrecarga de dividir tensores entre placas. Uma única instância dessas atende de 8 a 10 desenvolvedores em paralelo por menos do que a assinatura de dois planos comerciais de ponta.
Para Desenvolvedores Solo e Equipes Enxutas: GPU Serverless (Scale to Zero)
Para quem trabalha solo ou em times de até 3 engenheiros e não quer pagar nem a hora ociosa de almoço ou reuniões, a saída é o GPU Serverless com Scale to Zero (via RunPod Serverless ou Cloud Run com GPU no GCP):
Como funciona: Você expõe o endpoint do vLLM. Sem requisição na fila, a infraestrutura vai a zero absoluto (custo de R$ 0,00).
Cobrança por segundo real: No instante em que você dá um Enter no editor ou dispara um loop de agente, uma GPU acorda, processa a inferência e cobra cerca de $0,0002 por segundo ativo.
A conta prática: 120 segundos de um loop agêntico pesado custam cerca de $0,02 USD (~R$ 0,14). Um dia inteiro com 50 execuções densas fecha em menos de R$ 8,00, com zero cobrança em noites e fins de semana. O único trade-off é o cold start de 20 a 30 segundos na primeira chamada do dia para subir os pesos na VRAM via barramento PCIe.
Comparativo Técnico e Financeiro
O Custo Marginal Zero
Em infraestrutura própria, o custo marginal do token é rigorosamente zero.
Se um desenvolvedor consome 20 milhões ou ultrapassa 100 milhões de tokens em um dia de depuração pesada, a fatura no fim do mês não mexe um centavo. A capacidade já está provisionada.
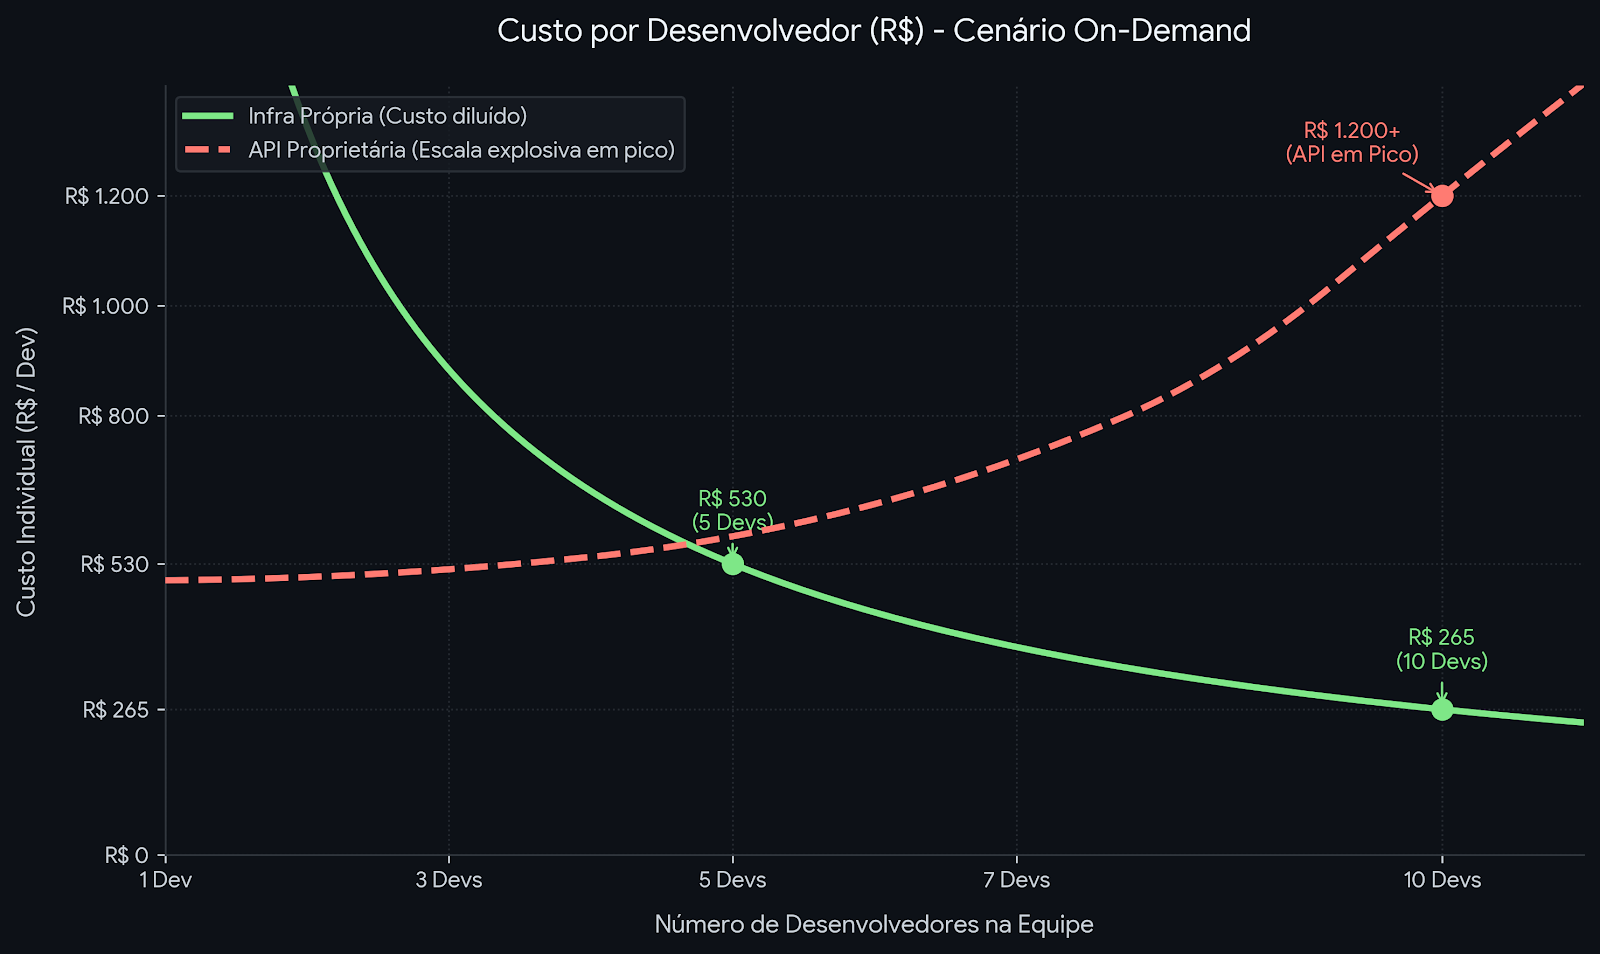
A dinâmica da escala se inverte:
Com 5 desenvolvedores, o custo unitário fica em R$ 530,00/dev no On-Demand (ou R$ 340,00/dev com CUD).
Ao expandir para 10 desenvolvedores, o custo unitário cai pela metade: R$ 265,00/dev (ou R$ 170,00/dev com CUD).
Em APIs proprietárias, a produtividade do time vira passivo financeiro. Na infraestrutura própria, ela é absorvida com custo marginal zero.
“Mas pagar aluguel de nuvem para GCP ou RunPod não é só trocar um pedágio por outro?”
A confusão mora em misturar taxímetro de transação com compra de capacidade. Na API fechada, se o seu time codifica 10x mais ou dispara agentes em loops complexos, a fatura decuplica de forma punitiva. Na GPU dedicada, a vazão é sua: o consumo pode explodir, mas o custo financeiro permanece fixo. Além disso, a GPU é uma commodity fungível: se o provedor subir o preço, seu container com pesos abertos migra em minutos para qualquer outra nuvem ou volta para hardware próprio no rack. No modelo de APIs proprietárias, essa liberdade simplesmente não existe.
5. Endereçando os Trade-offs: Engenharia sem Ilusões
Toda decisão de arquitetura envolve escolhas e concessões. Vale analisar com frieza os três principais contra-argumentos levantados a favor do modelo SaaS:
1. “O Custo Operacional de Manutenção não Inviabiliza a Conta?”
Operar uma instância dedicada não exige uma equipe de DevOps nem um cluster frágil de Kubernetes. A implementação padrão utiliza infraestrutura imutável via Terraform / OpenTofu combinada com um script determinístico de cloud-init:
A máquina sobe, anexa os discos persistentes com os pesos dos modelos, inicia o container do vLLM / Ollama e conecta-se à malha segura da VPN (Tailscale).
O esforço de setup inicial é de menos de um dia de trabalho. Não existe manutenção recorrente de sistema: a máquina é descartável e stateless.
2. “E a Janela de 1 Milhão de Tokens das APIs Comerciais?”
Provedores adoram estampar janelas de 1M a 2M de tokens em seus materiais de marketing. Na prática da engenharia de software, despejar um milhão de tokens no prompt (prompt dumping) é um atalho que introduz alucinações caras e latências elevadas.
Quando o time aplica princípios sólidos de engenharia — como Spec-Driven Development, harnesses bem calibrados e memória de código baseada em grafos estruturados via MCP (discussão densa que vale um ensaio técnico à parte) —, o contexto necessário para resolver 95% das tarefas cabe com precisão cirúrgica em janelas enxutas de 16k a 32k tokens. Dentro desse intervalo, a latência de inferência local em 48GB de VRAM supera com folga o tempo de resposta de APIs públicas congestionadas.
3. O Modelo Híbrido Pragmático (Roteamento de 85/15)
Adotar modelos abertos não significa isolacionismo dogmático. A arquitetura mais eficiente é a de Roteamento Hierárquico:
Tier 1 (Local / Infra Própria - ~85% a 90% do tráfego): Modelos abertos dentro da VPC absorvem todo o volume diário de autocompletion, refatoração, geração de testes, CI e tarefas de background.
Tier 2 (API sob exceção - ~10% a 15%): Chamadas pontuais para modelos proprietários gigantes apenas em tarefas extraordinárias de raciocínio multimodal ou análises fora do escopo habitual.
Para orquestrar essa divisão de forma transparente, o ecossistema open-source oferece soluções prontas:
Roteadores de Contexto e Gateways (Estilo OpenRouter Self-Hosted): Ferramentas como OmniRouter, LiteLLM Proxy e RouteLLM (LMSYS) expõem um endpoint único compatível com OpenAI para as IDEs, balanceando requisições, gerenciando fallbacks automáticos e direcionando queries por complexidade semântica.
Governança, DLP e Hub MCP: Plataformas como o SystemPrompt.io (self-hosted em Rust) atuam como firewall e host central de Model Context Protocol, interceptando vazamento de credenciais nos prompts e bloqueando execuções destrutivas de agentes autônomos.
6. Ganhos Arquiteturais Além da Planilha
A previsibilidade financeira é o que salta aos olhos, mas a autonomia técnica traz vantagens estruturais permanentes:
Perímetro Fechado de Propriedade Intelectual e Fim do “Shadow AI”
Como o IndyDevDan apontou: quem terceiriza inteligência para modelos proprietários paga a conta duas vezes. Ou seja, desembolsa a fatura em dólar por token e ainda entrega de bandeja o contexto, os fluxos operacionais e a propriedade intelectual do produto para alimentar a telemetria dos grandes laboratórios.
Além disso, existe o elefante na sala: o Shadow AI. Em quase toda empresa, colaboradores copiam planilhas, reports, documentos e contratos confidenciais para colar no ChatGPT ou Claude web atrás de resumos rápidos. Proibir por memorando ou bloquear via firewall corporativo não é efetivo: modelos multimodais entendem texto em imagem com perfeição e rodam em qualquer smartphone pessoal no 5G. A única saída real é desenhar um Pit of Success: oferecer uma interface interna soberana conectada à infraestrutura própria da empresa, tornando o caminho seguro o mais fácil de usar.
Ao rodar modelos dentro da sua VPC conectada via Cloud VPN ou Tailscale, essa sangria acaba. Esquemas de bancos de dados, regras de negócio, dados de clientes e segredos de infraestrutura permanecem estritamente dentro do seu perímetro de segurança. Nada transita por endpoints públicos e nada vira insumo de treino externo.
Fim do Estrangulamento por Rate Limit
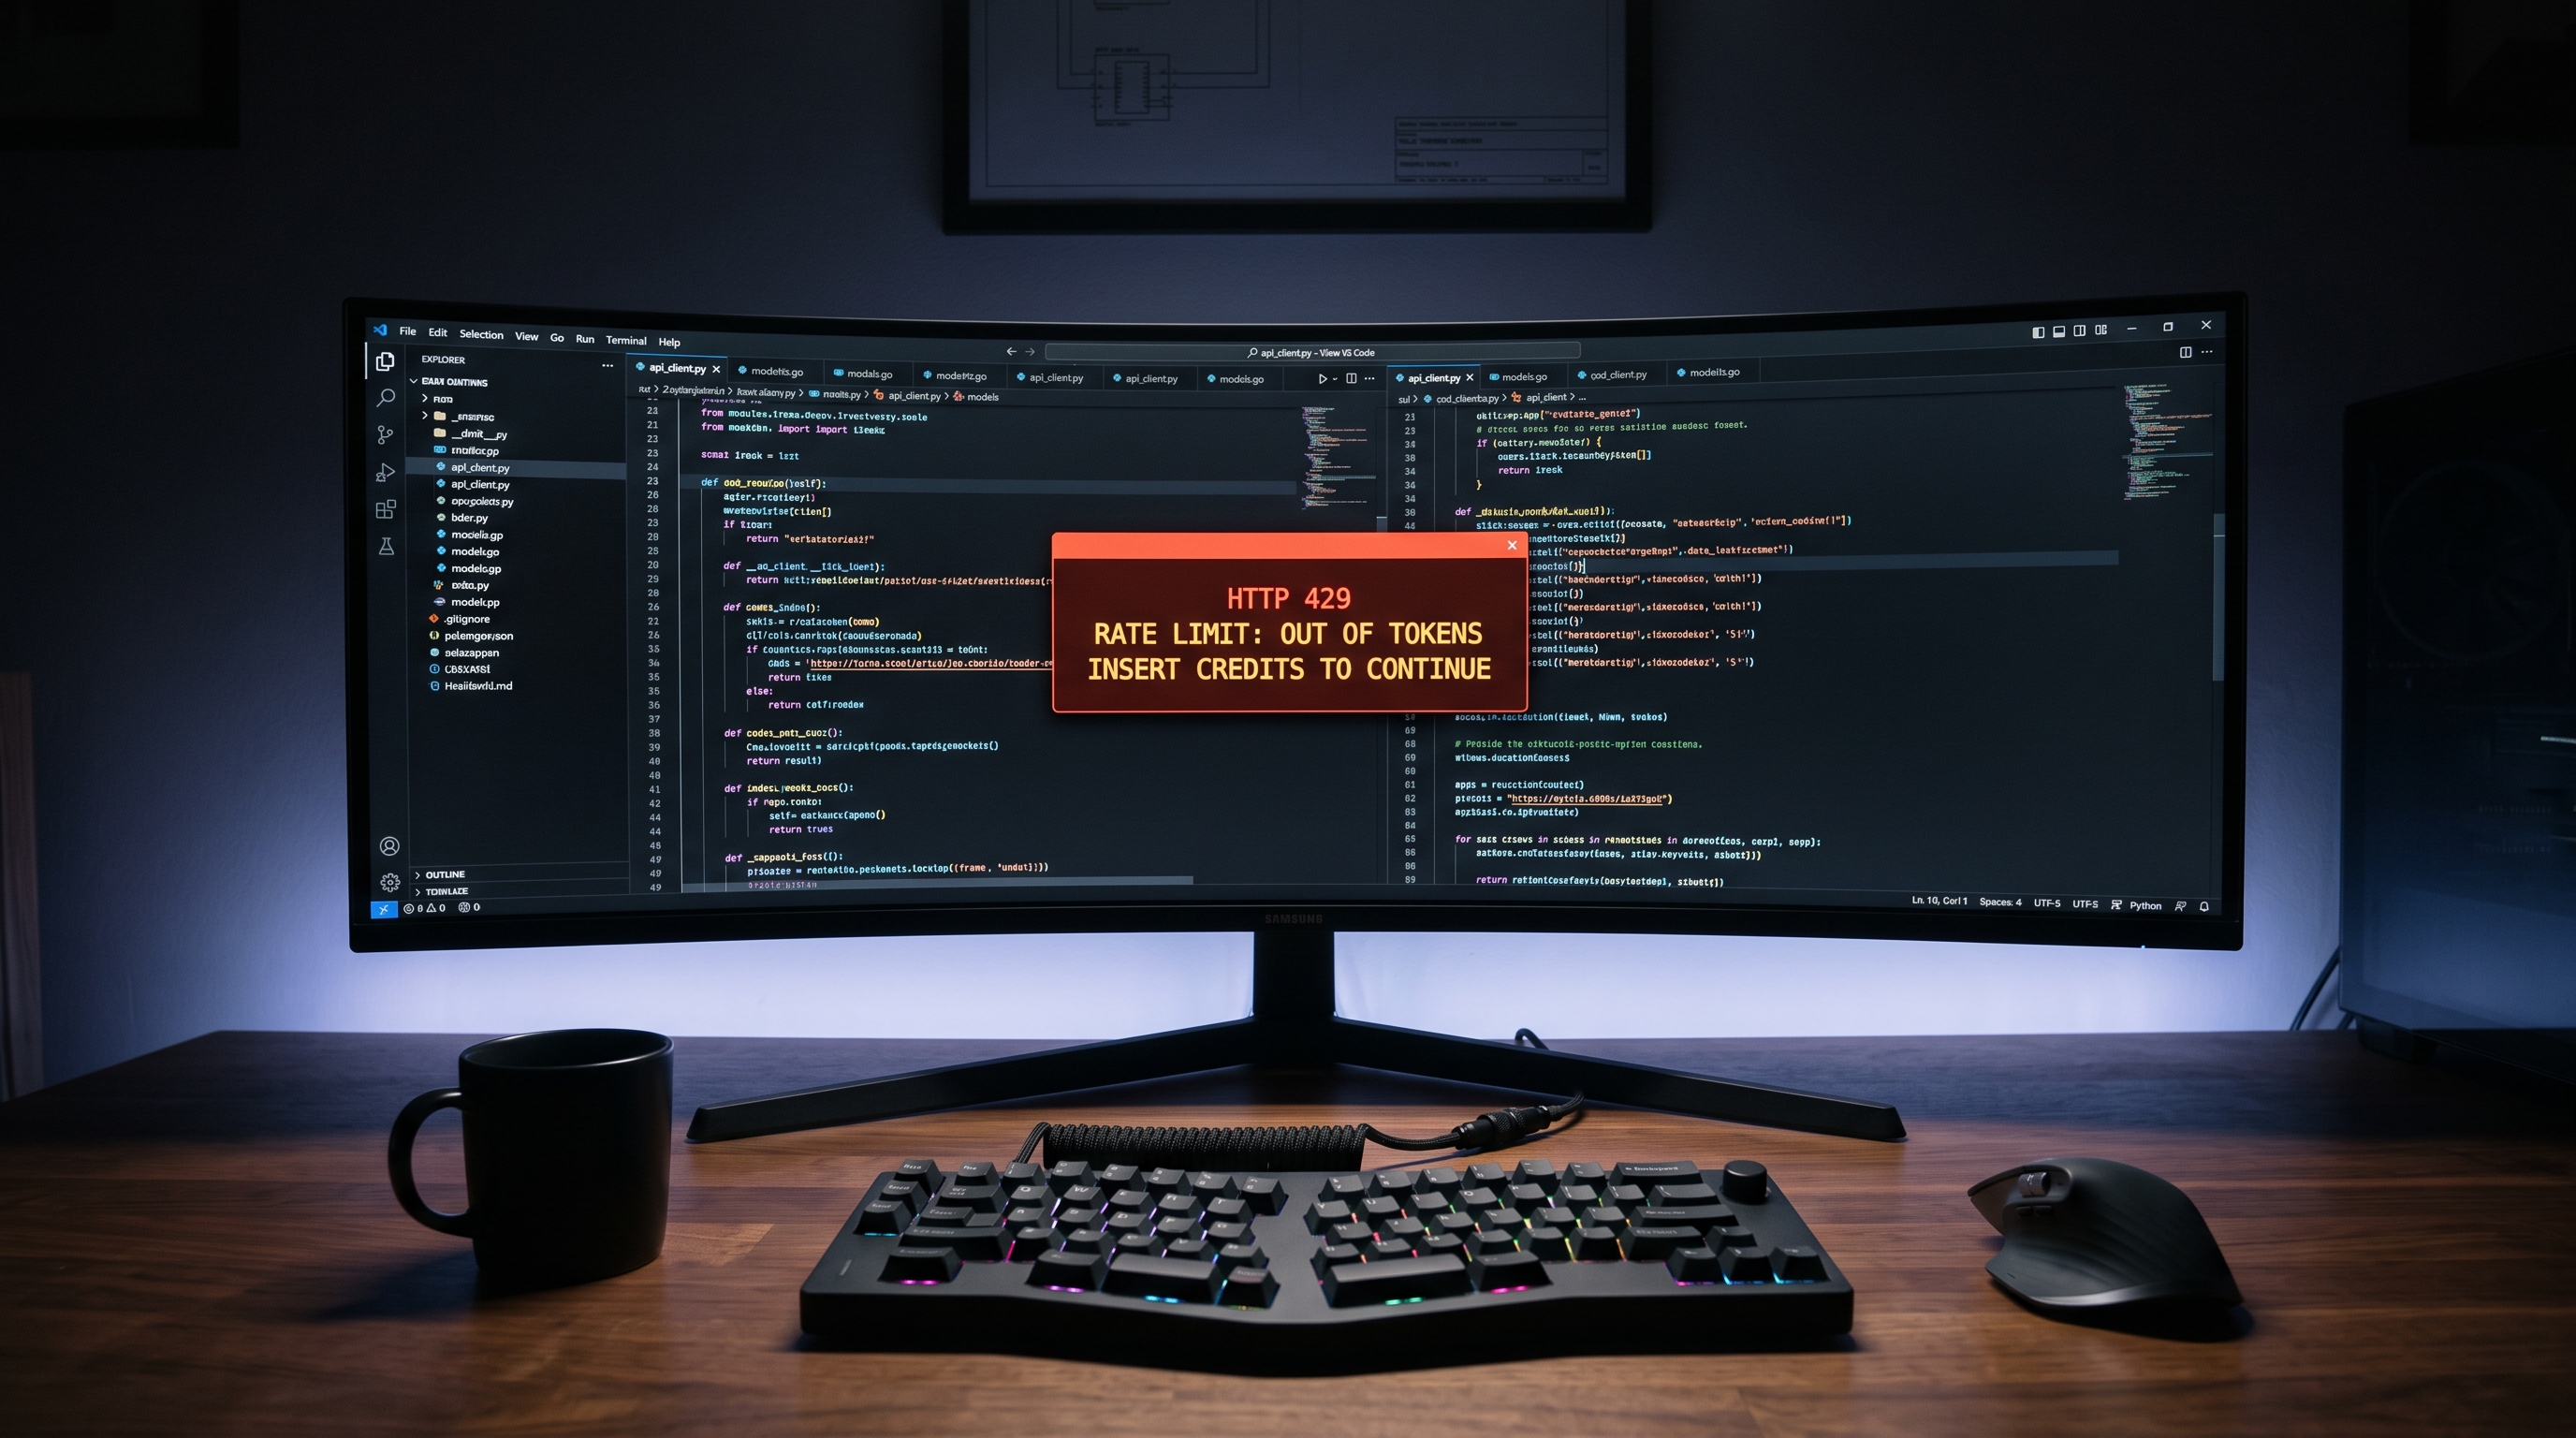
Depender de APIs públicas significa conviver com o risco do HTTP 429 Too Many Requests no pior momento possível: durante um incidente em produção ou na véspera de uma release crítica. Com infraestrutura dedicada, a vazão é sua e responde unicamente à demanda do seu time.
HTTP 429 na veia: quando a sua IDE vira um fliperama pedindo ficha para você continuar trabalhando.
A GPU Como Ativo de Produto (Dia e Noite)
A mesma instância provisionada para auxiliar os desenvolvedores durante o expediente não precisa ficar ociosa depois das 19h. Fora do horário comercial, ela pode absorver cargas assíncronas do próprio produto:
Pipelines de classificação de dados e enriquecimento textual.
Extração de entidades e matchmaking semântico.
Geração de embeddings para busca vetorial.
BI Privado e Text-to-SQL Seguro: Consultas analíticas automatizadas sobre réplicas de leitura internas sem expor métricas financeiras sensíveis ou dados de clientes (PII) para nuvens públicas.
Memória Corporativa com AnythingLLM: Backend de inferência para ferramentas de RAG corporativo (como o AnythingLLM), unificando a base documental da empresa de forma soberana, auditável e sem lock-in.
Uma capacidade computacional que entrou como ferramenta de trabalho passa a servir diretamente ao produto sem adicionar um único real na fatura.
7. Fundamentos Vencem o Hype
A ideia de que times de engenharia estão fadados a rodar com o taxímetro da IA para cada commit é muito conveniente pras Big Techs.
Só que o ecossistema de pesos abertos já passou da fase experimental faz tempo. Quantização FP8 funciona, engines de inferência têm vazão de sobra e subir uma GPU sob demanda é script de 10 minutos em qualquer provedor.
Ficar refém de API fechada virou decisão de quem prefere terceirizar a arquitetura e pagar a conta sem auditar. Na ponta da linha, a lição de engenharia é simples: preserve o controle da sua infraestrutura e nunca pague taxa por requisição pelo que você pode rodar como capacidade soberana dentro de casa.
Gostou da reflexão?
Como o seu time tem lidado com o consumo de tokens e o equilíbrio entre APIs e infraestrutura própria? Deixe seu comentário ou vamos trocar uma ideia:
Principal Engineer & Cloud Architect. Focado em arquitetura de software, IA agêntica, governança de código (SDD/Harness) e FinOps de inferência local. Menos hype, mais fundamentos e cicatrizes reais de produção.