<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" xml:lang="pt-br"><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://maiquelleonel.com.br/blog/feed.xml" rel="self" type="application/atom+xml" /><link href="https://maiquelleonel.com.br/blog/" rel="alternate" type="text/html" hreflang="pt-br" /><updated>2026-10-03T07:27:39+00:00</updated><id>https://maiquelleonel.com.br/blog/feed.xml</id><title type="html">Maiquel Leonel</title><subtitle>Ensaios sobre arquitetura de software, IA agêntica, FinOps e engenharia na prática.</subtitle><author><name>Maiquel Leonel</name></author><entry><title type="html">Jev: O Que É, Como Funciona e Por Que Você Não Precisa Dele</title><link href="https://maiquelleonel.com.br/blog/jev-o-que-e-como-funciona-e-por-que-voce-nao-precisa-dele/" rel="alternate" type="text/html" title="Jev: O Que É, Como Funciona e Por Que Você Não Precisa Dele" /><published>2026-10-02T00:00:00+00:00</published><updated>2026-10-02T00:00:00+00:00</updated><id>https://maiquelleonel.com.br/blog/jev-o-que-e-como-funciona-e-por-que-voce-nao-precisa-dele</id><content type="html" xml:base="https://maiquelleonel.com.br/blog/jev-o-que-e-como-funciona-e-por-que-voce-nao-precisa-dele/"><![CDATA[<p>Chamar um modelo de 400 bilhões de parâmetros como o Claude Opus ou o GPT-4o para responder se um comando no terminal pode apagar arquivos é como acionar uma usina nuclear para acender um fósforo. Você queima centenas de milissegundos de decodificação sequencial, torra centavos por requisição e introduz um ponto de falha bizarro em algo que deveria ser um simples <code class="language-plaintext highlighter-rouge">if/else</code>.</p>

<p>A TypeSafe AI levantou uma rodada barulhenta vendendo o <strong>Jev</strong> justamente em cima dessa dor: uma “IA que não gera texto”, focada em microdecisões rápidas e estruturadas em JSON.</p>

<p>O diagnóstico deles está certo. A solução vendida, nem tanto.</p>

<p>Não faz sentido pagar assinatura de API proprietária e aceitar 150ms de latência de rede para ter uma decisão booleana. A engenharia de passo único (<em>System 1</em>) — pegar um encoder leve como o <strong>ModernBERT</strong>, compilar em ONNX e rodar em 30ms na <strong>CPU</strong> local a custo <strong>zero</strong> de token — já está resolvida no ecossistema aberto com projetos como o <strong>Laya</strong>.</p>

<p>A questão real não é contratar outro SaaS de IA para a sua esteira agêntica, mas entender como desacoplar reflexos rápidos de raciocínio pesado na arquitetura do seu software.</p>

<hr />

<h2 id="1-o-paradigma-cognitivo-de-kahneman-aplicado-a-sistemas-agênticos">1. O Paradigma Cognitivo de Kahneman Aplicado a Sistemas Agênticos</h2>

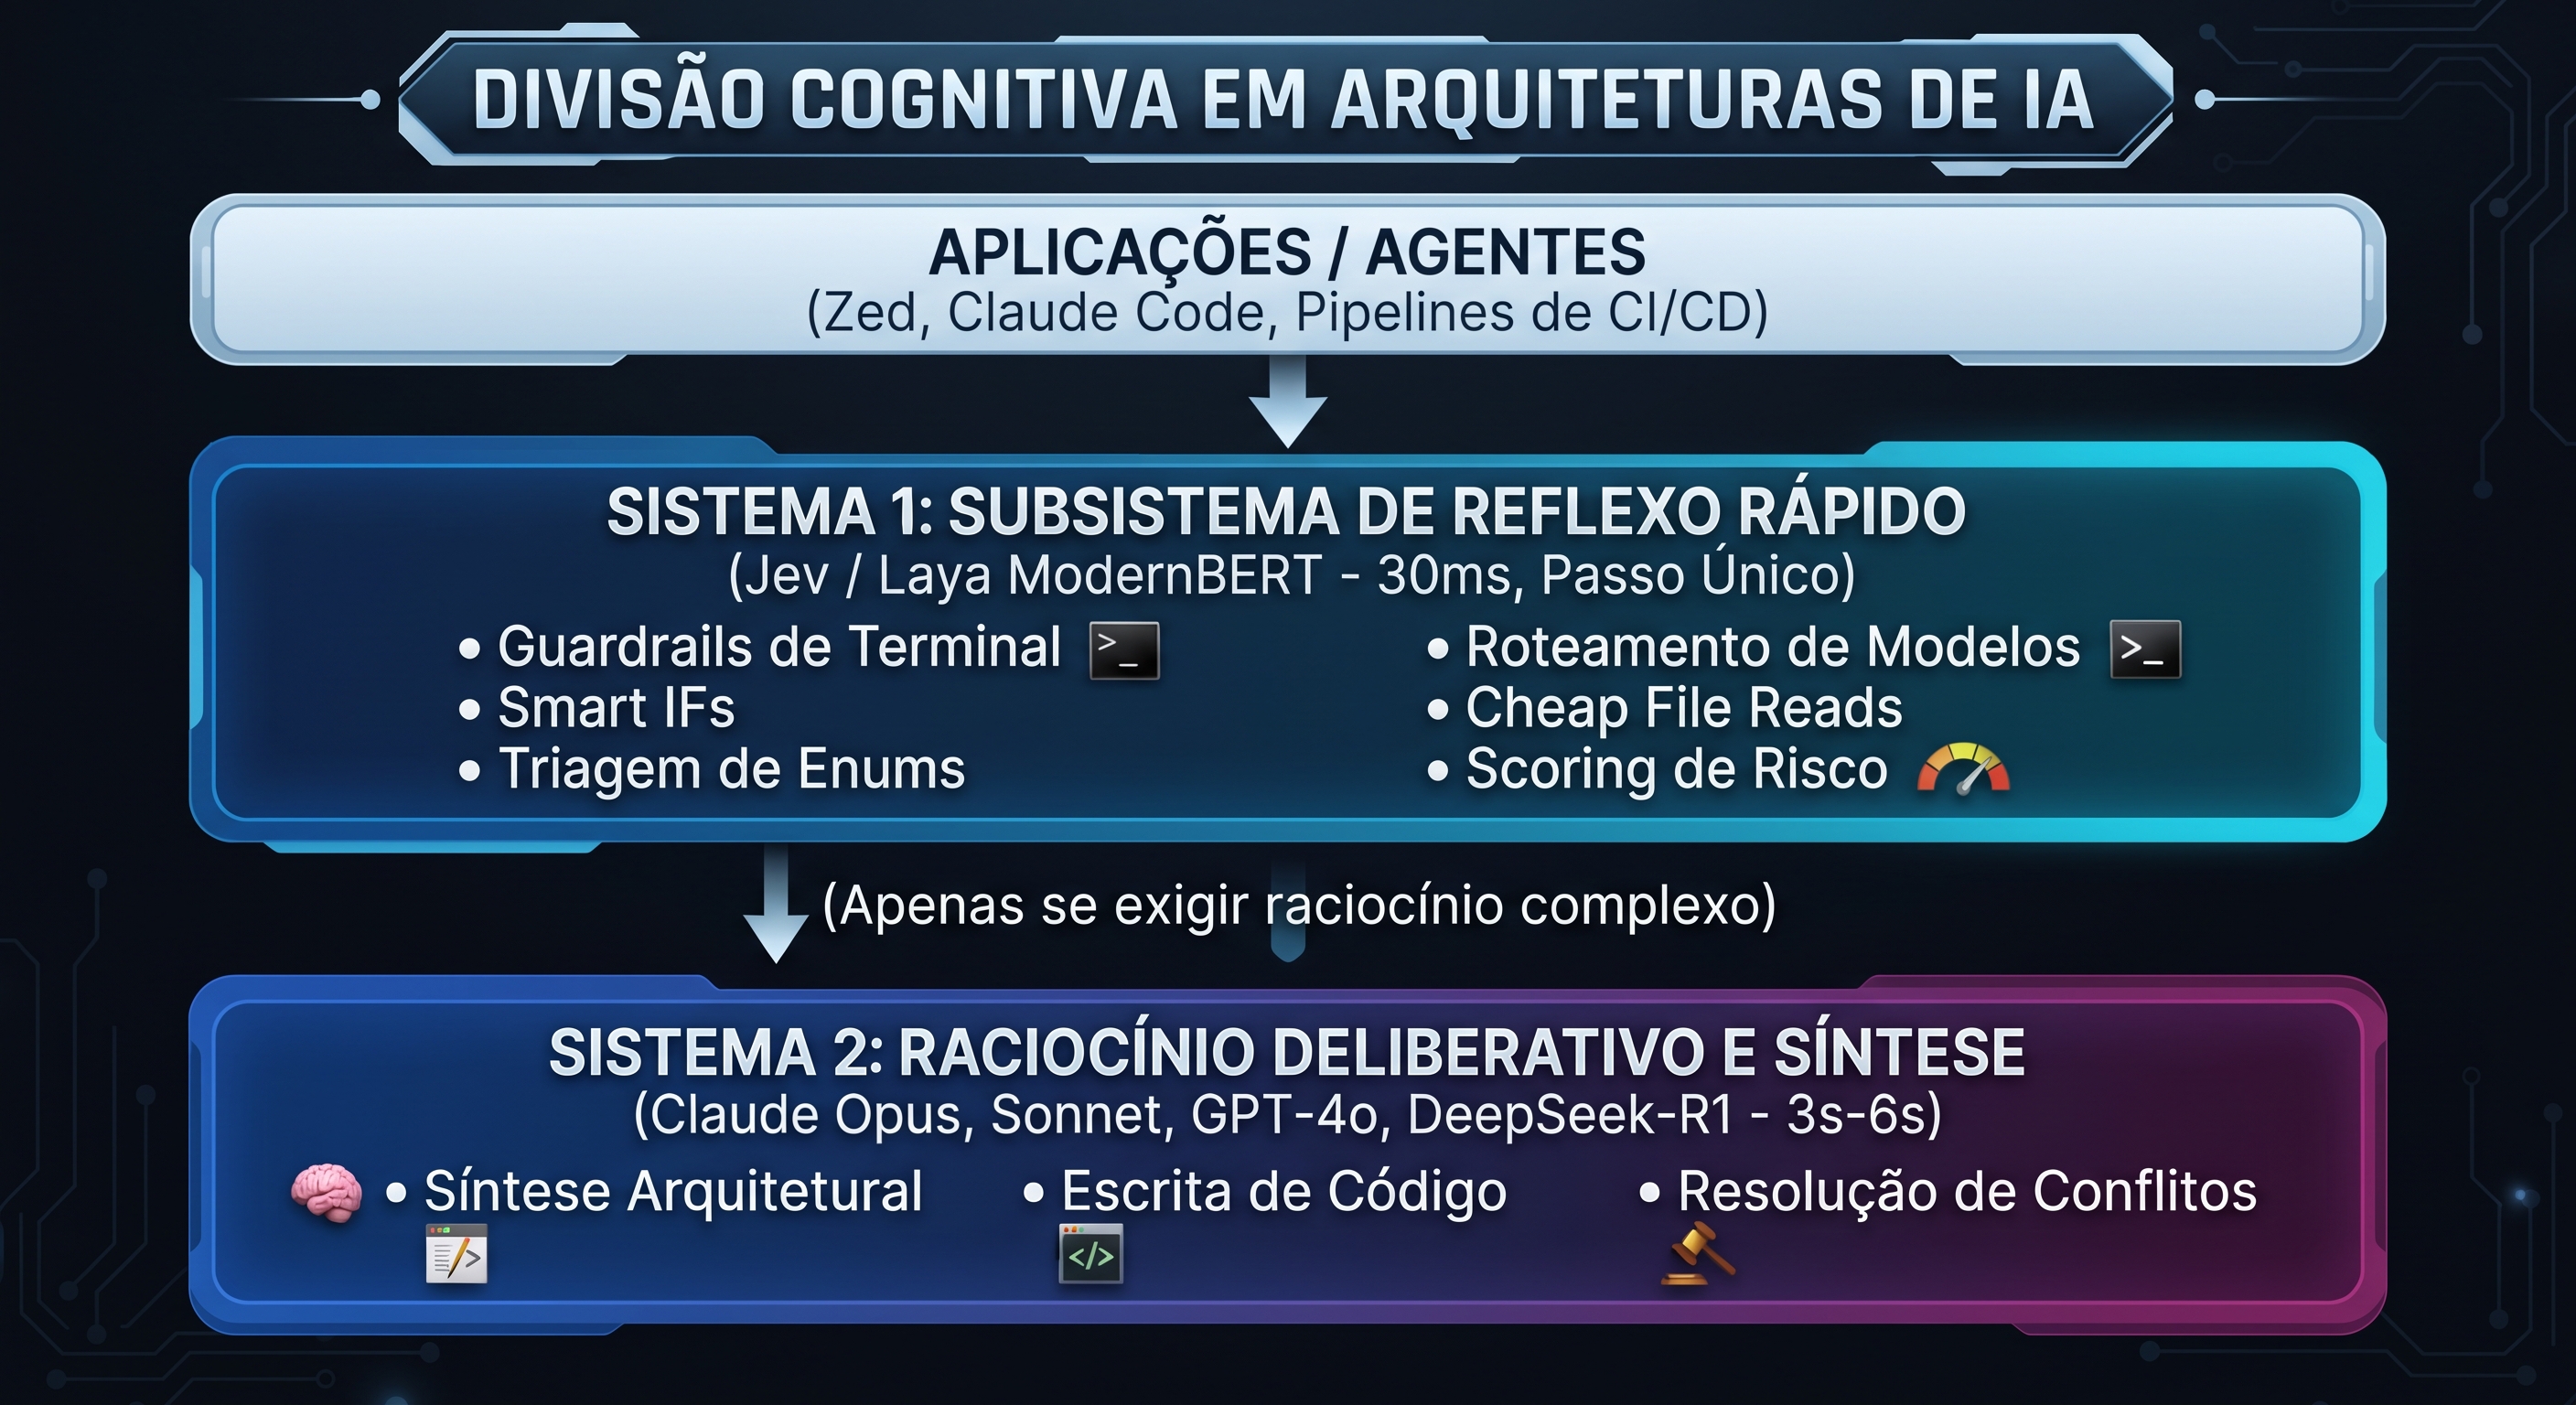
<p>A separação entre geração de texto e tomada de decisão apoia-se na psicologia cognitiva de Daniel Kahneman<sup id="fnref:1" role="doc-noteref"><a href="#fn:1" class="footnote" rel="footnote">1</a></sup>. Em <em>Rápido e Devagar</em> (<em>Thinking, Fast and Slow</em>), Kahneman estabeleceu a distinção entre dois modos de processamento mental:</p>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/div_cog_arq_ia.png" alt="O modelo mental de Daniel Kahneman aplicado à IA: Sistema 1 para reflexos rápidos de 30ms vs. Sistema 2 para raciocínio deliberativo." />
  
    <figcaption>O modelo mental de Daniel Kahneman aplicado à IA: Sistema 1 para reflexos rápidos de 30ms vs. Sistema 2 para raciocínio deliberativo.
</figcaption>
  
</figure>

<ul>
  <li><strong>Sistema 1 (Reflexo Imediato):</strong> Opera em milissegundos de forma automática, com custo computacional desprezível e reconhecimento direto de padrões. É o cérebro respondendo quanto é <code class="language-plaintext highlighter-rouge">2 + 2</code> ou desviando o pé de um obstáculo no chão.</li>
  <li><strong>Sistema 2 (Raciocínio Deliberativo):</strong> Opera de forma lenta e sequencial em segundos ou minutos, com alto custo computacional e foco contínuo. É o cérebro calculando de cabeça quanto é <code class="language-plaintext highlighter-rouge">17 × 43</code> ou planejando uma jogada complexa de xadrez.</li>
</ul>

<h3 id="a-tradução-para-a-arquitetura-de-software">A Tradução para a Arquitetura de Software</h3>

<p>Na engenharia de software tradicional, cometemos o erro de chamar um <strong>modelo de Sistema 2</strong> (como um LLM generativo pesado) para responder perguntas que são puramente de <strong>Sistema 1</strong>.</p>

<p>Quando o sistema precisa apenas verificar se um diff do Git contém credenciais expostas ou se um log do Sentry indica uma falha de conexão, ele não precisa de síntese poética, nem de abstrações elaboradas. Ele precisa de um <strong>reflexo computacional rápido</strong>: uma resposta tipada, com probabilidade calibrada, entregue em milissegundos.</p>

<p>A introdução de modelos <strong>System 1</strong> cria uma camada de controle determinística: um módulo que resolve as microdecisões na borda antes de invocar o LLM principal de Sistema 2.</p>

<hr />

<h2 id="2-a-mecânica-da-inferência-single-forward-pass-vs-geração-auto-regressiva">2. A Mecânica da Inferência: Single Forward Pass vs. Geração Auto-regressiva</h2>

<p>Para entender o ganho de eficiência, é necessário contrastar a física computacional dos dois tipos de rede.</p>

<h3 id="o-gargalo-auto-regressivo-on">O Gargalo Auto-regressivo ($O(N)$)</h3>
<p>Modelos como GPT-4o e Claude geram texto token por token. Para devolver um JSON com 50 tokens (ex.: <code class="language-plaintext highlighter-rouge">{"allowed": true, "why": "safe"}</code>), a GPU precisa executar <strong>50 passagens completas na rede de forma estritamente sequencial</strong>, acumulando latência a cada palavra e consumindo largura de banda no recálculo contínuo do KV-Cache.</p>

<h3 id="a-mecânica-de-passo-único-do-encoder">A Mecânica de Passo Único do Encoder</h3>
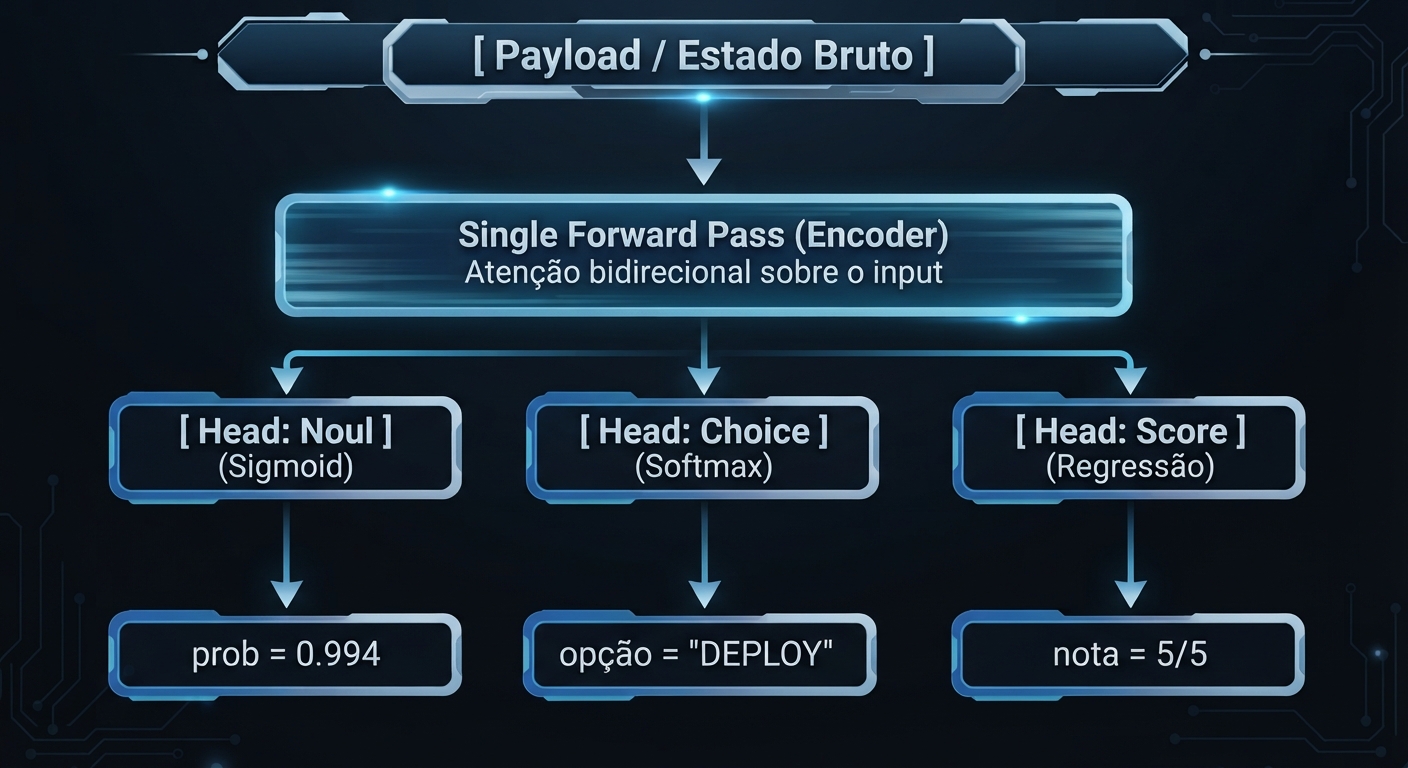
<p>Modelos System 1 baseiam-se em arquiteturas de <strong>Encoder</strong> (como ModernBERT). Eles executam a inferência em <strong>uma única passagem computacional (<em>Single Forward Pass</em>)</strong>:</p>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/mecanica_encoder.png" alt="Inferência em passo único (Single Forward Pass): projeção direta dos logits nas cabeças neurais (Sigmoid, Softmax e Regressão)." />
  
    <figcaption>Inferência em passo único (Single Forward Pass): projeção direta dos logits nas cabeças neurais (Sigmoid, Softmax e Regressão).
</figcaption>
  
</figure>

<ol>
  <li><strong>Latência Determinística (30ms a 70ms):</strong> Como a inferência não gera tokens em loop, o tempo de resposta é constante e ditado apenas pelo tamanho do payload e pela largura de banda da memória.</li>
  <li><strong>Tipagem Direta via Logits:</strong> O modelo não gera texto para ser parseado com <code class="language-plaintext highlighter-rouge">json.loads()</code>. Ele projeta os logits diretamente em funções de ativação matemática (<code class="language-plaintext highlighter-rouge">Sigmoid</code> para booleanos, <code class="language-plaintext highlighter-rouge">Softmax</code> para distribuições categóricas).</li>
  <li><strong>Speculative Fan-out:</strong> Como o embedding de estado é calculado em bloco, enviar 1 ou 30 perguntas sobre o mesmo texto em uma única requisição adiciona apenas multiplicações matriciais simples nas cabeças de saída (<em>heads</em>), com impacto praticamente nulo no tempo total.</li>
  <li><strong>Calibração de Confiança (<em>Confidence Score</em>):</strong> Cada retorno inclui uma probabilidade contínua real (ex.: <code class="language-plaintext highlighter-rouge">0.994</code>), permitindo criar travas lógicas baseadas em limiares matemáticos rigorosos.</li>
</ol>

<hr />

<h2 id="3-a-mecânica-do-jev-inteligência-programável-nativamente-via-json">3. A Mecânica do Jev: Inteligência Programável Nativamente via JSON</h2>

<p>A chave para entender o Jev (e os modelos de decisão em geral) é abandonar o modelo mental de “chatbot com prompt de sistema”.</p>

<p>O Jev <strong>não é um LLM que finge falar JSON</strong> através de instruções de sistema como <em>“responda estritamente em formato JSON sem markdown”</em>. Para engenheiros de software, é vital compreender a distinção entre duas abordagens que o mercado costuma confundir:</p>

<ul>
  <li><strong>Structured Outputs em LLMs (OpenAI, Outlines, Guidance):</strong> O modelo continua sendo um decodificador auto-regressivo que gera token por token, guiado por máscaras de gramática formal (CFG / Regex). A latência varia entre 2.000ms e 5.000ms porque a GPU precisa recalcular o KV-Cache sequencial para dezenas de tokens de sintaxe (<code class="language-plaintext highlighter-rouge">{</code>, <code class="language-plaintext highlighter-rouge">"</code>, <code class="language-plaintext highlighter-rouge">:</code>).</li>
  <li><strong>Modelos de Decisão System 1 (Jev, Laya):</strong> Zero geração de tokens. O transformer processa o embedding contextual do estado em passo único e projeta diretamente as distribuições nas cabeças neurais de classificação. A latência é constante entre 30ms e 70ms, executando multiplicação matricial direta sem manter estado de decodificação.</li>
</ul>

<figure>
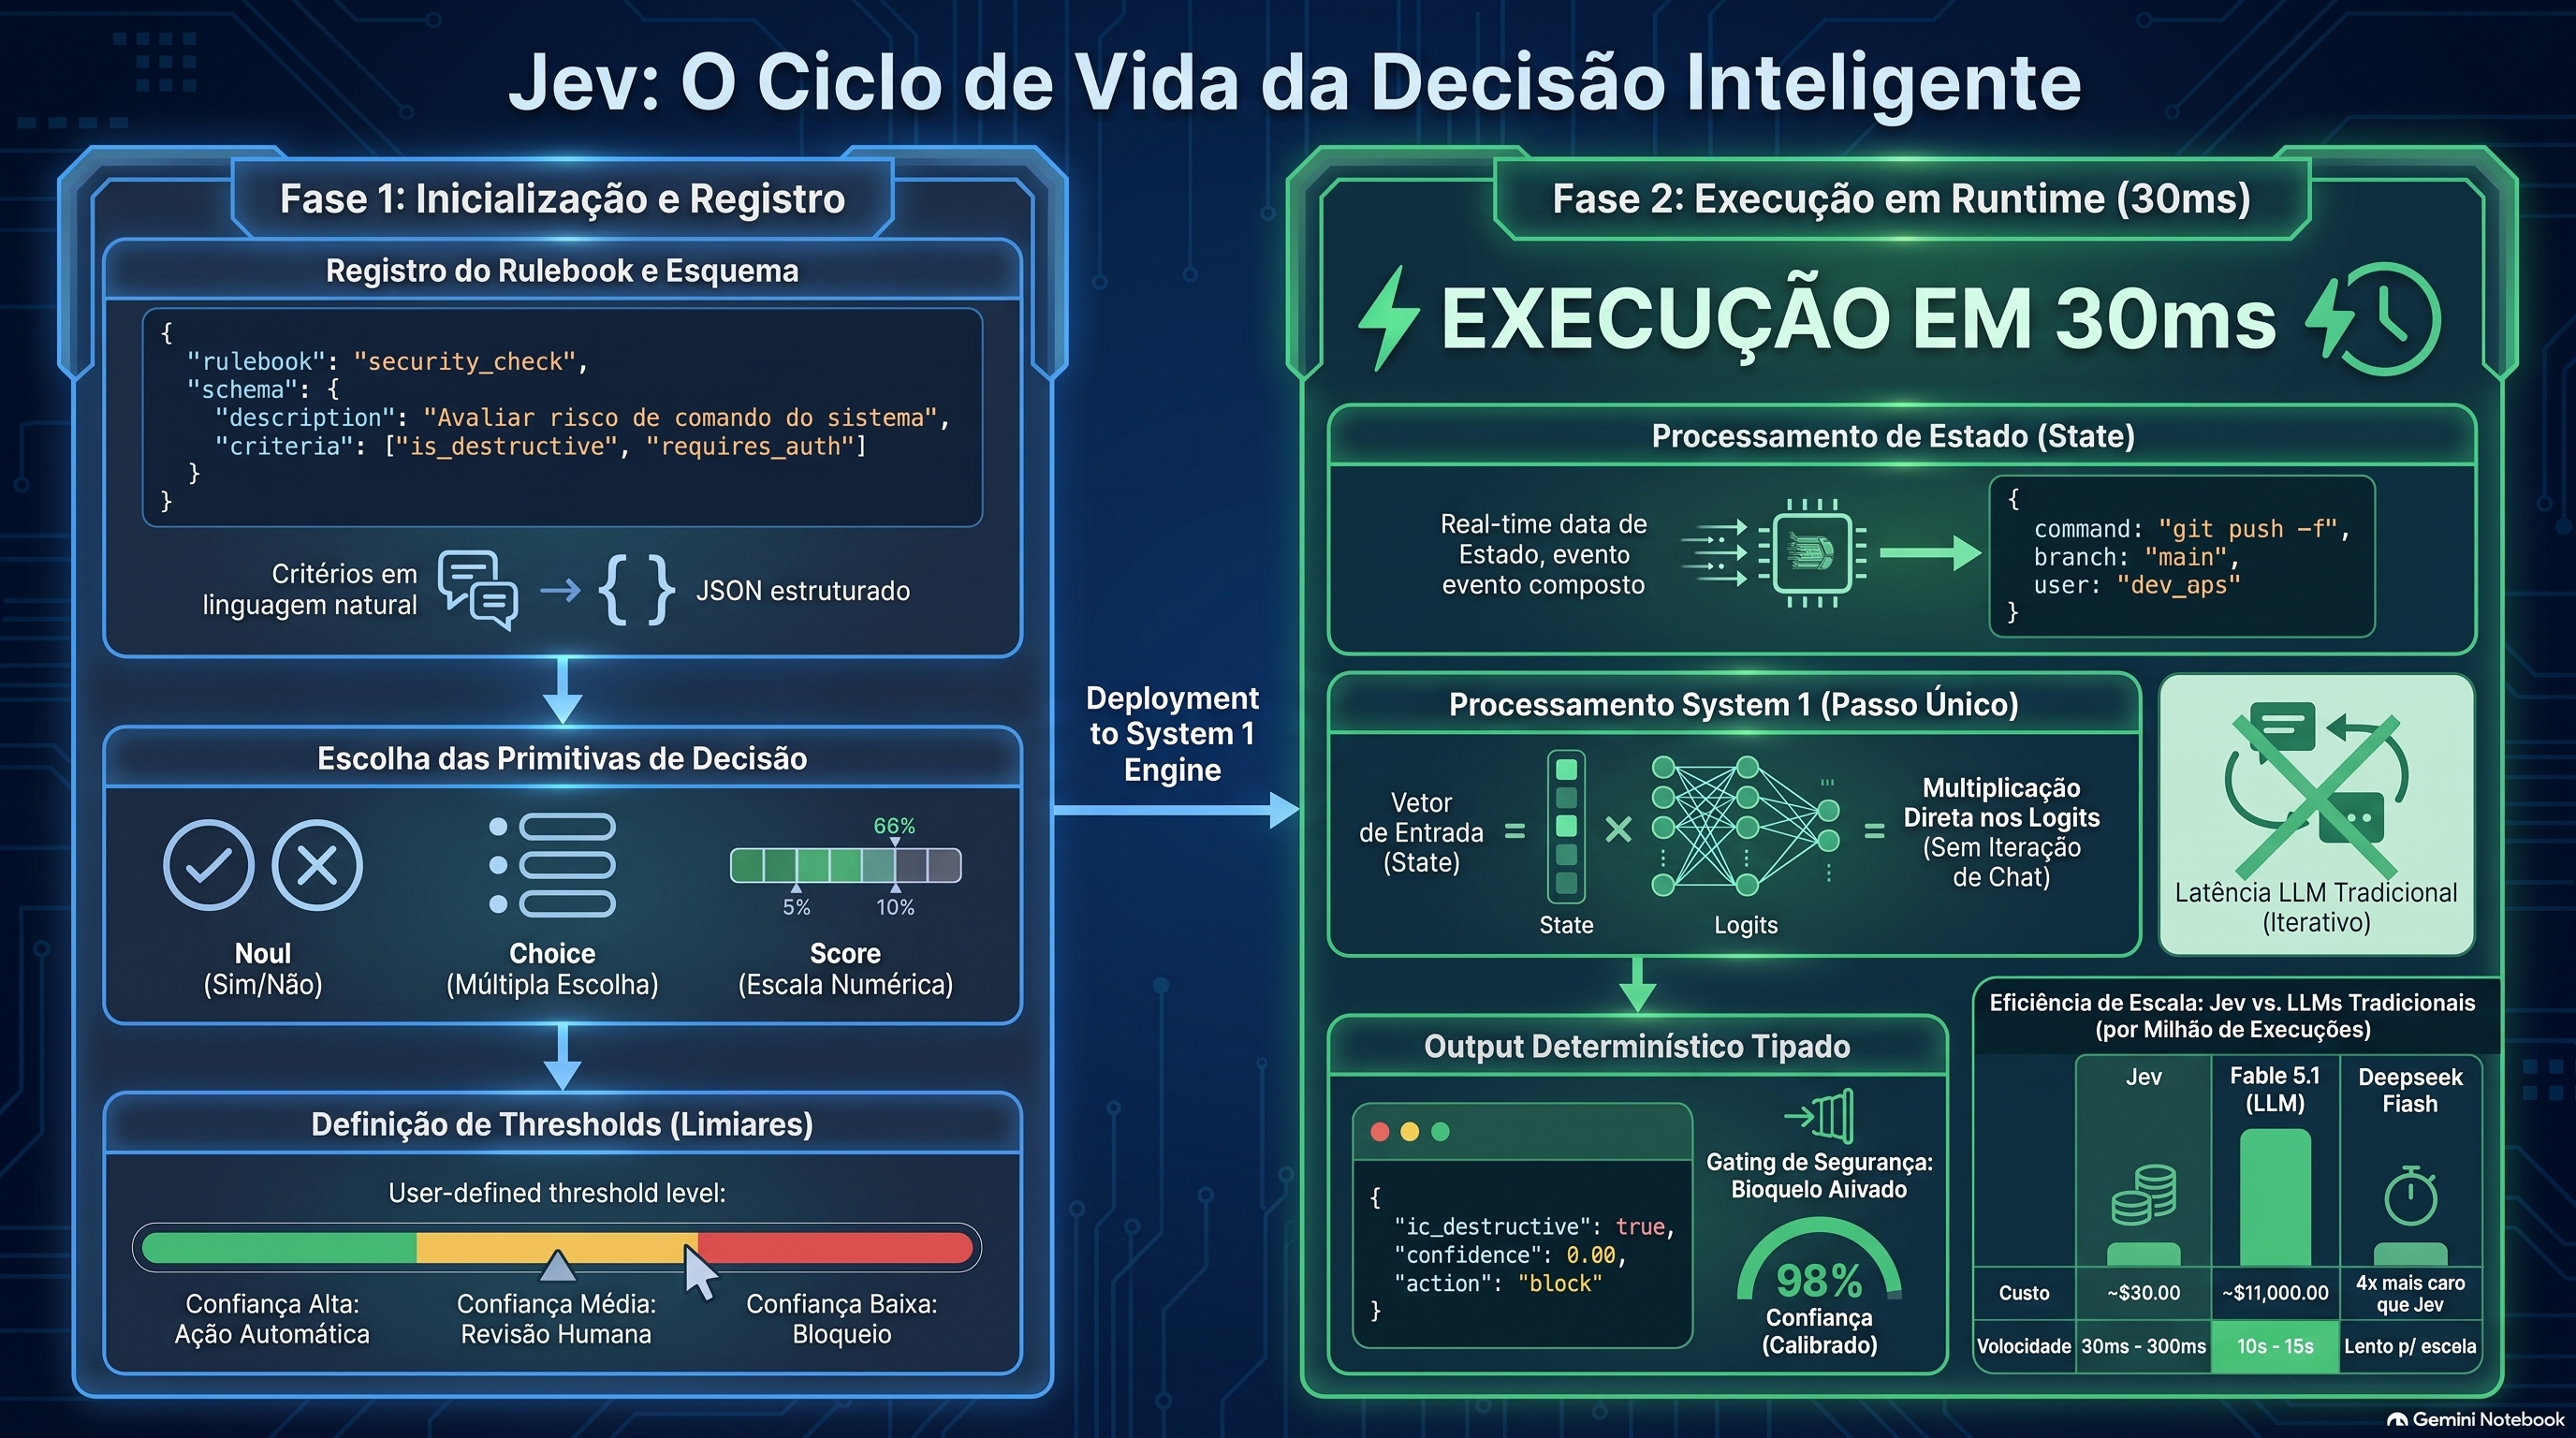
  <img src="https://maiquelleonel.com.br/blog/assets/images/lifecycle_system_1.png" alt="Ciclo de vida de um modelo de decisão: registro prévio do Rulebook (Fase 1) e avaliação multi-campo de alta velocidade em runtime (Fase 2)." />
  
    <figcaption>Ciclo de vida de um modelo de decisão: registro prévio do Rulebook (Fase 1) e avaliação multi-campo de alta velocidade em runtime (Fase 2).
</figcaption>
  
</figure>

<hr />
<h3 id="fase-1-a-injeção-prévia-do-esquema-de-decisão-rulebook-injection">Fase 1: A Injeção Prévia do Esquema de Decisão (<em>Rulebook Injection</em>)</h3>

<p>Antes de avaliar o primeiro comando, log ou arquivo, o sistema precisa <strong>injetar e registrar o contrato de avaliação</strong>. Em runtimes agênticos (como no Claude Code ou em middlewares customizados), essa especificação é registrada previamente como uma <strong>Skill</strong> ou <strong>Rulebook</strong> estático:</p>

<div class="language-json highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="p">{</span><span class="w">
  </span><span class="nl">"rulebook_id"</span><span class="p">:</span><span class="w"> </span><span class="s2">"git_terminal_guardrail"</span><span class="p">,</span><span class="w">
  </span><span class="nl">"description"</span><span class="p">:</span><span class="w"> </span><span class="s2">"Porta de segurança determinística para interceptação de comandos CLI"</span><span class="p">,</span><span class="w">
  </span><span class="nl">"evaluations"</span><span class="p">:</span><span class="w"> </span><span class="p">{</span><span class="w">
    </span><span class="nl">"is_destructive"</span><span class="p">:</span><span class="w"> </span><span class="p">{</span><span class="w"> 
      </span><span class="nl">"type"</span><span class="p">:</span><span class="w"> </span><span class="s2">"noul"</span><span class="p">,</span><span class="w">
      </span><span class="nl">"prompt"</span><span class="p">:</span><span class="w"> </span><span class="s2">"Considerando o comando e a branch alvo, a operação sobrescreve histórico ou deleta dados irreversivelmente?"</span><span class="p">,</span><span class="w">
      </span><span class="nl">"threshold"</span><span class="p">:</span><span class="w"> </span><span class="mf">0.98</span><span class="w">
    </span><span class="p">},</span><span class="w">
    </span><span class="nl">"operation_class"</span><span class="p">:</span><span class="w"> </span><span class="p">{</span><span class="w"> 
      </span><span class="nl">"type"</span><span class="p">:</span><span class="w"> </span><span class="s2">"choice"</span><span class="p">,</span><span class="w"> 
      </span><span class="nl">"options"</span><span class="p">:</span><span class="w"> </span><span class="p">[</span><span class="s2">"READ_ONLY"</span><span class="p">,</span><span class="w"> </span><span class="s2">"SAFE_WRITE"</span><span class="p">,</span><span class="w"> </span><span class="s2">"REMOTE_MUTATION"</span><span class="p">,</span><span class="w"> </span><span class="s2">"DESTRUCTIVE_ADMIN"</span><span class="p">],</span><span class="w">
      </span><span class="nl">"prompt"</span><span class="p">:</span><span class="w"> </span><span class="s2">"Qual é a categoria operacional da instrução informada?"</span><span class="w">
    </span><span class="p">},</span><span class="w">
    </span><span class="nl">"blast_radius"</span><span class="p">:</span><span class="w"> </span><span class="p">{</span><span class="w"> 
      </span><span class="nl">"type"</span><span class="p">:</span><span class="w"> </span><span class="s2">"score"</span><span class="p">,</span><span class="w"> 
      </span><span class="nl">"scale"</span><span class="p">:</span><span class="w"> </span><span class="p">[</span><span class="mi">1</span><span class="p">,</span><span class="w"> </span><span class="mi">2</span><span class="p">,</span><span class="w"> </span><span class="mi">3</span><span class="p">,</span><span class="w"> </span><span class="mi">4</span><span class="p">,</span><span class="w"> </span><span class="mi">5</span><span class="p">],</span><span class="w">
      </span><span class="nl">"prompt"</span><span class="p">:</span><span class="w"> </span><span class="s2">"Qual o raio de impacto da falha (1 = nulo / local; 5 = perda crítica de repositório)?"</span><span class="w">
    </span><span class="p">}</span><span class="w">
  </span><span class="p">}</span><span class="w">
</span><span class="p">}</span><span class="w">
</span></code></pre></div></div>

<p>Ao registrar o esquema previamente:</p>
<ol>
  <li><strong>As cabeças neurais são vinculadas estaticamente:</strong> O modelo sabe de antemão que precisará calcular um logit escalar booleano (<code class="language-plaintext highlighter-rouge">is_destructive</code>), uma distribuição multivariada de 4 classes (<code class="language-plaintext highlighter-rouge">operation_class</code>) e uma regressão ordinal de 1 a 5 (<code class="language-plaintext highlighter-rouge">blast_radius</code>).</li>
  <li><strong>Zero sobrecarga de contexto em runtime:</strong> Durante a execução, você não reenvia instruções textuais ou descrições de regras; você envia apenas o identificador da regra e os dados dinâmicos do evento.</li>
</ol>

<hr />

<h3 id="fase-2-o-state-multi-campo-e-a-execução-em-runtime">Fase 2: O State Multi-Campo e a Execução em Runtime</h3>

<p>Em produção, o estado de um sistema raramente se resume a uma string isolada. Modelos de decisão suportam <strong>State Multi-Campo (<em>Multi-Field Structured State</em>)</strong>:</p>

<div class="language-json highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="p">{</span><span class="w">
  </span><span class="nl">"rulebook_id"</span><span class="p">:</span><span class="w"> </span><span class="s2">"git_terminal_guardrail"</span><span class="p">,</span><span class="w">
  </span><span class="nl">"state"</span><span class="p">:</span><span class="w"> </span><span class="p">{</span><span class="w">
    </span><span class="nl">"command"</span><span class="p">:</span><span class="w"> </span><span class="s2">"git push --force origin main"</span><span class="p">,</span><span class="w">
    </span><span class="nl">"current_branch"</span><span class="p">:</span><span class="w"> </span><span class="s2">"main"</span><span class="p">,</span><span class="w">
    </span><span class="nl">"user_role"</span><span class="p">:</span><span class="w"> </span><span class="s2">"junior_developer"</span><span class="p">,</span><span class="w">
    </span><span class="nl">"environment"</span><span class="p">:</span><span class="w"> </span><span class="s2">"PRODUCTION"</span><span class="w">
  </span><span class="p">}</span><span class="w">
</span><span class="p">}</span><span class="w">
</span></code></pre></div></div>

<p>O encoder processa a atenção cruzada entre todos os campos do estado simultaneamente no mesmo <em>forward pass</em>. Isso permite que o critério avalie condições complexas (ex.: um <code class="language-plaintext highlighter-rouge">git push --force</code> em branch de <em>feature</em> pode ser classificado como seguro, mas em <code class="language-plaintext highlighter-rouge">main</code> sob ambiente <code class="language-plaintext highlighter-rouge">PRODUCTION</code> atinge o teto máximo de severidade).</p>

<h3 id="a-saída-tipada-e-as-três-primitivas-matemáticas">A Saída Tipada e as Três Primitivas Matemáticas</h3>

<p>Na análise prática apresentada por Simon Scrapes<sup id="fnref:3" role="doc-noteref"><a href="#fn:3" class="footnote" rel="footnote">2</a></sup>, o retorno da inferência não é um texto corrido que exige parsers defensivos, mas uma estrutura numérica calibrada baseada em três primitivas fundamentais:</p>

<div class="language-json highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="p">{</span><span class="w">
  </span><span class="nl">"is_destructive"</span><span class="p">:</span><span class="w"> </span><span class="p">{</span><span class="w"> 
    </span><span class="nl">"value"</span><span class="p">:</span><span class="w"> </span><span class="kc">true</span><span class="p">,</span><span class="w"> 
    </span><span class="nl">"confidence"</span><span class="p">:</span><span class="w"> </span><span class="mf">0.994</span><span class="w"> 
  </span><span class="p">},</span><span class="w">
  </span><span class="nl">"operation_class"</span><span class="p">:</span><span class="w"> </span><span class="p">{</span><span class="w"> 
    </span><span class="nl">"value"</span><span class="p">:</span><span class="w"> </span><span class="s2">"REMOTE_MUTATION"</span><span class="p">,</span><span class="w"> 
    </span><span class="nl">"confidence"</span><span class="p">:</span><span class="w"> </span><span class="mf">0.962</span><span class="p">,</span><span class="w">
    </span><span class="nl">"distribution"</span><span class="p">:</span><span class="w"> </span><span class="p">{</span><span class="w">
      </span><span class="nl">"READ_ONLY"</span><span class="p">:</span><span class="w"> </span><span class="mf">0.001</span><span class="p">,</span><span class="w">
      </span><span class="nl">"SAFE_WRITE"</span><span class="p">:</span><span class="w"> </span><span class="mf">0.005</span><span class="p">,</span><span class="w">
      </span><span class="nl">"REMOTE_MUTATION"</span><span class="p">:</span><span class="w"> </span><span class="mf">0.962</span><span class="p">,</span><span class="w">
      </span><span class="nl">"DESTRUCTIVE_ADMIN"</span><span class="p">:</span><span class="w"> </span><span class="mf">0.032</span><span class="w">
    </span><span class="p">}</span><span class="w">
  </span><span class="p">},</span><span class="w">
  </span><span class="nl">"blast_radius"</span><span class="p">:</span><span class="w"> </span><span class="p">{</span><span class="w"> 
    </span><span class="nl">"value"</span><span class="p">:</span><span class="w"> </span><span class="mi">5</span><span class="p">,</span><span class="w"> 
    </span><span class="nl">"confidence"</span><span class="p">:</span><span class="w"> </span><span class="mf">0.971</span><span class="w"> 
  </span><span class="p">}</span><span class="w">
</span><span class="p">}</span><span class="w">
</span></code></pre></div></div>

<ul>
  <li><strong><code class="language-plaintext highlighter-rouge">Noul</code> (Booleano / Sim-Não):</strong> Projeta a ativação via Sigmoid ($\sigma(z) = \frac{1}{1 + e^{-z}}$), retornando a probabilidade estatística contínua entre <code class="language-plaintext highlighter-rouge">0.0</code> e <code class="language-plaintext highlighter-rouge">1.0</code>.</li>
  <li><strong><code class="language-plaintext highlighter-rouge">Choice</code> (Classificação Categórica):</strong> Aplica Softmax ($\text{Softmax}(z_i) = \frac{e^{z_i}}{\sum e^{z_j}}$) sobre as opções fornecidas, garantindo que a soma de todas as probabilidades seja exatamente <code class="language-plaintext highlighter-rouge">1.0</code> e expondo a distribuição completa de probabilidades.</li>
  <li><strong><code class="language-plaintext highlighter-rouge">Score</code> (Rubrica Ordinal Ponderada):</strong> Aplica regressão linear sobre uma escala finita de pesos inteiros previamente calibrados.</li>
</ul>

<h3 id="o-papel-matemático-do-confidence-score">O Papel Matemático do <em>Confidence Score</em></h3>

<p>O <strong>Confidence Score</strong> não é um número estético gerado aleatoriamente; ele reflete a margem matemática entre o logit da classe vencedora e as demais alternativas na distribuição de ativação da rede.</p>

<p>Isso viabiliza a construção de middlewares com controle determinístico de fluxo no código:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="nn">enum</span> <span class="kn">import</span> <span class="n">Enum</span>
<span class="kn">import</span> <span class="nn">logging</span>
<span class="kn">from</span> <span class="nn">pydantic</span> <span class="kn">import</span> <span class="n">BaseModel</span><span class="p">,</span> <span class="n">Field</span>

<span class="n">logger</span> <span class="o">=</span> <span class="n">logging</span><span class="p">.</span><span class="n">getLogger</span><span class="p">(</span><span class="n">__name__</span><span class="p">)</span>

<span class="k">class</span> <span class="nc">OperationClass</span><span class="p">(</span><span class="nb">str</span><span class="p">,</span> <span class="n">Enum</span><span class="p">):</span>
    <span class="n">READ_ONLY</span> <span class="o">=</span> <span class="s">"READ_ONLY"</span>
    <span class="n">SAFE_WRITE</span> <span class="o">=</span> <span class="s">"SAFE_WRITE"</span>
    <span class="n">REMOTE_MUTATION</span> <span class="o">=</span> <span class="s">"REMOTE_MUTATION"</span>
    <span class="n">DESTRUCTIVE_ADMIN</span> <span class="o">=</span> <span class="s">"DESTRUCTIVE_ADMIN"</span>

<span class="k">class</span> <span class="nc">ExecutionStatus</span><span class="p">(</span><span class="nb">str</span><span class="p">,</span> <span class="n">Enum</span><span class="p">):</span>
    <span class="n">ALLOWED</span> <span class="o">=</span> <span class="s">"ALLOWED"</span>
    <span class="n">BLOCKED_HUMAN_IN_THE_LOOP</span> <span class="o">=</span> <span class="s">"BLOCKED_HUMAN_IN_THE_LOOP"</span>
    <span class="n">DELEGATED_SYSTEM_2</span> <span class="o">=</span> <span class="s">"DELEGATED_SYSTEM_2"</span>

<span class="k">class</span> <span class="nc">NoulResult</span><span class="p">(</span><span class="n">BaseModel</span><span class="p">):</span>
    <span class="n">value</span><span class="p">:</span> <span class="nb">bool</span>
    <span class="n">confidence</span><span class="p">:</span> <span class="nb">float</span>

<span class="k">class</span> <span class="nc">ChoiceResult</span><span class="p">(</span><span class="n">BaseModel</span><span class="p">):</span>
    <span class="n">value</span><span class="p">:</span> <span class="n">OperationClass</span>
    <span class="n">confidence</span><span class="p">:</span> <span class="nb">float</span>
    <span class="n">distribution</span><span class="p">:</span> <span class="nb">dict</span><span class="p">[</span><span class="n">OperationClass</span><span class="p">,</span> <span class="nb">float</span><span class="p">]</span>

<span class="k">class</span> <span class="nc">ScoreResult</span><span class="p">(</span><span class="n">BaseModel</span><span class="p">):</span>
    <span class="n">value</span><span class="p">:</span> <span class="nb">int</span> <span class="o">=</span> <span class="n">Field</span><span class="p">(</span><span class="n">ge</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">le</span><span class="o">=</span><span class="mi">5</span><span class="p">)</span>
    <span class="n">confidence</span><span class="p">:</span> <span class="nb">float</span>

<span class="k">class</span> <span class="nc">GuardrailDecision</span><span class="p">(</span><span class="n">BaseModel</span><span class="p">):</span>
    <span class="n">is_destructive</span><span class="p">:</span> <span class="n">NoulResult</span>
    <span class="n">operation_class</span><span class="p">:</span> <span class="n">ChoiceResult</span>
    <span class="n">blast_radius</span><span class="p">:</span> <span class="n">ScoreResult</span>

<span class="k">def</span> <span class="nf">evaluate_command_execution</span><span class="p">(</span>
    <span class="n">command</span><span class="p">:</span> <span class="nb">str</span><span class="p">,</span> 
    <span class="n">target_branch</span><span class="p">:</span> <span class="nb">str</span><span class="p">,</span> 
    <span class="n">user_role</span><span class="p">:</span> <span class="nb">str</span>
<span class="p">)</span> <span class="o">-&gt;</span> <span class="n">ExecutionStatus</span><span class="p">:</span>
    <span class="c1"># Single-pass evaluation via System 1 Decision Model (~30ms)
</span>    <span class="n">raw_response</span> <span class="o">=</span> <span class="n">decision_engine</span><span class="p">.</span><span class="n">evaluate</span><span class="p">(</span>
        <span class="n">rulebook_id</span><span class="o">=</span><span class="s">"git_terminal_guardrail"</span><span class="p">,</span>
        <span class="n">state</span><span class="o">=</span><span class="p">{</span>
            <span class="s">"command"</span><span class="p">:</span> <span class="n">command</span><span class="p">,</span>
            <span class="s">"current_branch"</span><span class="p">:</span> <span class="n">target_branch</span><span class="p">,</span>
            <span class="s">"user_role"</span><span class="p">:</span> <span class="n">user_role</span>
        <span class="p">}</span>
    <span class="p">)</span>
    <span class="n">decision</span> <span class="o">=</span> <span class="n">GuardrailDecision</span><span class="p">.</span><span class="n">model_validate</span><span class="p">(</span><span class="n">raw_response</span><span class="p">)</span>
    
    <span class="c1"># 1. Fast-path: safe operations bypass further checks
</span>    <span class="k">if</span> <span class="n">decision</span><span class="p">.</span><span class="n">operation_class</span><span class="p">.</span><span class="n">value</span> <span class="ow">in</span> <span class="p">(</span><span class="n">OperationClass</span><span class="p">.</span><span class="n">READ_ONLY</span><span class="p">,</span> <span class="n">OperationClass</span><span class="p">.</span><span class="n">SAFE_WRITE</span><span class="p">):</span>
        <span class="k">return</span> <span class="n">ExecutionStatus</span><span class="p">.</span><span class="n">ALLOWED</span>

    <span class="c1"># 2. Strict confidence gating on destructive admin commands or high blast radius
</span>    <span class="k">if</span> <span class="p">(</span>
        <span class="n">decision</span><span class="p">.</span><span class="n">is_destructive</span><span class="p">.</span><span class="n">value</span>
        <span class="ow">and</span> <span class="n">decision</span><span class="p">.</span><span class="n">is_destructive</span><span class="p">.</span><span class="n">confidence</span> <span class="o">&gt;=</span> <span class="mf">0.98</span>
        <span class="ow">and</span> <span class="p">(</span>
            <span class="n">decision</span><span class="p">.</span><span class="n">operation_class</span><span class="p">.</span><span class="n">value</span> <span class="o">==</span> <span class="n">OperationClass</span><span class="p">.</span><span class="n">DESTRUCTIVE_ADMIN</span>
            <span class="ow">or</span> <span class="n">decision</span><span class="p">.</span><span class="n">blast_radius</span><span class="p">.</span><span class="n">value</span> <span class="o">&gt;=</span> <span class="mi">4</span>
        <span class="p">)</span>
    <span class="p">):</span>
        <span class="n">logger</span><span class="p">.</span><span class="n">critical</span><span class="p">(</span>
            <span class="sa">f</span><span class="s">"Blocked [</span><span class="si">{</span><span class="n">decision</span><span class="p">.</span><span class="n">operation_class</span><span class="p">.</span><span class="n">value</span><span class="si">}</span><span class="s">] with blast radius "</span>
            <span class="sa">f</span><span class="s">"(</span><span class="si">{</span><span class="n">decision</span><span class="p">.</span><span class="n">blast_radius</span><span class="p">.</span><span class="n">value</span><span class="si">}</span><span class="s">/5): </span><span class="si">{</span><span class="n">command</span><span class="si">}</span><span class="s">"</span>
        <span class="p">)</span>
        <span class="k">return</span> <span class="n">ExecutionStatus</span><span class="p">.</span><span class="n">BLOCKED_HUMAN_IN_THE_LOOP</span>
        
    <span class="c1"># 3. Ambiguity handling (gray-zone fallback to System 2)
</span>    <span class="k">if</span> <span class="n">decision</span><span class="p">.</span><span class="n">is_destructive</span><span class="p">.</span><span class="n">confidence</span> <span class="o">&lt;</span> <span class="mf">0.70</span><span class="p">:</span>
        <span class="n">logger</span><span class="p">.</span><span class="n">info</span><span class="p">(</span>
            <span class="sa">f</span><span class="s">"Low confidence (</span><span class="si">{</span><span class="n">decision</span><span class="p">.</span><span class="n">is_destructive</span><span class="p">.</span><span class="n">confidence</span><span class="si">:</span><span class="p">.</span><span class="mi">2</span><span class="n">f</span><span class="si">}</span><span class="s">). "</span>
            <span class="sa">f</span><span class="s">"Delegating [</span><span class="si">{</span><span class="n">decision</span><span class="p">.</span><span class="n">operation_class</span><span class="p">.</span><span class="n">value</span><span class="si">}</span><span class="s">] to System 2."</span>
        <span class="p">)</span>
        <span class="k">return</span> <span class="n">ExecutionStatus</span><span class="p">.</span><span class="n">DELEGATED_SYSTEM_2</span>
        
    <span class="k">return</span> <span class="n">ExecutionStatus</span><span class="p">.</span><span class="n">ALLOWED</span>
</code></pre></div></div>

<hr />

<h2 id="4-os-10-padrões-arquiteturais-de-decisão-na-engenharia-agêntica">4. Os 10 Padrões Arquiteturais de Decisão na Engenharia Agêntica</h2>

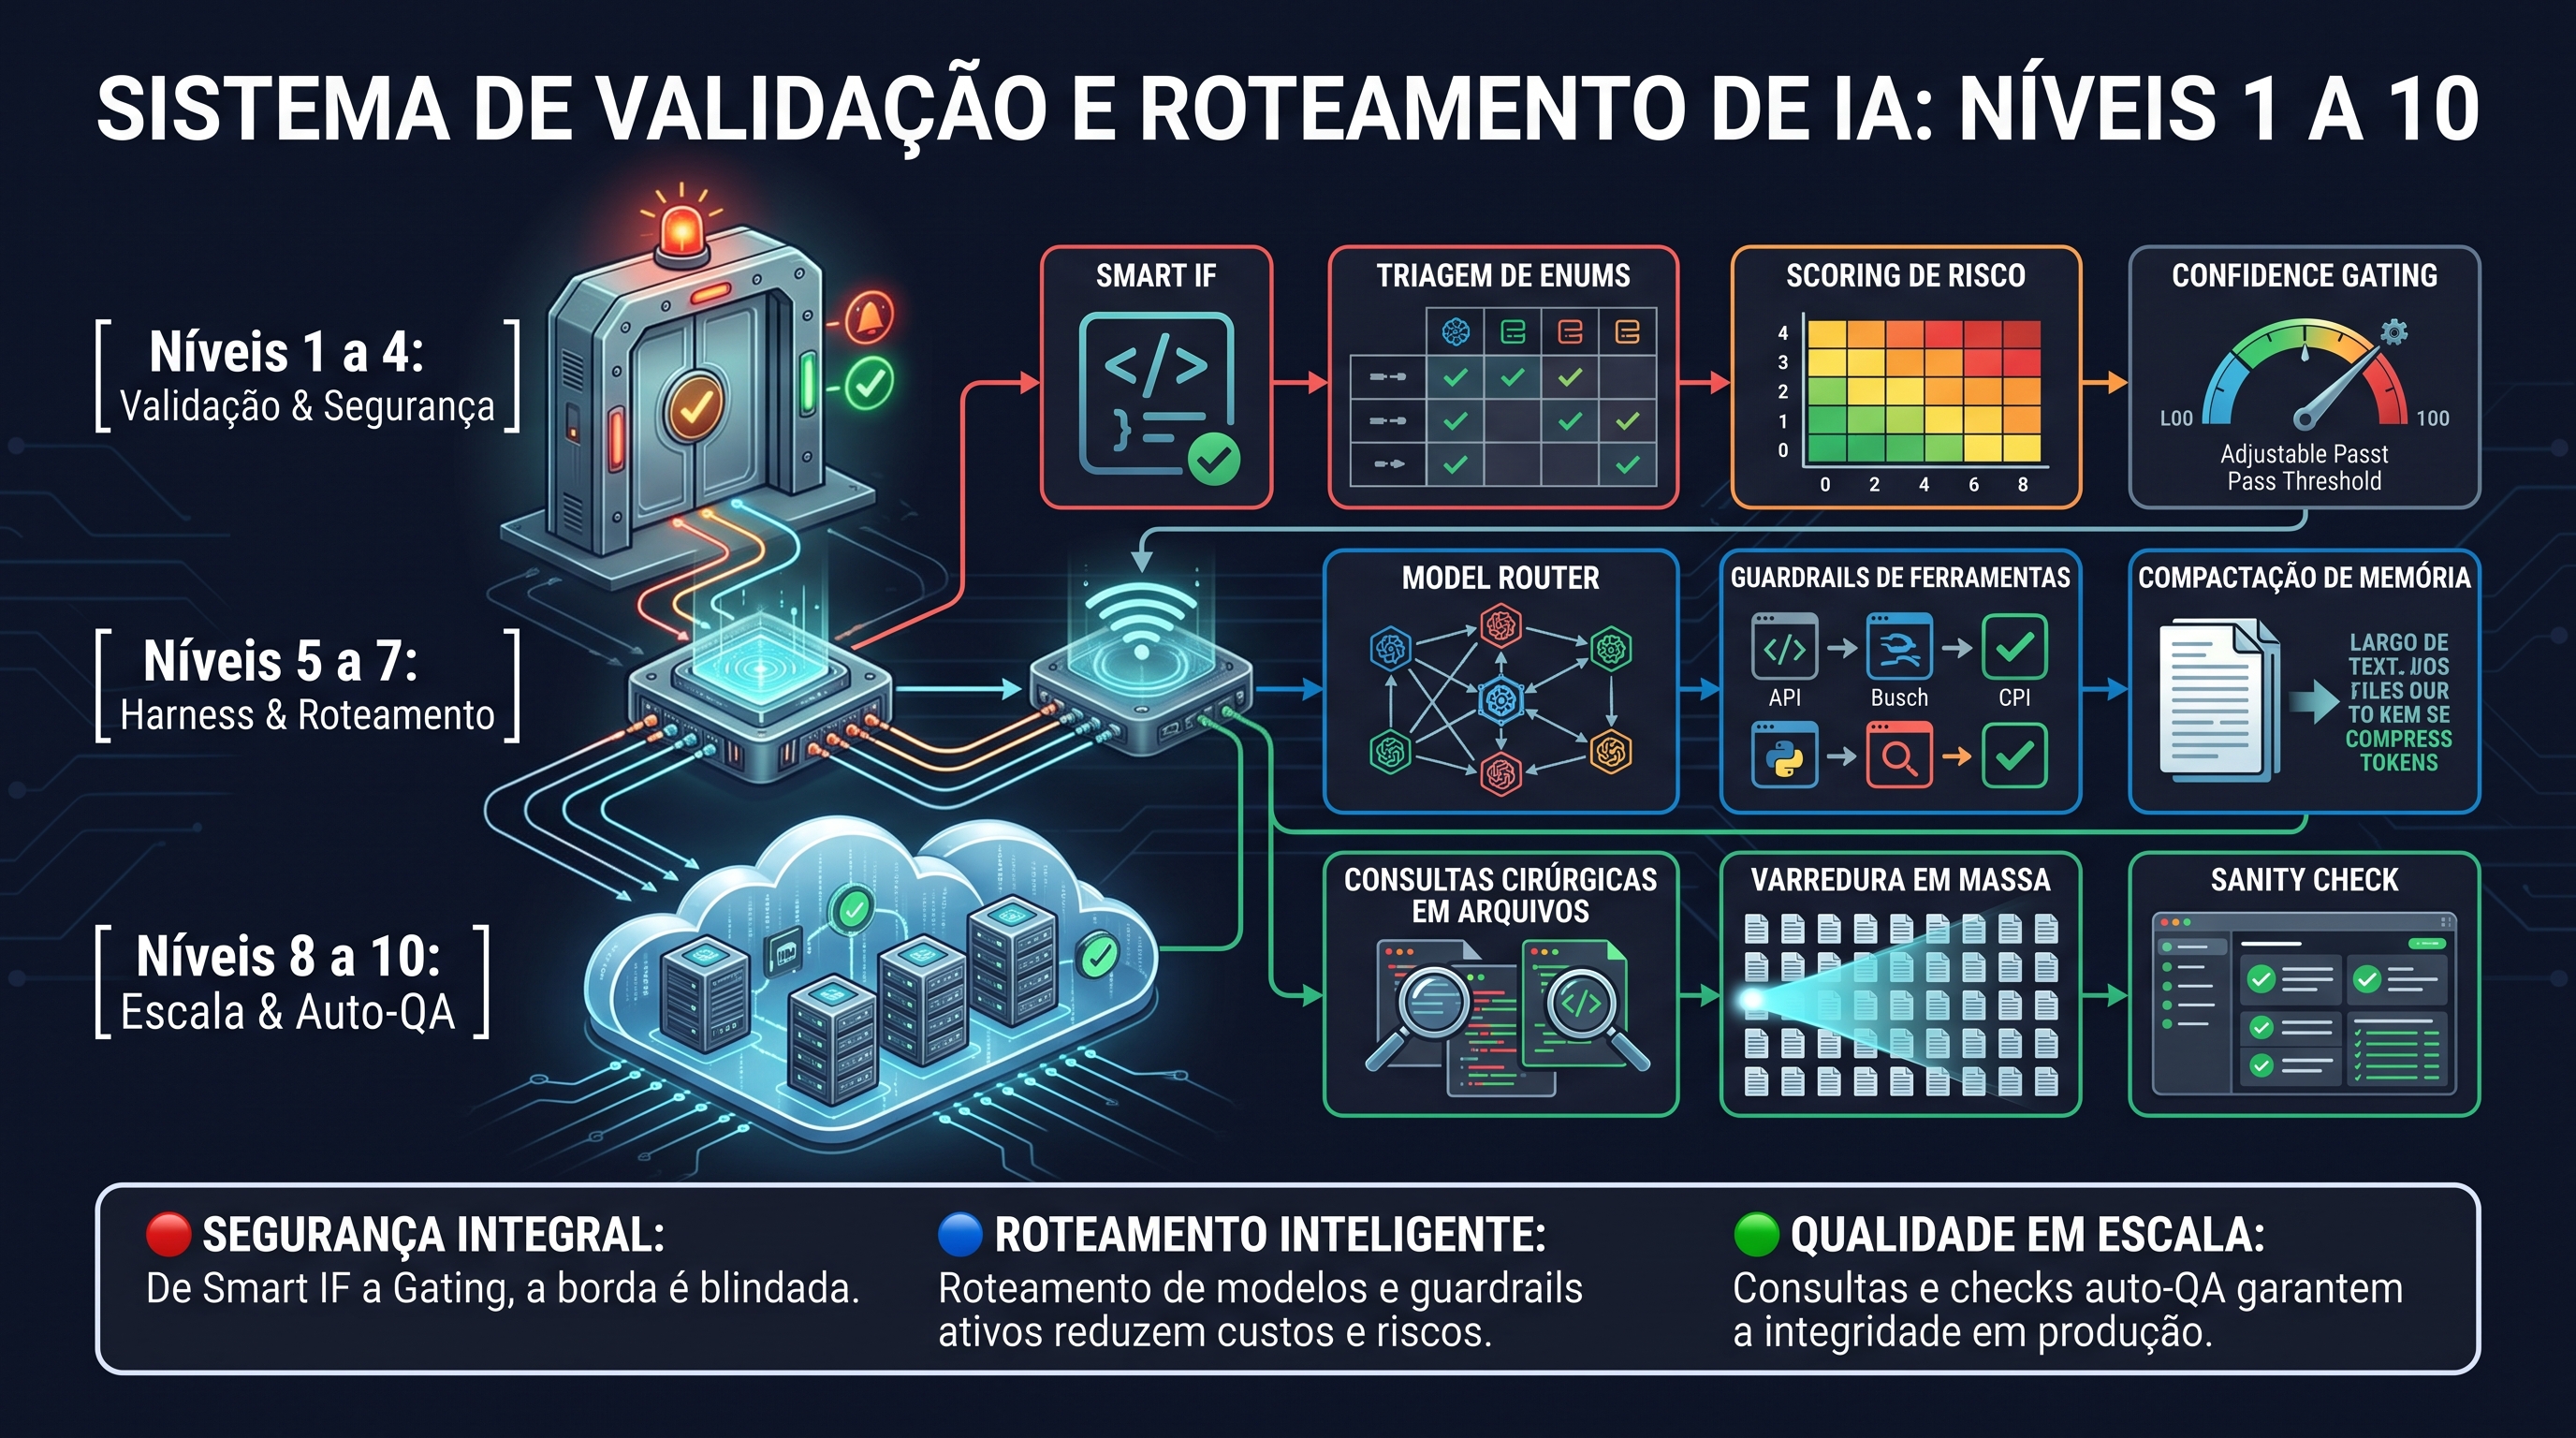
<p>Seguindo o vídeo-ensaio de <strong>IndyDevDan</strong><sup id="fnref:2" role="doc-noteref"><a href="#fn:2" class="footnote" rel="footnote">3</a></sup>, podemos dividir a aplicação dos sistemas System 1 em 10 níveis de maturidade:</p>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/10_lvl_validate_agentic_system.png" alt="Matriz de maturidade: os 10 padrões arquiteturais de uso de modelos de decisão rápida em esteiras de agentes autônomos." />
  
    <figcaption>Matriz de maturidade: os 10 padrões arquiteturais de uso de modelos de decisão rápida em esteiras de agentes autônomos.
</figcaption>
  
</figure>

<hr />
<h3 id="nível-1-validação-condicional-rápida-smart-if">Nível 1: Validação Condicional Rápida (<em>Smart IF</em>)</h3>
<p>Substitui expressões regulares frágeis por validações semânticas booleanas (<code class="language-plaintext highlighter-rouge">noul</code>) executadas em milissegundos.</p>
<ul>
  <li><strong>Caso de Uso:</strong> Sanitizar entradas na borda da API para identificar tentativas de <em>prompt injection</em> ou comandos perigosos antes de instanciar a sessão do agente.</li>
</ul>

<h3 id="nível-2-triagem-por-múltipla-escolha-e-enums">Nível 2: Triagem por Múltipla Escolha e Enums</h3>
<p>Classifica eventos e payloads não estruturados diretamente em esquemas fixos de enumeração (<code class="language-plaintext highlighter-rouge">choice</code>).</p>
<ul>
  <li><strong>Caso de Uso:</strong> Categorizar alertas de log como <code class="language-plaintext highlighter-rouge">BUG_CRITICO</code>, <code class="language-plaintext highlighter-rouge">DEPRECATION</code> ou <code class="language-plaintext highlighter-rouge">RUIDO_TRANSIENTE</code>, direcionando o evento para a fila assíncrona correta sem instanciar um LLM.</li>
</ul>

<h3 id="nível-3-pontuação-ponderada-de-risco-composite-scoring">Nível 3: Pontuação Ponderada de Risco (<em>Composite Scoring</em>)</h3>
<p>Mede o impacto de alterações a partir de matrizes de critérios configuradas em JSON (<code class="language-plaintext highlighter-rouge">score</code>).</p>
<ul>
  <li><strong>Caso de Uso:</strong> Avaliar o risco de Pull Requests no CI/CD considerando linhas alteradas, tabelas afetadas e migrações de banco, gerando um índice numérico de risco de 1 a 5.</li>
</ul>

<h3 id="nível-4-travas-de-segurança-por-confiança-confidence-gating">Nível 4: Travas de Segurança por Confiança (<em>Confidence Gating</em>)</h3>
<p>Bloqueia ações de alto impacto com base no índice probabilístico calibrado retornado pelo modelo.</p>
<ul>
  <li><strong>Caso de Uso:</strong> Interceptar comandos de terminal (<code class="language-plaintext highlighter-rouge">git push --force</code>, <code class="language-plaintext highlighter-rouge">rm -rf</code>, <code class="language-plaintext highlighter-rouge">DROP TABLE</code>). Se o índice de confiança de segurança for menor que 99% (<code class="language-plaintext highlighter-rouge">confidence &lt; 0.99</code>), a execução pausa imediatamente e exige confirmação humana explícita.</li>
</ul>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># Example: Confidence Gating in the agent CLI harness
</span><span class="n">decision</span> <span class="o">=</span> <span class="n">laya_client</span><span class="p">.</span><span class="n">evaluate</span><span class="p">(</span>
    <span class="n">state</span><span class="o">=</span><span class="s">"rm -rf /var/log/app/*"</span><span class="p">,</span>
    <span class="n">questions</span><span class="o">=</span><span class="p">{</span><span class="s">"is_destructive"</span><span class="p">:</span> <span class="p">{</span><span class="s">"type"</span><span class="p">:</span> <span class="s">"noul"</span><span class="p">}}</span>
<span class="p">)</span>

<span class="k">if</span> <span class="p">(</span><span class="n">decision</span><span class="p">[</span><span class="s">"is_destructive"</span><span class="p">][</span><span class="s">"value"</span><span class="p">]</span> <span class="ow">and</span> <span class="n">decision</span><span class="p">[</span><span class="s">"is_destructive"</span><span class="p">][</span><span class="s">"confidence"</span><span class="p">]</span> <span class="o">&gt;=</span> <span class="mf">0.99</span><span class="p">):</span>
    <span class="n">request_human_confirmation</span><span class="p">(</span><span class="n">command</span><span class="p">)</span>
</code></pre></div></div>

<hr />

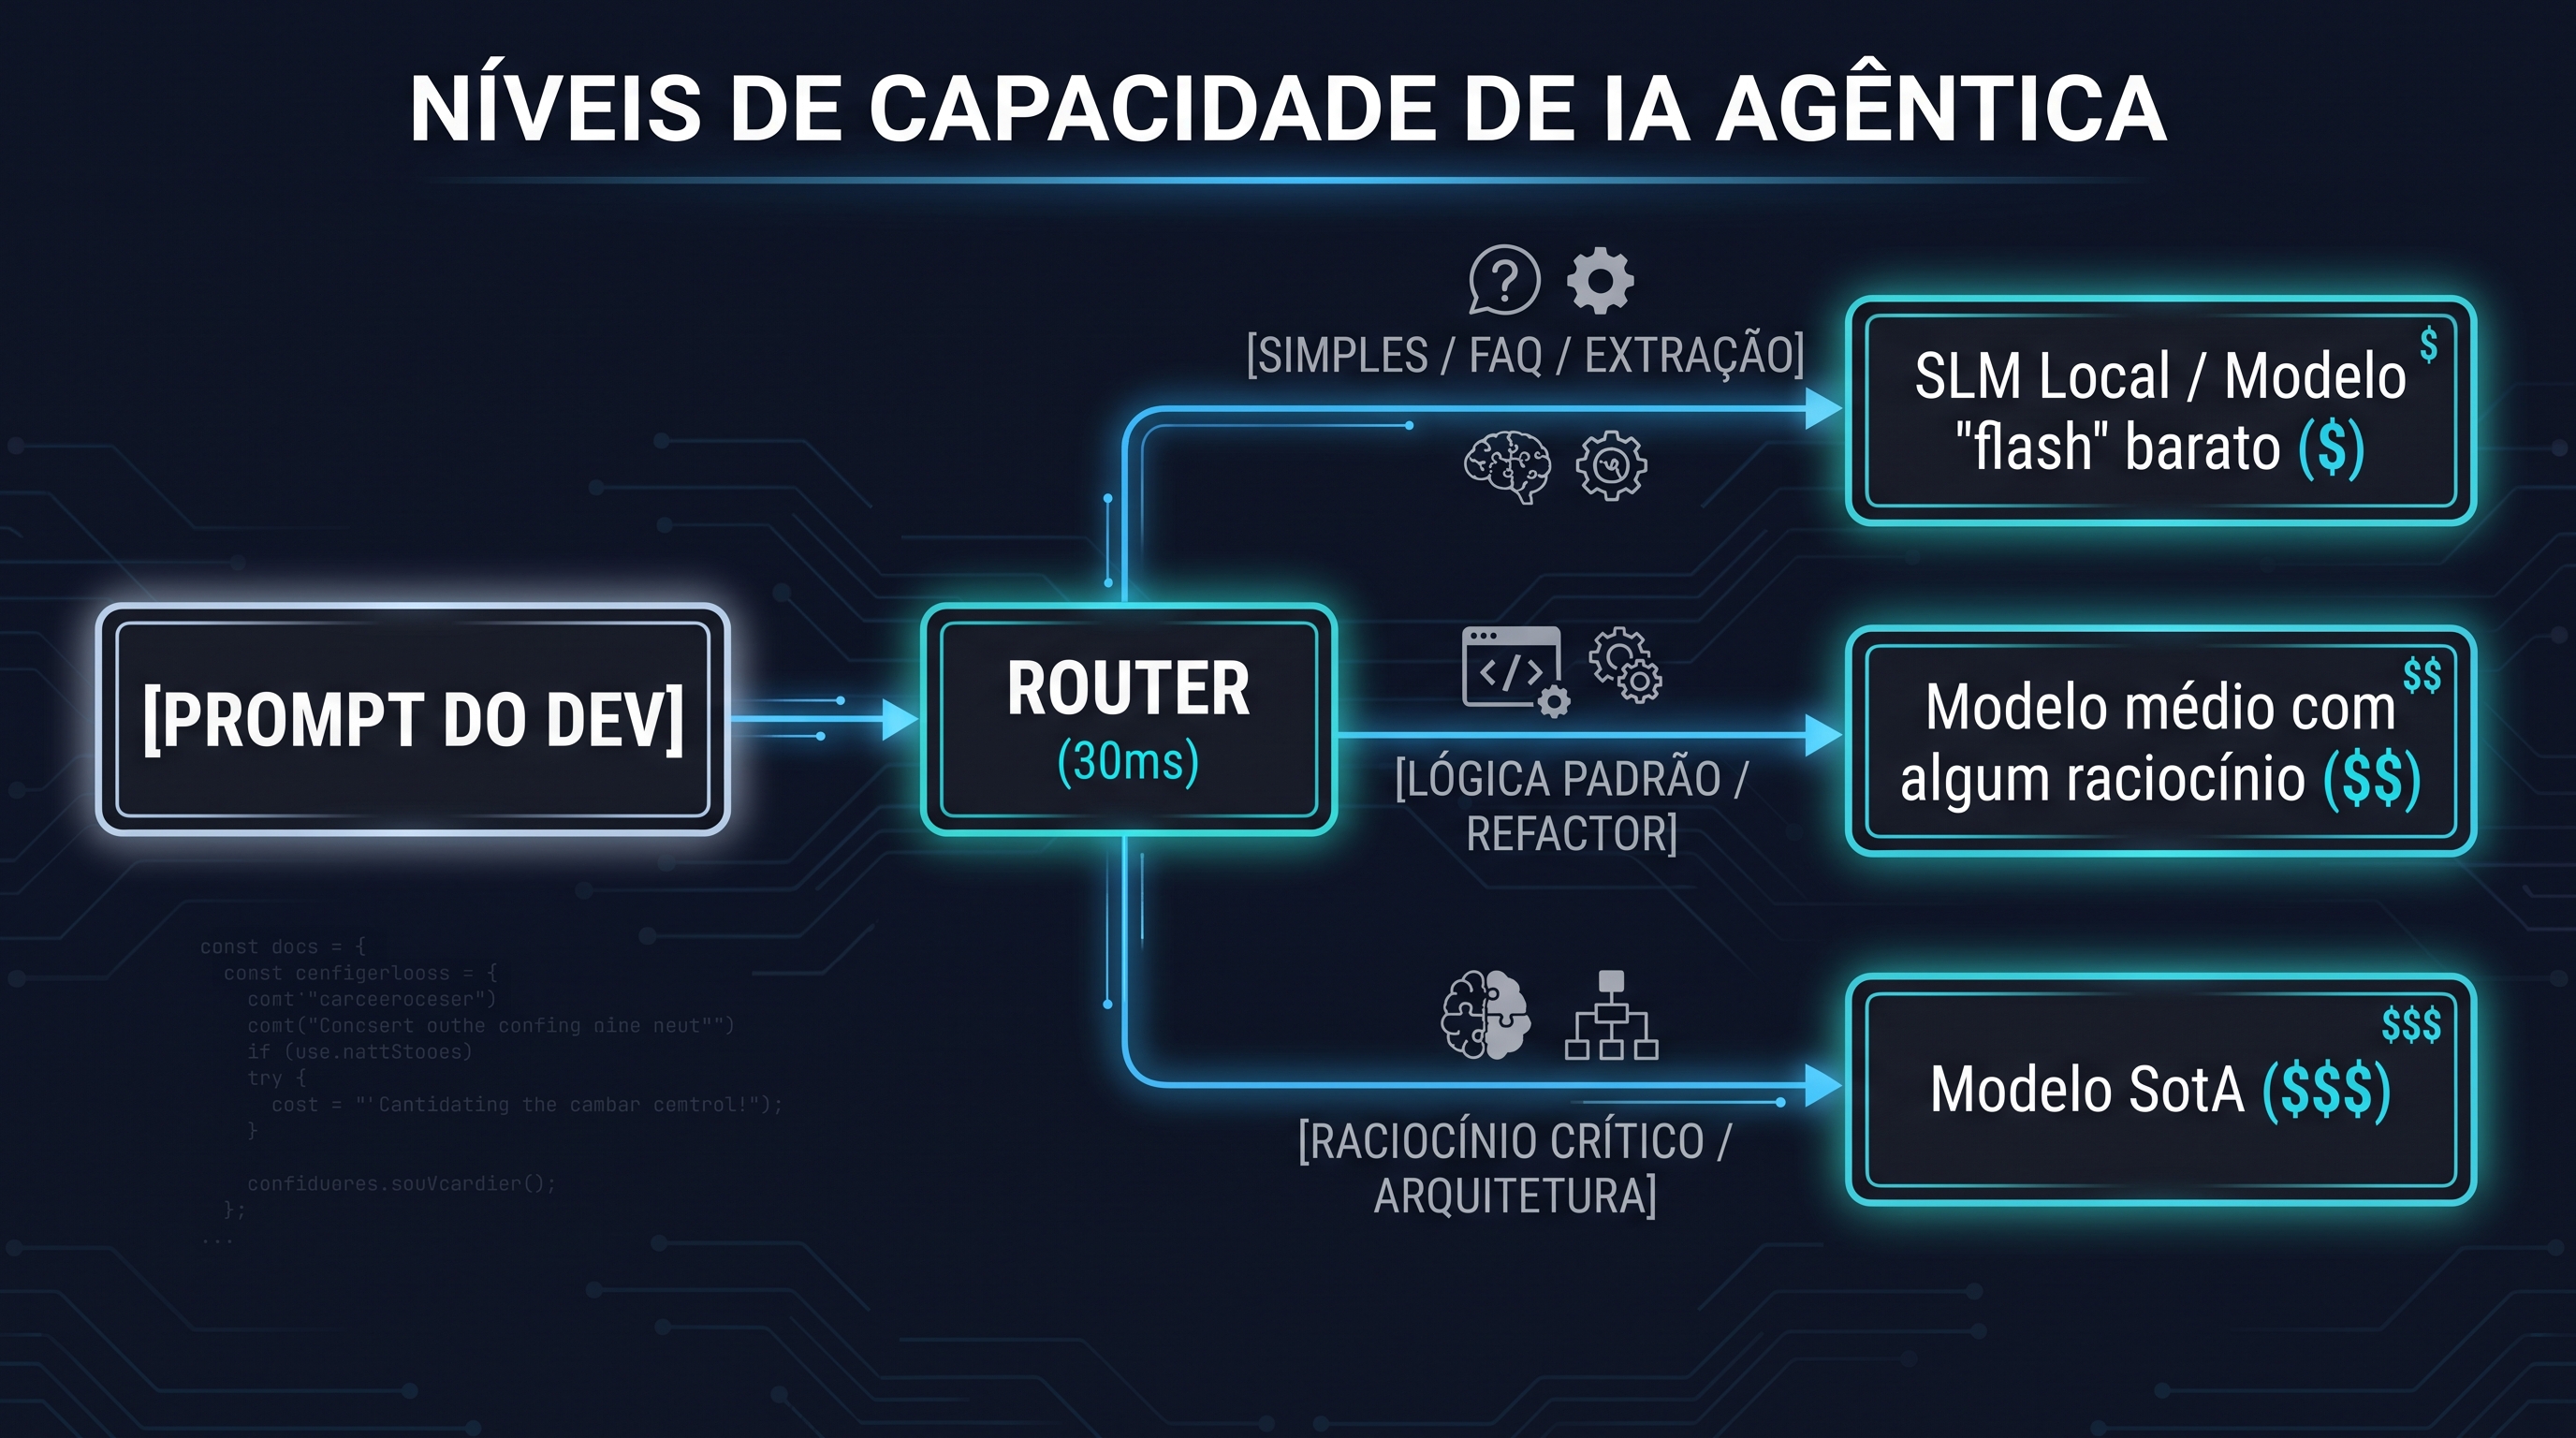
<h3 id="nível-5-roteamento-inteligente-de-agentes-e-modelos-modelagent-router">Nível 5: Roteamento Inteligente de Agentes e Modelos (<em>Model/Agent Router</em>)</h3>
<p>Posiciona uma porta de triagem barata na frente de pools de modelos caros.</p>
<ul>
  <li><strong>Caso de Uso:</strong> Analisar o prompt do desenvolvedor em 30ms. Se for uma dúvida de documentação, despacha para um SLM local, uma consulta no FAQ ou Claude Haiku da vida; se envolver refatoração arquitetural profunda, direciona para um GPT Sol, Gemini 3.8 pro, GLM 5.3</li>
</ul>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/smart_router.png" alt="Roteamento hierárquico: triagem em 30ms despachando prompts simples para modelos leves e reservando LLMs caros para síntese profunda." />
  
    <figcaption>Roteamento hierárquico: triagem em 30ms despachando prompts simples para modelos leves e reservando LLMs caros para síntese profunda.
</figcaption>
  
</figure>

<h3 id="nível-6-guardrails-no-harness-do-agente-harness-hooks--jevguard">Nível 6: Guardrails no Harness do Agente (<em>Harness Hooks / JevGuard</em>)</h3>
<p>Intercepta a execução de ferramentas (<em>tool calls</em>) diretamente no loop de runtime do agente.</p>
<ul>
  <li><strong>Caso de Uso:</strong> Impedir que o agente modifique arquivos protegidos (<code class="language-plaintext highlighter-rouge">.env</code>, <code class="language-plaintext highlighter-rouge">docker-compose.prod.yml</code> ou certificados SSL) antes que a operação de escrita chegue ao sistema de arquivos do sistema operacional.
    <h3 id="nível-7-compactação-oportuna-de-memória-e-contexto">Nível 7: Compactação Oportuna de Memória e Contexto</h3>
    <p>Identifica o momento exato para resumir o histórico da sessão sem perder informações críticas de depuração.</p>
  </li>
  <li><strong>Caso de Uso:</strong> Em vez de rodar algoritmos caros de sumarização a cada interação, o classificador verifica se uma subtarefa foi concluída com sucesso e autoriza a compactação do contexto apenas na transição de tarefas.</li>
</ul>

<hr />

<h3 id="nível-8-consultas-pontuais-em-arquivos-cheap-file-reads">Nível 8: Consultas Pontuais em Arquivos (<em>Cheap File Reads</em>)</h3>
<p>Extrai informações booleanas ou enums de um arquivo sem carregar centenas de linhas para a janela de contexto do LLM.</p>
<ul>
  <li><strong>Caso de Uso:</strong> O agente precisa saber se <code class="language-plaintext highlighter-rouge">auth.py</code> implementa suporte a tokens JWT. Uma consulta ao classificador retorna <code class="language-plaintext highlighter-rouge">{"has_jwt": true, "confidence": 0.99}</code> em 30ms, economizando milhares de tokens de contexto no modelo principal.</li>
</ul>

<h3 id="nível-9-varredura-concorrente-de-repositórios-files-at-scale">Nível 9: Varredura Concorrente de Repositórios (<em>Files at Scale</em>)</h3>
<p>Executa centenas de consultas paralelas sobre bases de código inteiras em frações de segundo.</p>
<ul>
  <li><strong>Caso de Uso:</strong> Localizar quais arquivos de um projeto com mais de 1.500 módulos utilizam dependências descontinuadas ou padrões inseguros de SQL, devolvendo apenas os caminhos relevantes para o agente trabalhar.</li>
</ul>

<h3 id="nível-10-auto-validação-e-qa-do-agente-agentic-self-validation">Nível 10: Auto-Validação e QA do Agente (<em>Agentic Self-Validation</em>)</h3>
<p>Permite que o agente audite as próprias alterações antes de submeter o código para o pipeline de CI/CD.</p>
<ul>
  <li><strong>Caso de Uso:</strong> Após rodar a suíte de testes, o agente submete o diff gerado e a descrição da issue ao modelo de decisão para checar se houve desvio de escopo antes de abrir o Pull Request.</li>
</ul>

<hr />

<h2 id="5-a-ilusão-do-saas-os-riscos-de-amarrar-o-jev-e-o-surgimento-do-laya">5. A Ilusão do SaaS: Os Riscos de Amarrar o Jev e o Surgimento do Laya</h2>

<p>À primeira vista, o Jev parece a solução definitiva: US$ 20 por 1 milhão de requisições soa quase gratuito quando comparado aos milhares de dólares de um modelo generativo de ponta.</p>

<p>No entanto, sob a ótica de arquitetura de sistemas e governança corporativa, <strong>amarrar esteiras críticas de desenvolvimento ou fluxos de borda a uma API proprietária traz custos ocultos severos</strong>:</p>

<ol>
  <li>
    <p><strong>A Penalidade de Latência de Rede (<em>The WAN Latency Tax</em>):</strong><br />
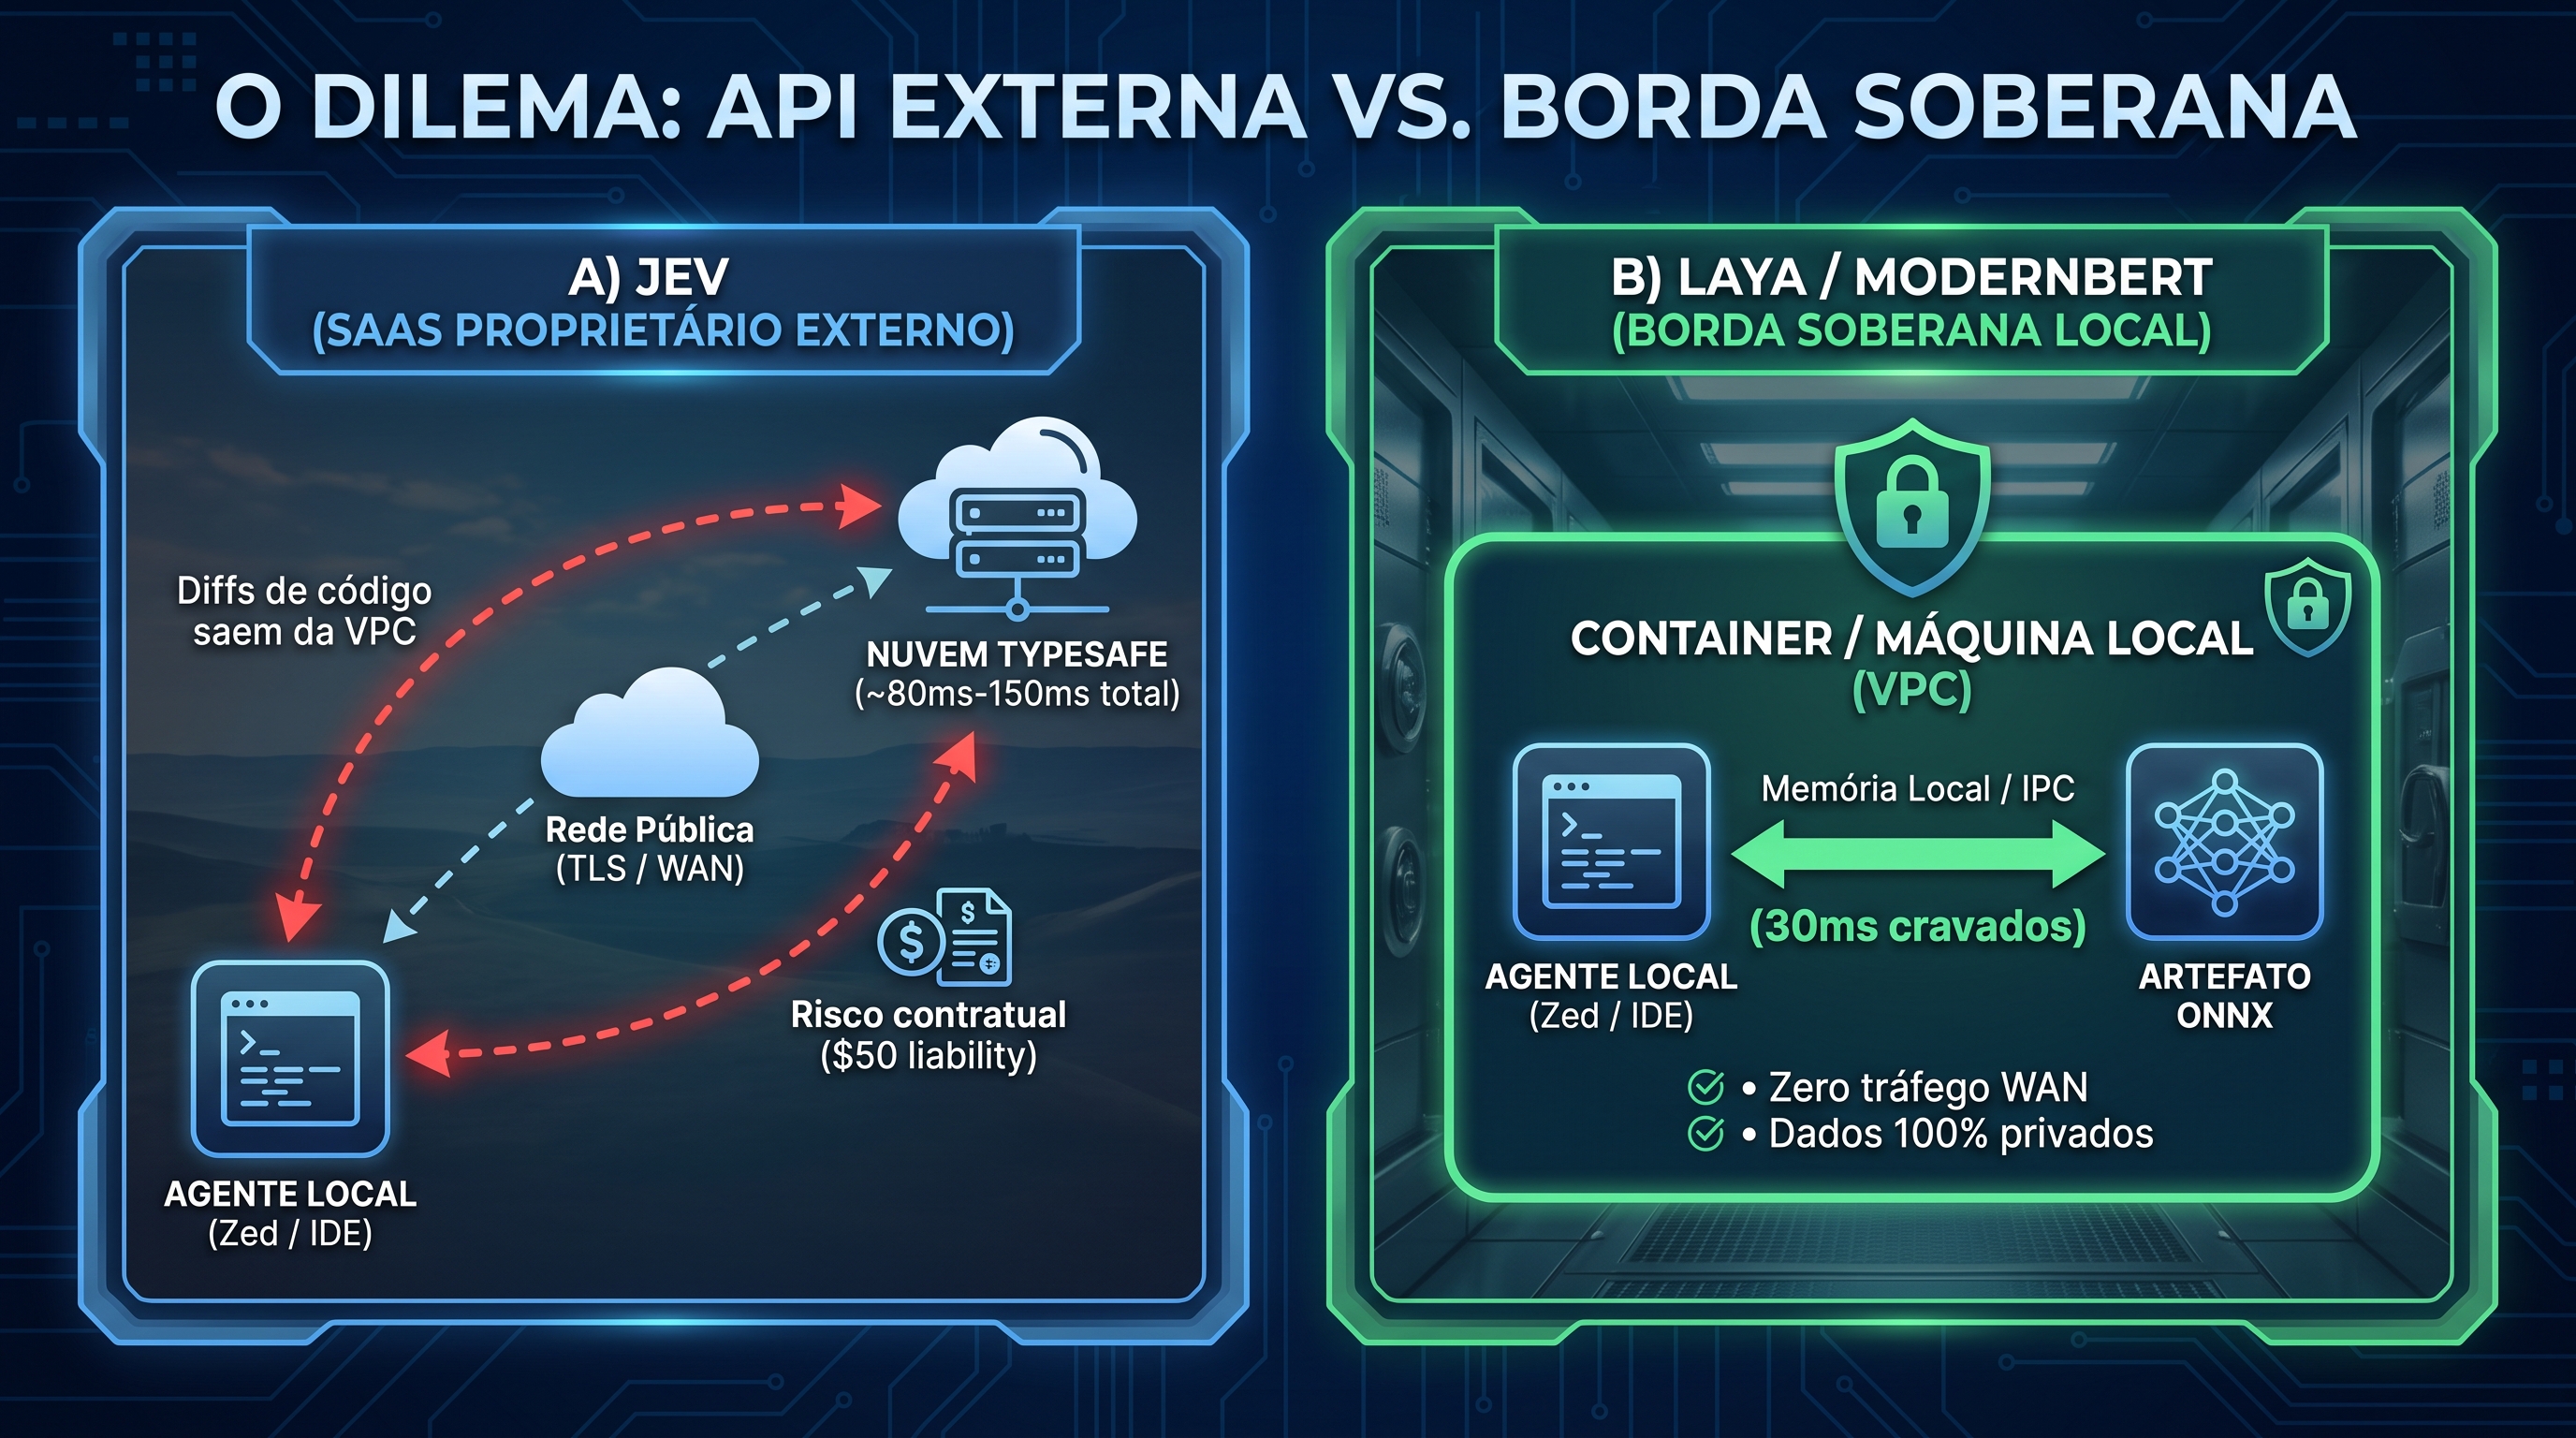
Um modelo System 1 existe para ser um reflexo quase instantâneo. No entanto, ao usar uma API externa em nuvem, você paga o custo do roundtrip de rede (DNS, handshake TLS e latência internacional para datacenters nos EUA). Uma inferência que leva 30ms no chip acaba demorando <strong>120ms a 180ms na ponta</strong>. Em uma sessão com 50 microdecisões de triagem, você desperdiça vários segundos apenas esperando pacotes trafegarem pela internet.</p>
  </li>
  <li>
    <p><strong>Vazamento do Perímetro de Dados:</strong><br />
Para o Jev classificar comandos ou auditar Pull Requests, você precisa enviar o conteúdo bruto do seu repositório: diffs confidenciais, regras de negócio internas e logs de infraestrutura. Para qualquer ambiente corporativo com exigências de <em>compliance</em>, SOC 2 ou sigilo industrial, abrir mão do perímetro por uma decisão booleana é um risco inaceitável.</p>
  </li>
  <li>
    <p><strong>As Pegadinhas do <em>Master Customer Agreement (MCA)</em>:</strong><br />
Uma auditoria nos termos jurídicos da TypeSafe AI expõe amarras contratuais rígidas. A <strong>Cláusula Anti-Destilação (Seção 2.3b)</strong> proíbe expressamente o uso de saídas do Jev para treinar ou destilar modelos locais concorrentes, numa tentativa explícita de impor dependência de plataforma. Além disso, as S<strong>eções 12.2 e 12.3</strong> estabelecem uma responsabilidade assimétrica: se a API deles vazar seu código-fonte ou sofrer indisponibilidade em um deploy crítico, a indenização máxima prevista em contrato é de apenas <strong>US$ 50,00</strong>, enquanto a responsabilidade do cliente por eventuais violações é ilimitada. Por fim, a <strong>Seção 4.3</strong> autoriza a coleta contínua de metadados, hashes de execução e padrões operacionais do seu time para uso interno da fornecedora.</p>
  </li>
</ol>

<hr />

<h3 id="o-contraponto-como-o-laya-inaugurou-a-alternativa-de-pesos-abertos">O Contraponto: Como o Laya Inaugurou a Alternativa de Pesos Abertos</h3>

<p>É aqui que a história ganha um contorno importante de engenharia: <strong>o Jev não inventou essa roda sozinho</strong>. Ele é a face comercial empacotada de uma técnica que a comunidade de código aberto já havia estruturado com o <strong>Laya</strong> (desenvolvido pela ConvAI), sustentado pelo <strong>ModernBERT-large</strong><sup id="fnref:5" role="doc-noteref"><a href="#fn:5" class="footnote" rel="footnote">4</a></sup>.</p>

<p>Com 421 milhões de parâmetros sob licença Apache 2.0, o <strong>ModernBERT</strong> é leve o suficiente para rodar com menos de 1.5 GB de VRAM ou diretamente em CPU quantizada via INT8. Sua arquitetura traz suporte nativo a 8.192 tokens com <em>Rotary Position Embeddings (RoPE)</em> e <em>FlashAttention-2</em>, permitindo processar arquivos inteiros de código ou payloads densos em passo único. Uma vez treinado, o modelo pode ser compilado para o runtime <strong>ONNX</strong>, funcionando como um artefato local autocontido no contêiner Docker, no terminal da IDE ou na borda da VPC.</p>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/api_vs_local_dilema.png" alt="Arquitetura SaaS vs. Soberania de Borda: latência de rede transatlântica e vazamento de código vs. 30ms locais em CPU via ONNX." />
  
    <figcaption>Arquitetura SaaS vs. Soberania de Borda: latência de rede transatlântica e vazamento de código vs. 30ms locais em CPU via ONNX.
</figcaption>
  
</figure>

<hr />

<h2 id="6-o-laya-e-a-realidade-da-trincheira-ele-não-é-um-hot-swap">6. O Laya e a Realidade da Trincheira: Ele Não É um “Hot Swap”</h2>

<p>Aqui entra a honestidade crua de quem vive na trincheira da engenharia: <strong>o Laya base não é um componente de <em>hot swap</em></strong> que você simplesmente pluga em produção no lugar do Jev ou de um LLM comercial e espera que a esteira continue rodando sem incidentes.</p>

<p>Se você tentar fazer um <em>hot swap</em> do modelo base sem calibração prévia (<em>zero-shot</em>), o seu sistema vai enfrentar uma tempestade de ruído e falsos positivos.</p>

<h3 id="o-ponto-cego-do-modelo-base-zero-shot-noise">O Ponto Cego do Modelo Base (<em>Zero-Shot Noise</em>)</h3>

<p>Em análises práticas conduzidas pelo <strong>Prof. Sandeco</strong><sup id="fnref:4" role="doc-noteref"><a href="#fn:4" class="footnote" rel="footnote">5</a></sup>, ao submeter o <strong>Laya base (<em>out-of-the-box</em>)</strong> a um teste real de triagem em 1.000 mensagens de transações financeiras para detecção de golpes:</p>

<ul>
  <li><strong>Velocidade Bruta:</strong> O modelo executou 10 vezes mais rápido que LLMs generativos tradicionais.</li>
  <li><strong>O Ruído Estatístico:</strong> Por estar operando em modo <em>zero-shot</em> (sem calibração no vocabulário específico do domínio), o Laya base gerou <strong>282 falsos positivos</strong>, marcando transações legítimas como fraudulentas.</li>
</ul>

<p>Esse ruído acontece porque um encoder genérico aprendeu padrões amplos de linguagem na internet, mas não conhece a semântica fina dos seus comandos de terminal, dos seus logs de produção ou das suas regras de negócio. Tentar um <em>hot swap</em> cego em produção significa paralisar fluxos legítimos de usuários ou bloquear comandos seguros de desenvolvedores.</p>

<h3 id="a-cura-o-pipeline-de-retreino-especialista">A Cura: O Pipeline de Retreino Especialista</h3>

<p>A grande vantagem de arquiteturas de pesos abertos como o Laya sobre ModernBERT é que <strong>você não precisa de um supercomputador para especializar as decisões</strong>.</p>

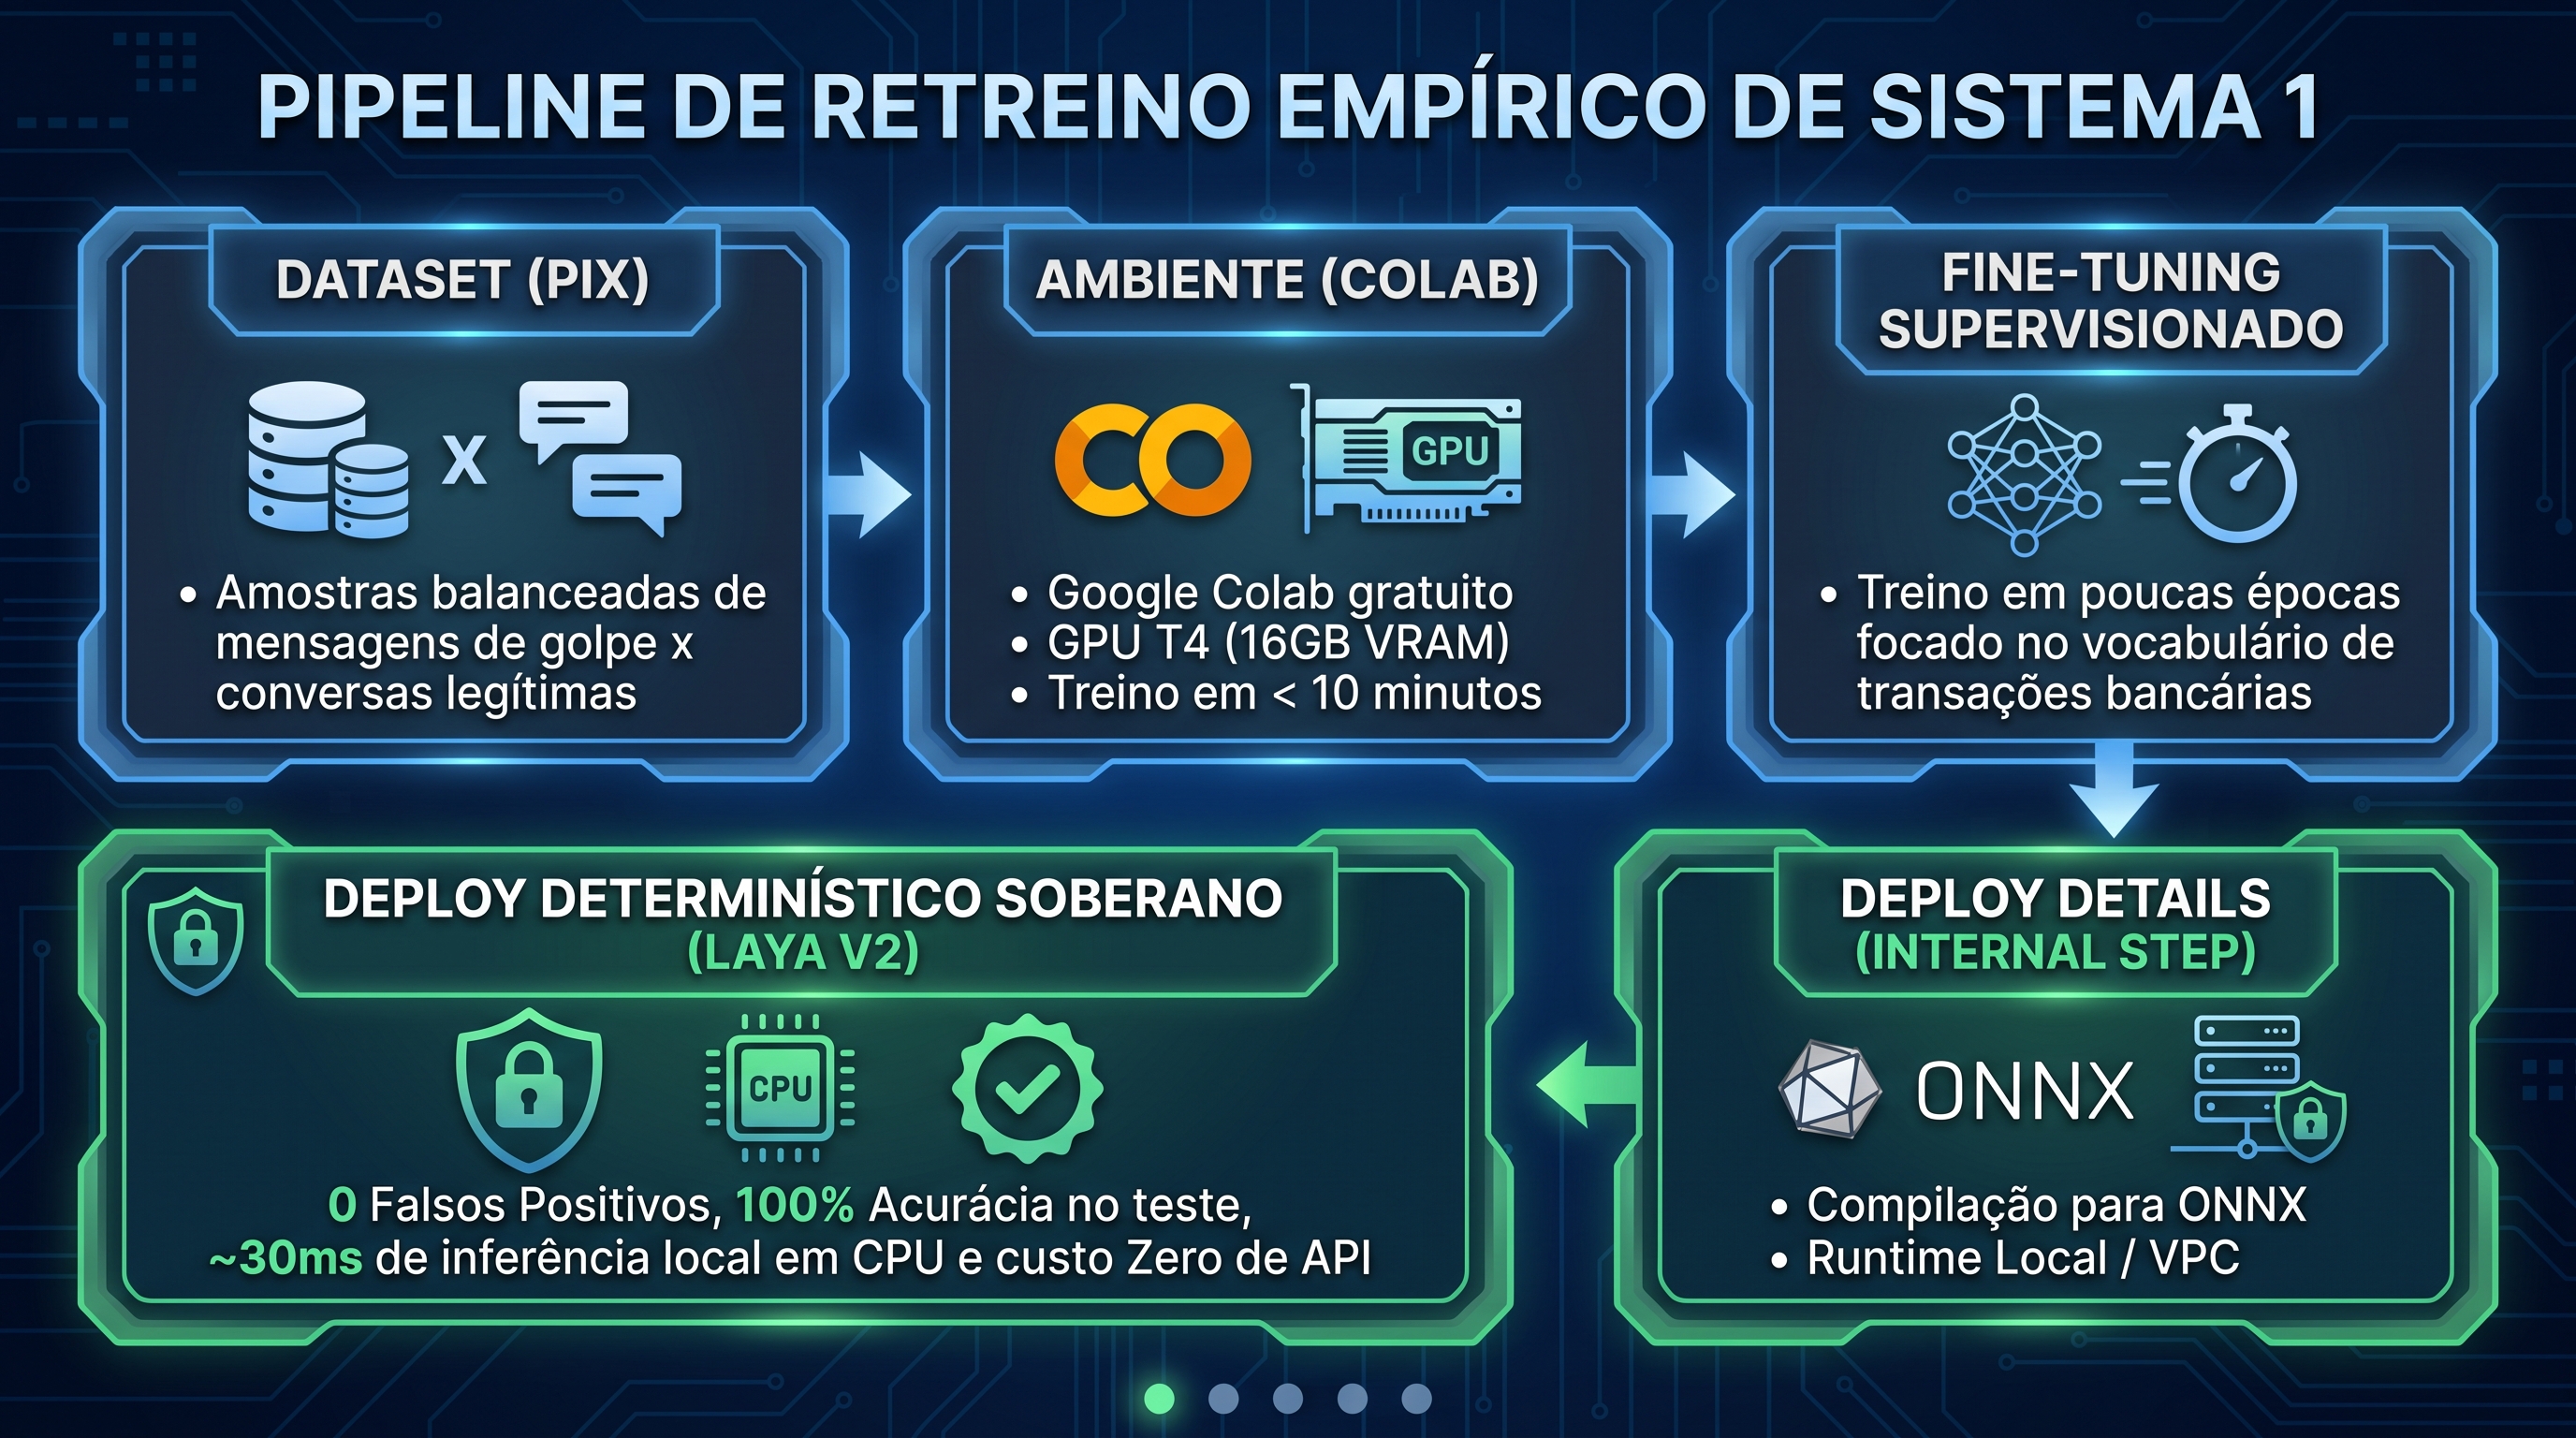
<p>No experimento, o processo de cura do modelo para transformar o Laya base ruidoso em um classificador especialista seguiu etapas diretas de engenharia:</p>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/refit_pipeline.jpeg" alt="Pipeline empírico de especialização do Laya: fine-tuning de 10 minutos no Google Colab gratuito, eliminando falsos positivos no domínio." />
  
    <figcaption>Pipeline empírico de especialização do Laya: fine-tuning de 10 minutos no Google Colab gratuito, eliminando falsos positivos no domínio.
</figcaption>
  
</figure>

<ol>
  <li><strong>Curadoria do Dataset de Domínio:</strong><br />
O experimento utilizou um conjunto balanceado de mensagens reais e sintéticas de transferências bancárias e conversas cotidianas em português, contrastadas com padrões de engenharia social, falsos comprovantes e tentativas de golpe via Pix.</li>
  <li><strong>Ambiente Modesto e Reprodutível:</strong><br />
O treinamento não exigiu clusters caros com GPUs H100 ou A100. Foi executado inteiramente em uma instância gratuita do <strong>Google Colab com GPU Nvidia T4 (16GB de VRAM)</strong>, concluindo todas as épocas de ajuste em <strong>menos de 10 minutos</strong>.</li>
  <li><strong>Ajuste Fino Supervisionado no Domínio:</strong><br />
O modelo Laya foi submetido a um ajuste fino supervisionado no Google Colab, adaptando a rede ao vocabulário específico das mensagens de fraude no contexto brasileiro em poucas épocas.</li>
  <li><strong>Validação Cega e Resultados do Laya V2:</strong><br />
Ao submeter o modelo retreinado (<em>Laya V2</em>) ao mesmo lote cego de 1.000 mensagens de validação: os <strong>282 falsos positivos</strong> foram reduzidos a <strong>ZERO</strong> e a <strong>acurácia</strong>, a precisão e o recall no domínio atingiram <strong>100%</strong>, inclusive superando a precisão inicial do Jev proprietário.</li>
  <li><strong>Compilação e Deploy via ONNX Runtime:</strong><br />
O modelo retreinado foi exportado diretamente para o formato <strong>ONNX</strong>. O binário final roda localmente em CPU (consumindo ~1.2 GB de RAM) com <strong>latência estável de ~30ms por inferência</strong>, sem necessidade de GPUs dedicadas em produção e com isolamento total dos dados transacionais.</li>
</ol>

<hr />
<h2 id="7-matriz-de-decisão-arquitetural-o-que-usar-e-quando">7. Matriz de Decisão Arquitetural: O Que Usar e Quando</h2>

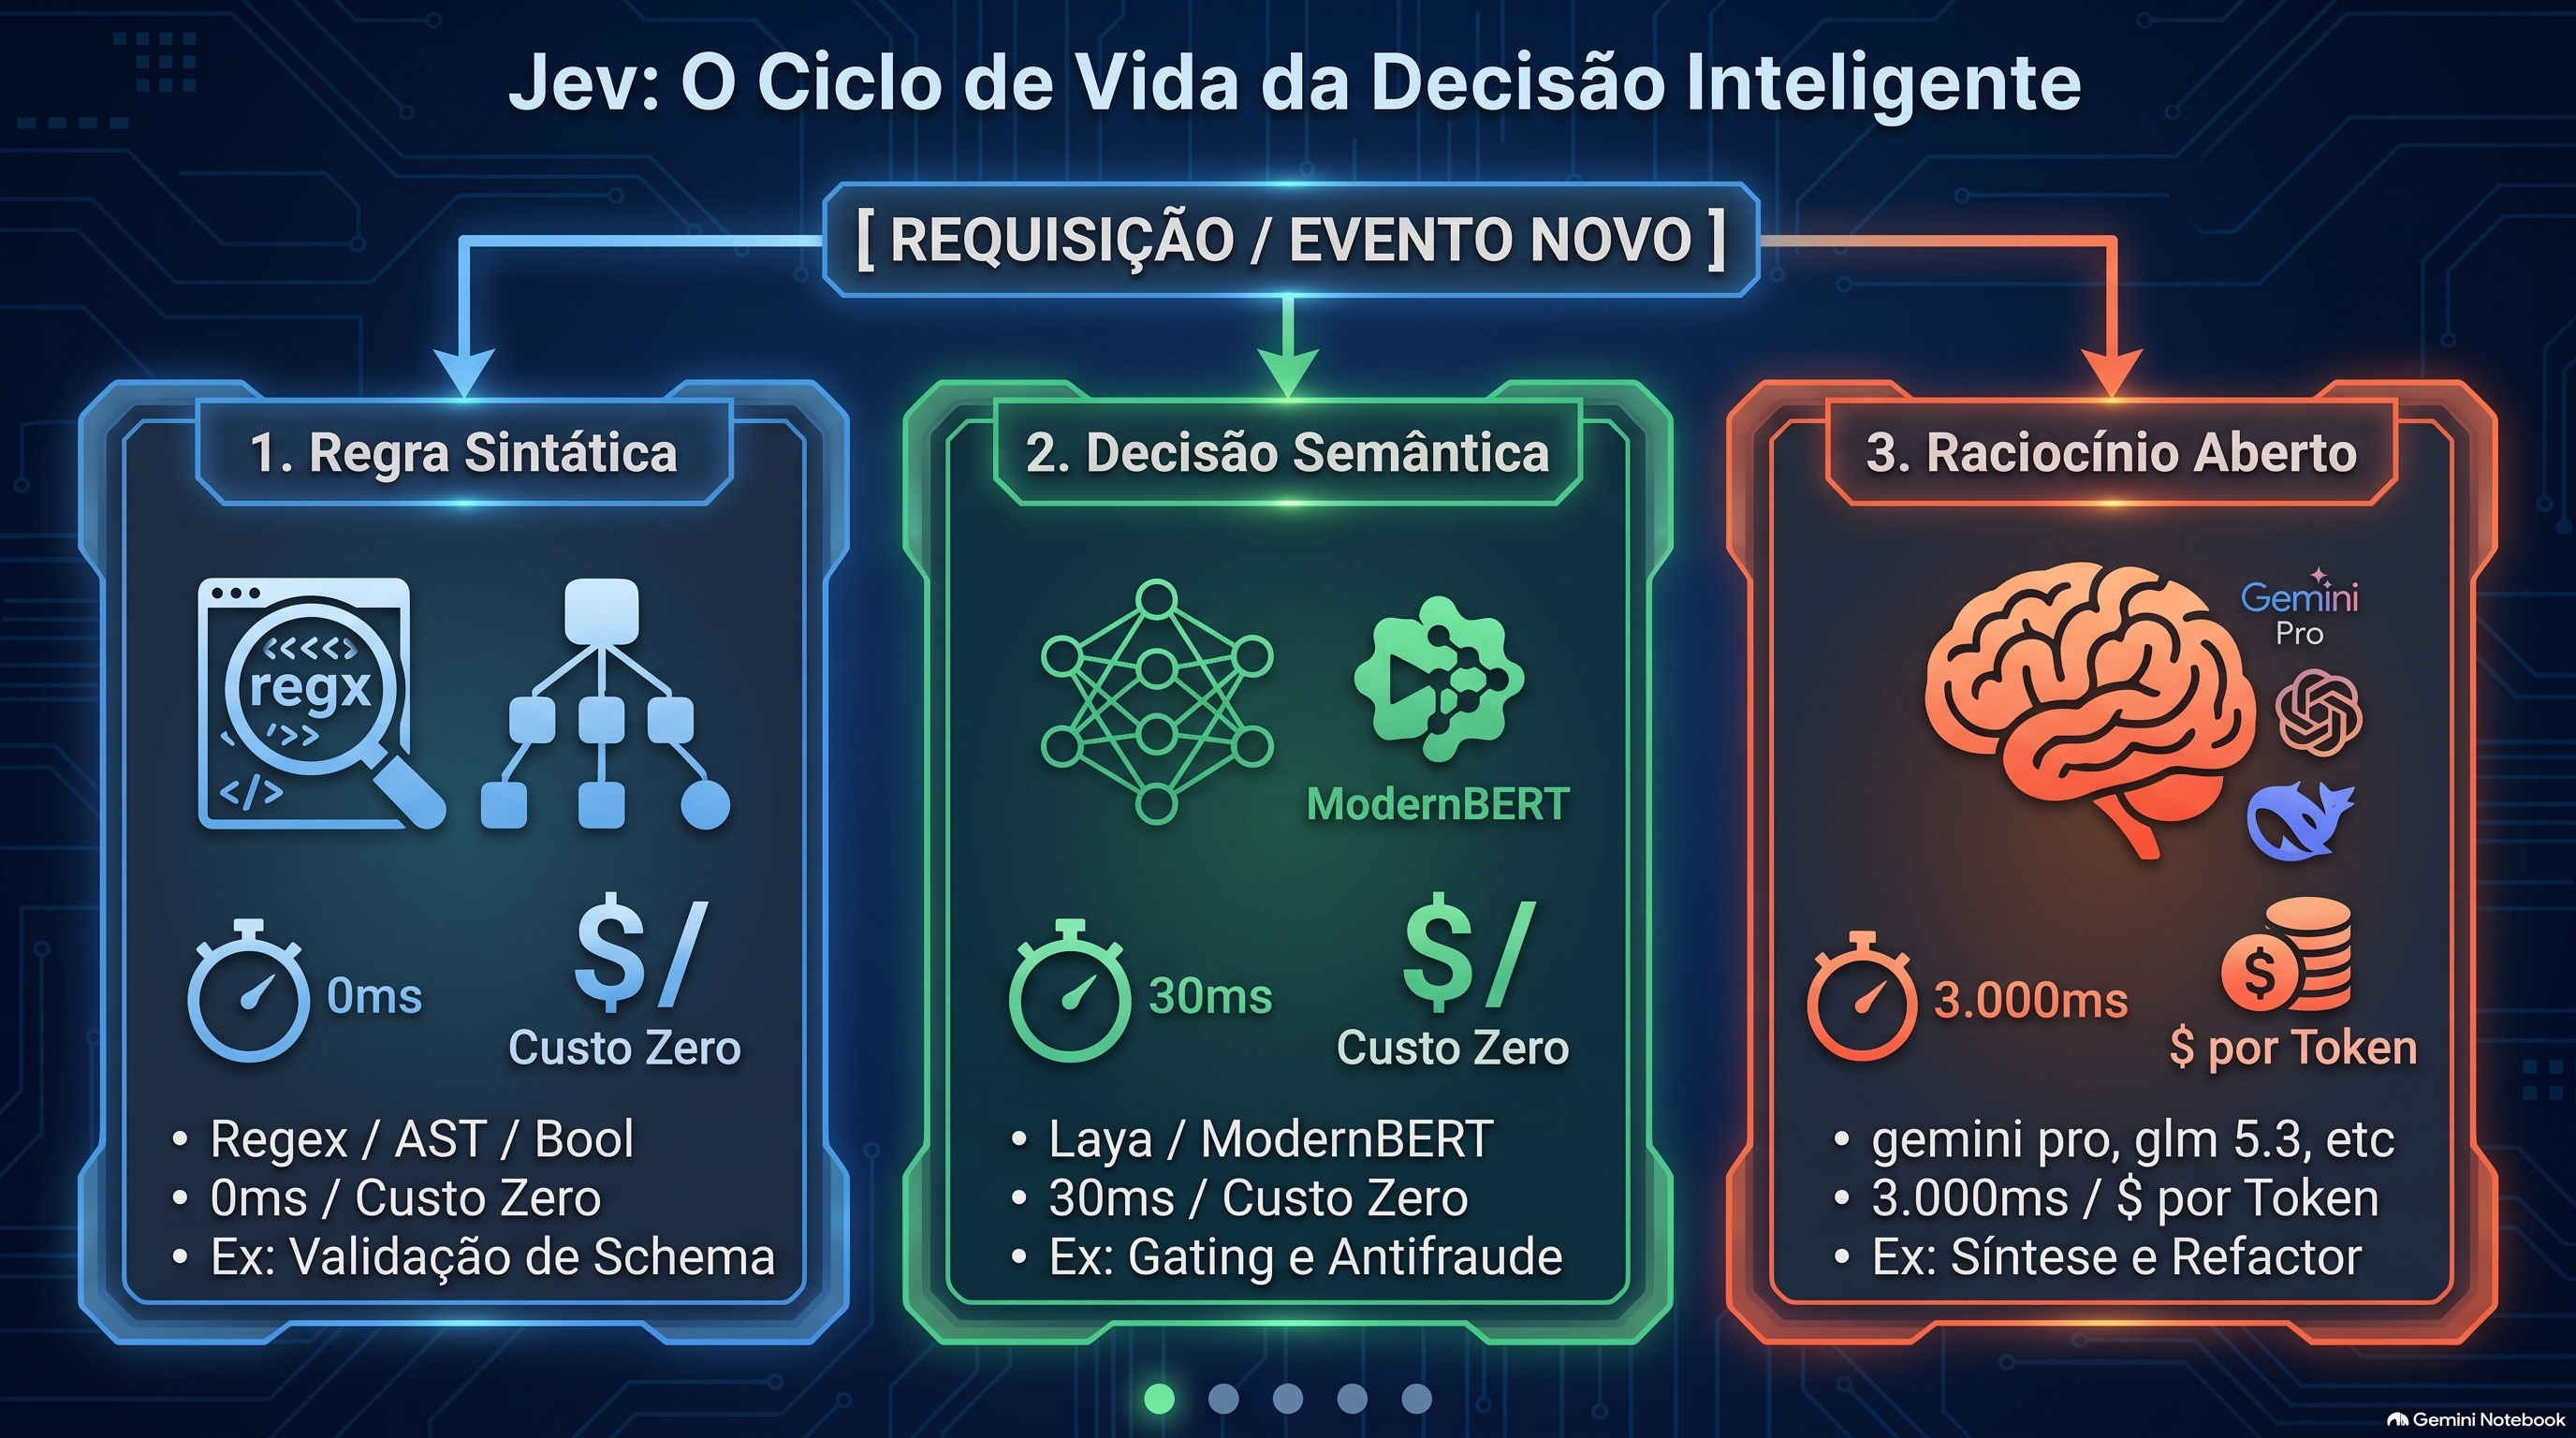
<p>Para organizar portas lógicas e fluxos de controle com parcimônia computacional, podemos estruturar as decisões do sistema em quatro camadas complementares:</p>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/smart_decision.png" alt="As quatro camadas de controle: da lógica booleana determinística (0ms) aos LLMs de raciocínio abstrato (3.000ms)." />
  
    <figcaption>As quatro camadas de controle: da lógica booleana determinística (0ms) aos LLMs de raciocínio abstrato (3.000ms).
</figcaption>
  
</figure>

<h3 id="camada-0-lógica-booleana-pura-ast-e-expressões-regulares">Camada 0: Lógica Booleana Pura, AST e Expressões Regulares</h3>
<p>Validações de sintaxe estrita, formatos conhecidos de arquivo e checagens de tipos em tempo de compilação devem permanecer no código tradicional. Um parser sintático ou uma condicional <code class="language-plaintext highlighter-rouge">if</code> bem escrita entrega latência zero, custo nulo e determinismo absoluto. Redes neurais não devem ser usadas para resolver problemas que a lógica formal já soluciona com precisão.</p>
<h3 id="camada-1-modelos-de-decisão-system-1-locais-laya--modernbert-onnx">Camada 1: Modelos de Decisão System 1 Locais (Laya / ModernBERT ONNX)</h3>
<p>Esta camada atende microdecisões semânticas de alta frequência (30ms a 70ms), onde o texto é flexível mas a saída precisa ser estritamente tipada. É o caso de guardrails no terminal do desenvolvedor, bloqueio de transações fraudulentas em tempo real no gateway de pagamento, triagem de logs de erro em observabilidade e varreduras paralelas em repositórios de código. O benefício é latência de memória local, isolamento total dos dados na VPC e custo marginal zero.</p>
<h3 id="camada-2-modelos-de-decisão-em-saas-comercial-jev--typesafe">Camada 2: Modelos de Decisão em SaaS Comercial (Jev / TypeSafe)</h3>
<p>Indicada para protótipos rápidos e pontuais, provas de conceito descartáveis ou pipelines onde o time prefere não gerenciar contêineres locais e aceita o tráfego de dados para nuvens externas e a latência de rede internacional.</p>
<h3 id="camada-3-llms-deliberativos-de-sistema-2-claude-opus-sonnet-gpt-4o">Camada 3: LLMs Deliberativos de Sistema 2 (Claude Opus, Sonnet, GPT-4o)</h3>
<p>Reservada exclusivamente para tarefas que exigem raciocínio abstrato em múltiplas etapas, síntese de contexto amplo, geração de código novo ou resolução de conflitos arquiteturais complexos.</p>

<hr />
<h3 id="a-política-operacional-de-incerteza-confidence-thresholds">A Política Operacional de Incerteza (Confidence Thresholds)</h3>

<p>Para governar a execução automática no código, os limiares matemáticos de confiança definem o comportamento do sistema:</p>

<ul>
  <li><strong>Zona de Certeza Alta (<code class="language-plaintext highlighter-rouge">confidence &gt;= 0.98</code>):</strong> O sistema executa a ação ou o bloqueio de forma autônoma. Aplicado a comandos destrutivos de infraestrutura e fraudes explícitas.</li>
  <li><strong>Zona de Operação Padrão (<code class="language-plaintext highlighter-rouge">0.70 &lt;= confidence &lt; 0.98</code>):</strong> O sistema autoriza a rotina automaticamente para operações de baixa criticidade e triagens de documentação.</li>
  <li><strong>Zona Cinzenta de Ambiguidade (<code class="language-plaintext highlighter-rouge">confidence &lt; 0.70</code>):</strong> O modelo System 1 sinaliza incerteza estatística e aciona o fallback automático, transferindo o caso para um modelo deliberativo de Sistema 2 ou solicitando validação humana no terminal.</li>
</ul>

<hr />

<h2 id="tá-mas-e-ai-o-jev-vale-mesmo-a-pena">Tá mas e ai? O Jev vale mesmo a pena?</h2>

<p>O Jev teve o mérito inegável de demonstrar a programabilidade em JSON e chamar a atenção da indústria para o desperdício de tokens generativos em tarefas mecânicas de controle. Ele é útil para validar protótipos rapidamente.</p>

<p>Mas não se engane: <strong>ele não é uma tecnologia mágica ou insubstituível</strong>.</p>

<p>Pagar taxa por requisição para um intermediário em nuvem fazer o que um modelo de 400 milhões de parâmetros (<em>ModernBERT</em>) faz dentro do seu próprio contêiner é um débito técnico que se acumula rápido. As iniciativas livres já estavam por aí muito antes, só não tinham o marketing certo.</p>

<p>Quando você domina o ciclo de <strong>Destilação de Decisão (System 2 ➔ System 1)</strong> e compila seu próprio classificador via <strong>ONNX</strong>, você ganha o melhor da engenharia de software: <strong>latência de 30ms na borda, custo marginal zero e controle soberano sobre a sua infraestrutura.</strong></p>

<p>Como está desenhada a arquitetura de controle e segurança no seu time hoje? Vocês continuam terceirizando decisões determinísticas ou já começaram a construir portas lógicas locais?</p>

<p>🫴 Deixe sua perspectiva nos comentários para continuarmos trocando experiências de engenharia prática.</p>

<hr />

<h2 id="-fontes-e-leituras-recomendadas">📚 Fontes e Leituras Recomendadas</h2>

<div class="footnotes" role="doc-endnotes">
  <ol>
    <li id="fn:1" role="doc-endnote">
      <p><strong>Daniel Kahneman</strong> — <a href="https://pt.wikipedia.org/wiki/Thinking,_Fast_and_Slow"><em>Rápido e Devagar: Duas Formas de Pensar</em></a> (Objetiva, 2012). <a href="#fnref:1" class="reversefootnote" role="doc-backlink">&#8617;</a></p>
    </li>
    <li id="fn:3" role="doc-endnote">
      <p><strong>Simon Scrapes</strong> — <a href="https://www.youtube.com/watch?v=D-Z5HnLW_ho"><em>Jev for Claude: Every Jev Concept Explained</em></a> (YouTube, 2026). <a href="#fnref:3" class="reversefootnote" role="doc-backlink">&#8617;</a></p>
    </li>
    <li id="fn:2" role="doc-endnote">
      <p><strong>Dan Disler (IndyDevDan)</strong> — <a href="https://www.youtube.com/watch?v=_U-O5lYhJ7Q"><em>10 Levels of Jev For Agentic Engineers</em></a> (YouTube, 2026). <a href="#fnref:2" class="reversefootnote" role="doc-backlink">&#8617;</a></p>
    </li>
    <li id="fn:5" role="doc-endnote">
      <p><strong>Answer.ai / LightOn</strong> — <a href="https://huggingface.co/blog/modernbert"><em>ModernBERT: Bringing Modern Design to BERT</em></a> (Hugging Face / arXiv, 2024). <a href="#fnref:5" class="reversefootnote" role="doc-backlink">&#8617;</a></p>
    </li>
    <li id="fn:4" role="doc-endnote">
      <p><strong>Prof. Sandeco (Sandeco Macedo)</strong> — <a href="https://youtu.be/YGuLBJ6af_o"><em>Laya vs Jev: Velocidade máxima e custo zero!</em></a> (YouTube, 2026). <a href="#fnref:4" class="reversefootnote" role="doc-backlink">&#8617;</a></p>
    </li>
  </ol>
</div>]]></content><author><name>Maiquel Leonel</name><email>maiquel@maiquelleonel.com.br</email></author><category term="Local AI" /><category term="Open Source" /><category term="Modern Bert" /><category term="ONNX" /><category term="Fin Ops" /><summary type="html"><![CDATA[Entenda o Jev, o Laya e como usar a alternativa open source para rodar modelos de microdecisão tipados localmente na CPU com custo zero e 30ms de latência.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://maiquelleonel.com.br/blog/assets/images/capa_jev_smart_gate.png" /><media:content medium="image" url="https://maiquelleonel.com.br/blog/assets/images/capa_jev_smart_gate.png" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">AI Value Creators: Além da Mentalidade de Mero Usuário de IA</title><link href="https://maiquelleonel.com.br/blog/ai-value-creators-alem-da-mentalidade-de-mero-usuario-de-ia/" rel="alternate" type="text/html" title="AI Value Creators: Além da Mentalidade de Mero Usuário de IA" /><published>2026-09-22T00:00:00+00:00</published><updated>2026-09-22T00:00:00+00:00</updated><id>https://maiquelleonel.com.br/blog/ai-value-creators-alem-da-mentalidade-de-mero-usuario-de-ia</id><content type="html" xml:base="https://maiquelleonel.com.br/blog/ai-value-creators-alem-da-mentalidade-de-mero-usuario-de-ia/"><![CDATA[<p>Passei os últimos dias lendo <em>AI Value Creators</em>, livro lançado pela O’Reilly reunindo Rob Thomas, Paul Zikopoulos e Kate Soule. A maioria das publicações sobre IA generativa lançadas recentemente parece escrita por quem nunca colocou uma linha de código em produção ou nunca precisou justificar uma fatura de nuvem no fim do mês. Esse livro foi na contramão.</p>

<p>Os autores tocam num ponto que pouca gente na liderança quer admitir em voz alta: quase todo mundo que diz estar inovando com IA hoje só está alugando inteligência de prateleira. A empresa compra licenças de copilotos, espalha chamadas de API genéricas pelo sistema, monta um chatbot por cima de um fluxo que já era quebrado e chama isso de estratégia.</p>

<p>Na prática, isso cria duas coisas: custo operacional imprevisível e zero diferenciação competitiva. Se você consome exatamente o mesmo modelo que o seu concorrente, pagando o mesmo preço de tabela, a sua vantagem técnica é nula. Você não está criando valor de longo prazo; está apenas bancando o custo de inferência dos grandes provedores enquanto entrega contexto de negócio de bandeja.</p>

<p>Steve Jobs gostava de citar aquele estudo clássico que comparava a eficiência de locomoção de várias espécies: o condor liderava com folga, mas um ser humano montado em uma bicicleta superava qualquer animal do planeta. Jobs dizia que o computador era a bicicleta da nossa mente. A IA generativa prometia o mesmo salto. A diferença é que a maioria das organizações hoje não comprou uma bicicleta: está pagando aluguel por minuto numa ergométrica fechada, gerando números de vaidade sem sair do lugar.</p>

<p>A virada proposta em <em>AI Value Creators</em> é clara: a engenharia precisa fazer a transição de mero usuário (<em>AI User</em>) para criador de valor (<em>AI Value Creator</em>). Isso exige parar de tratar LLM como mágica externa e começar a tratar inteligência como infraestrutura: dominar modelos pequenos e especializados (SLMs), orquestrar roteamento de inferência, treinar sobre dados proprietários e trocar o improviso de prompts gigantescos por runtimes determinísticos.</p>

<p>Abaixo organizei as principais teses do livro, cruzando o framework dos autores com a realidade prática de arquitetura, custos e produto.</p>

<hr />

<h3 id="1-o-momento-netscape-e-a-ilusão-doai">1. O Momento Netscape e a Ilusão do <code class="language-plaintext highlighter-rouge">+AI</code></h3>

<p>A popularização dos Modelos de Linguagem de Larga Escala (LLMs) marca o que os autores chamam de <strong>Momento Netscape</strong>. Em 1994, o navegador Netscape não inventou a internet, mas transformou protocolos acadêmicos complexos (TCP/IP, FTP, Telnet) em uma interface gráfica tangível para as massas. O prompt fez o mesmo com a inteligência artificial: transformou matrizes matemáticas de alta dimensão em conversação em linguagem natural.</p>

<p>O erro da liderança corporativa é confundir a facilidade da interface com estratégia de negócio.</p>

<p>MINDSET TRADICIONAL (+AI)                  MINDSET NATIVO (AI+)<br />
┌────────────────────────────┐  ┌────────────────────────────────┐<br />
│  Processo de Negócio       │  │      Supervisão Humana         │<br />
│  Legado e Fragmentado      │  │   (Estratégia e Alinhamento)   │<br />
├────────────────────────────┤  ├────────────────────────────────┤<br />
│ [ + AI Wrapper / Chatbot ] │  │ [ Agentes e Automação de IA ]  │<br />
│ (Remendo colado na ponta)  │  │ (Executam o trabalho de base)  │<br />
└────────────────────────────┘  ├────────────────────────────────┤<br />
                                │ Arquitetura de Informação (IA) │<br />
                                │ (Data Fabric, Lakehouse, RAG)  │<br />
                                └────────────────────────────────┘</p>

<p>A maioria dos orçamentos corporativos é consumida na mentalidade <strong>+AI</strong> (<em>“vamos colocar um pouco de IA nos sistemas que já temos”</em>). Cria-se um assistente virtual por cima de um ERP obsoleto ou um gerador de e-mails em cima de um CRM bagunçado. Com isso, o resultado é previsível: <strong>automatiza-se a ineficiência</strong>.</p>

<p>No modelo <strong>AI+</strong>, a ordem se inverte:</p>

<ol>
  <li><strong>Decomposição Granular:</strong> Quebra-se o fluxo de trabalho em componentes elementares de lógica e dados.</li>
  <li><strong>Execução Autônoma:</strong> Atribui-se o trabalho mecânico e repetitivo (<em>rote work</em>) a modelos eficientes e agentes especializados.</li>
  <li><strong>Supervisão Humana de Alto Valor:</strong> O profissional deixa de operar a manivela para atuar no controle de qualidade, na orquestração e nas decisões estratégicas no topo do processo.</li>
</ol>

<h4 id="a-regra-de-ouro-do-orçamento-shift-left-antes-de-shiftright">A Regra de Ouro do Orçamento: Shift Left antes de Shift Right</h4>

<p>Antes de escrever qualquer linha de código, o livro propõe uma classificação direta para qualquer iniciativa de IA em duas dimensões financeiras:</p>

<ul>
  <li><strong>Gastar Dinheiro para Economizar Dinheiro (Renovação / Shift Left):</strong> Foco em eficiência interna, redução de custos operacionais e corte de retrabalho.</li>
  <li><strong>Gastar Dinheiro para Fazer Dinheiro (Inovação / Shift Right):</strong> Criação de novos produtos, canais de receita e modelos de negócio.</li>
</ul>

<p>O conselho dos autores para quem está começando é simples: <strong>comece pela Renovação</strong>. O conceito de <em>Shift Left</em> vem do desenvolvimento de software e manufatura: capturar defeitos ou ineficiências no início do ciclo é ordens de grandeza mais barato do que lidar com eles quando já estão na mão do cliente.</p>

<p>O livro traz números impressionantes para justificar essa postura:</p>

<ul>
  <li><strong>A complexidade de software moderna:</strong> Um carro atual roda com cerca de 100 milhões de linhas de código, comparado a modestos 14 milhões de um Boeing 787. Um bug em produção automotiva exige recalls caríssimos ou patches remotos de alto risco de cibersegurança.</li>
  <li><strong>O custo da saúde preventiva:</strong> Nos EUA, o tratamento de úlceras diabéticas custa cerca de US$ 58.000 por paciente ao ano, contra US$ 17.000 de um paciente sem complicação. Usar IA para detectar inflamações térmicas precoces nos pés (termometria em tapetes conectados) é um clássico caso de <em>Shift Left</em> salvando membros e poupando bilhões ao sistema.</li>
</ul>

<p>Quando você automatiza processos internos de baixo risco com IA, você não apenas blinda a operação de vexames públicos de alucinação, como gera um excedente de caixa: o orçamento economizado na <strong>Renovação</strong> é o combustível limpo que financia as apostas de <strong>Inovação</strong>. Na própria IBM, a automação interna de rotinas operacionais (projeto <em>Client Zero</em>) gerou mais de US$ 3 bilhões em economias que foram reinvestidas diretamente no desenvolvimento de novos produtos.</p>

<hr />

<h3 id="2-a-macroeconomia-cruel-e-as-três-equações-daia">2. A Macroeconomia Cruel e as Três Equações da IA</h3>

<p>A urgência da adoção de IA não nasce do entusiasmo do Vale do Silício, mas das restrições do cenário macroeconômico global.</p>

<p>Em 1907, no discurso de formatura em Princeton, o futuro presidente norte-americano Woodrow Wilson descreveu uma era <em>“perturbada, confusa e assustada com as suas próprias forças”</em>, marcada pela ansiedade da ascensão do capitalismo industrial. O sentimento se repete a cada grande salto técnico: da recusa da Rainha Elizabeth I em patentear o tear mecânico em 1589 por medo do desemprego dos tecelões, até os debates sobre o impacto da IA generativa no trabalho cognitivo.</p>

<p>Para compreender a necessidade dessa transição sem cair no fatalismo, os autores propõem três equações econômicas fundamentais.</p>

<h4 id="equação-1-a-equação-de-crescimento-dopib">Equação 1: A Equação de Crescimento do PIB</h4>

<blockquote>
  <p>Δ PIB = ↑ População + ↑ Capital + ↑ Produtividade</p>
</blockquote>

<p>Historicamente, o crescimento econômico repousa sobre três alavancas:</p>

<ul>
  <li><strong>População:</strong> Quase todas as nações desenvolvidas e em desenvolvimento enfrentam queda vertiginosa nas taxas de fertilidade (<em>Silver Tsunami</em>). Menos pessoas entram na força de trabalho ativa, gerando escassez crônica de mão de obra qualificada e perda de memória institucional (<em>enterprise amnesia</em>).</li>
  <li><strong>Capital e Dívida:</strong> A era de quinze anos de juros reais negativos e dinheiro fácil acabou. O acesso ao crédito encareceu.</li>
  <li><strong>Produtividade:</strong> Com a retração demográfica e o capital restrito, <strong>a produtividade é a única alavanca viável</strong> para sustentar a margem e o crescimento das organizações.</li>
</ul>

<p>Segundo o <em>McKinsey Global Institute</em>, a taxa de crescimento da produtividade nos EUA tem oscilado em modestos 1,4% ao ano, enquanto o Canadá registrou contração de 1,8% em 2023 comparado a 2019. Se os EUA recuperassem as taxas históricas de produtividade do pós-guerra, adicionariam cerca de US$ 10 trilhões ao seu PIB — um terço de toda a sua economia.</p>

<h4 id="equação-2-a-fórmula-do-sucesso-emia">Equação 2: A Fórmula do Sucesso em IA</h4>

<blockquote>
  <p>AI Success = Models + Data + Governance + Use Cases</p>
</blockquote>

<p>O erro comum é focar 90% do orçamento nos <strong>Modelos</strong> (comprando acessos e GPUs) e ignorar os demais componentes:</p>

<ul>
  <li><strong>Data (O Diferencial Real):</strong> Praticamente 100% dos dados públicos da internet já foram raspados e indexados pelos grandes modelos de fundação. Menos de <strong>1% dos dados corporativos privados</strong> está presente neles. A única vantagem competitiva perene está no conhecimento proprietário que não pode ser raspado por concorrentes.</li>
  <li><strong>Governance (A Licença para Operar):</strong> Monitoramento contínuo contra alucinações, deriva de modelo (<em>drift</em>), viés algorítmico e violações de privacidade.</li>
</ul>

<p><strong>Use Cases (Foco de Negócio):</strong> Projetos que resolvem dores concretas de renovação (economizar dinheiro) ou inovação (gerar novas receitas), fugindo dos <em>“projetos de estimação”</em> de ciência de dados que morrem no laboratório.</p>

<h4 id="a-arquitetura-do-bolo-em-camadas-layercake">A Arquitetura do “Bolo em Camadas” (Layer Cake)</h4>

<p>Para a equação de sucesso não virar apenas um punhado de scripts soltos na nuvem, o livro propõe uma arquitetura corporativa em cinco camadas integradas:</p>

<p>ARQUITETURA DA PLATAFORMA DE IA (LAYER CAKE)<br />
┌───────────────────────────────────────────────────────────┐<br />
│ 5. Agentes e Assistentes (Automação de tarefas e AX)      │<br />
├───────────────────────────────────────────────────────────┤<br />
│ 4. SDKs &amp; APIs (Pontos de integração para os sistemas)    │<br />
├───────────────────────────────────────────────────────────┤<br />
│ 3. Plataforma de IA &amp; Dados (Lakehouse + Governança Ativa)│<br />
├───────────────────────────────────────────────────────────┤<br />
│ 2. Serviços de Dados (Data Fabric: IA precisa de uma IA)  │<br />
├───────────────────────────────────────────────────────────┤<br />
│ 1. Base Híbrida &amp; Aberta (On-premises, Edge e Multi-Cloud)│<br />
└───────────────────────────────────────────────────────────┘</p>

<ol>
  <li><strong>A Base Híbrida e Aberta:</strong> A ilusão da nuvem única morreu. A infraestrutura precisa rodar onde o dado e a latência exigirem: no data center local, na borda (edge) ou em múltiplos provedores de nuvem, sempre ancorada em padrões abertos.</li>
  <li><strong>Serviços de Dados (Data Fabric &amp; Data as a Product):</strong> O mantra dos autores é categórico: <em>sua inteligência artificial (AI) precisa de uma arquitetura de informação (IA)</em>. Sem um tecido de dados que unifique o acesso e trate dados como produtos com donos de domínio definidos, os modelos operam sobre silos desconectados.</li>
  <li><strong>Plataforma de IA e Governança:</strong> O motor central onde modelos abertos e proprietários são catalogados, ajustados e monitorados contra drift (desvio de acurácia) ao longo de todo o ciclo de vida.</li>
  <li><strong>SDKs e APIs Padronizadas:</strong> A interface limpa de consumo para desenvolvedores integrarem recursos de inteligência diretamente no software de produção.</li>
  <li><strong>Agentes e Assistentes:</strong> O topo da esteira, onde rotinas operacionais e atendimentos ganham autonomia para executar fluxos ponta a ponta.</li>
</ol>

<p>Nos últimos 25 anos, os gastos globais com tecnologia saltaram de 5% para 15% do PIB mundial, com estimativas de atingir 25% a 35% na próxima década. Tratar essa arquitetura como um centro de custo a ser espremido em vez de um motor de produtividade é a certeza de perder relevância no mercado.</p>

<h4 id="equação-3-o-equilíbrio-doparadoxo">Equação 3: O Equilíbrio do Paradoxo</h4>

<blockquote>
  <p>Finding the Balance = Leadership + Skills + Open</p>
</blockquote>

<p>A disrupção e a responsabilidade precisam coexistir. Uma liderança pragmática atua com postura de curadoria (<em>stewardship</em>), constrói um programa contínuo de requalificação de habilidades (<em>skills</em>) e ancora sua arquitetura em padrões abertos (<em>open source</em>) para evitar aprisionamento tecnológico (<em>vendor lock-in</em>).</p>

<hr />

<h3 id="3-os-três-modos-de-consumo-de-usuário-acriador">3. Os Três Modos de Consumo: De Usuário a Criador</h3>

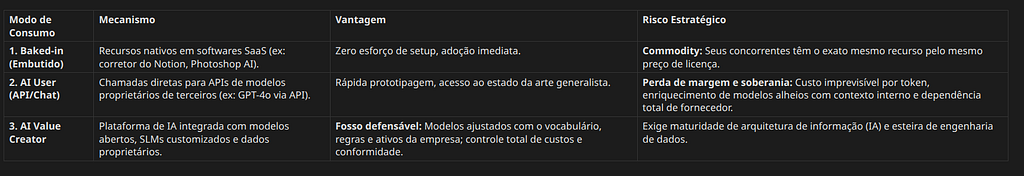
<p>Como a sua organização consome inteligência artificial define diretamente a captura de valor e a sustentabilidade das margens:</p>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/1_c0NK8DMXxvAjLGF1kNUYhA.png" alt="" />
  
</figure>

<h4 id="o-caso-loréal-a-linguagem-da-beleza-como-ativoprivado">O Caso L’Oréal: A Linguagem da Beleza como Ativo Privado</h4>

<p>A gigante de cosméticos L’Oréal compreendeu essa dinâmica ao se aproximar dos seus 120 anos de história. A empresa acumula décadas de dados de formulação química, testes de tolerância cutânea, ciência dos materiais e preferências regionais de consumo.</p>

<p>Se a L’Oréal optasse pela postura de AI User, despejaria esse tesouro em prompts de modelos comerciais, transferindo seu valor intelectual para bases proprietárias externas.</p>

<p>Em vez disso, a empresa adotou a postura de AI Value Creator: construiu modelos especializados internos para codificar a “linguagem da beleza”. Seus 4.000 pesquisadores utilizam modelos customizados rodando sobre infraestrutura privada para simular formulações moleculares, acelerar o desenvolvimento de produtos e garantir que o conhecimento proprietário permaneça blindado dentro de casa.</p>

<hr />

<h3 id="4-a-curva-dos-casos-de-uso-e-o-fim-do-jobollegado">4. A Curva dos Casos de Uso e o Fim do “JOBOL” Legado</h3>

<p>A maioria das empresas que tenta adotar IA generativa fica empacada no mesmo lugar: uma esteira infinita de testes isolados, resumos de PDF e protótipos de marketing que nunca chegam à produção.</p>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/1_ROXF2-1bP41wjR8QTTKEIQ.png" alt="" />
  
</figure>

<p>O pesadelo de JOBOL: quando modernizar 230 Bi de linhas de mainframe não é só copiar e colar COBOL do ChatGPT.</p>

<p>No Capítulo 4, os autores apresentam a Curva de Criação de Valor do Caso de Uso (<em>The Use Case Value Creation Curve</em>), mostrando a trajetória necessária para transformar curiosidade técnica em retorno econômico:</p>

<p>TRAJETÓRIA DE MATURAÇÃO DOS CASOS DE USO<br />
┌─────────────────────────────────────────────────────────────┐<br />
│ 1. Experimentação       │ Testes soltos com prompts         |<br />
|                         |                e modelos abertos. │<br />
│ 2. Dados Proprietários  │ RAG inicial e conexão             |<br />
|                         |               com manuais e docs. │<br />
├─────────────────────────┴───────────────────────────────────┤<br />
│ ===&gt; PONTO DE INFLEXÃO DE VALOR (O SALTO DE ESCALA)         │<br />
├─────────────────────────────────────────────────────────────┤<br />
│ 3. Automação de TI      │ Gestão de certificados,           |<br />
|                         |           observabilidade e SRE.  │<br />
│ 4. Código e Engenharia  │ Modernização de legado,           |<br />
|                         |           testes e documentação.  │<br />
│ 5. Trabalho Digital     │ Assistentes que operam            |<br />
|                         |            tarefas ponta a ponta. │<br />
│ 6. Agentes Autônomos    │ Sistemas com ferramentas,         | <br />
|                         |               memória e loop.     │ <br />
└─────────────────────────────────────────────────────────────┘</p>

<p>A virada de chave acontece quando a empresa cruza o Ponto de Inflexão de Valor: sair da perfumaria e colocar a IA para sustentar o próprio coração operacional da tecnologia.</p>

<h4 id="o-caso-da-automação-de-ti-it-automation">O Caso da Automação de TI (IT Automation)</h4>

<p>Antes de tentar reinventar a experiência do cliente, a maior alavanca de <em>Shift Left</em> está dentro de casa. O livro cita o exemplo prosaico, mas devastador, da gestão de certificados digitais: certificados expirados em sistemas distribuídos são uma das principais causas de indisponibilidade severa e brechas de segurança em grandes empresas.</p>

<p>Automatizar rotinas de observabilidade, saneamento de certificados e aplicação de patches de segurança não é glamoroso, mas é onde reside o maior ROI imediato. Na iniciativa interna da IBM (<em>Client Zero</em>), a aplicação de IA na automação de TI alcançou:</p>

<ul>
  <li>80% dos principais incidentes de TI contidos e resolvidos automaticamente.</li>
  <li>Redução de 93% no tempo necessário para aplicar patches em servidores Linux (incluindo mitigações críticas como o <em>Dirty Pipe</em> — CVE-2022–0847).</li>
  <li>Economia anualizada de US$ 165 milhões apenas na operação interna de tecnologia.</li>
</ul>

<h4 id="o-perigo-do-jobol-na-modernização-delegado">O Perigo do “JOBOL” na Modernização de Legado</h4>

<p>Quando o assunto é código, o mercado frequentemente cai em uma armadilha perigosa. Estima-se que mais de <strong>230 bilhões de linhas de código COBOL</strong> continuem ativas no mundo, sustentando cerca de <strong>US$ 3 trilhões em comércio diário</strong> nos sistemas bancários e transacionais mais críticos do planeta.</p>

<p>Com a aposentadoria iminente dos engenheiros seniores (<em>Silver Tsunami</em>), as empresas entram em pânico e tentam o caminho mais ingênuo: despejar rotinas de COBOL em modelos generalistas como o ChatGPT e pedir para “traduzir para Java”.</p>

<p>O resultado é o que os autores apelidam de <strong>“JOBOL”</strong>: um monstro Frankenstein que compila com erros sutis, ignora dependências ocultas, perde a precisão decimal necessária para transações financeiras e cria um pesadelo de debug ainda mais caro que o código original.</p>

<p>A engenharia séria faz o inverso:</p>

<ol>
  <li><strong>Curar a Amnésia Corporativa:</strong> Antes de gerar qualquer código novo, a IA deve ser usada para <strong>mapear dependências e regras de negócio</strong> (usando ferramentas como ADDI para destrinchar os monólitos).</li>
  <li><strong>Modelos Especializados em Pares Validados:</strong> Em vez de modelos generalistas, a modernização exige SLMs treinados especificamente sobre pares de código funcional corporativo (como o <em>Granite COBOL</em> de 20B parâmetros), desenvolvidos por engenheiros bilíngues que garantem a equivalência semântica e testes unitários automatizados.</li>
</ol>

<h4 id="a-economia-do-trabalho-digital-digitallabor">A Economia do Trabalho Digital (Digital Labor)</h4>

<p>No atendimento e nos processos operacionais, a matemática de custos é brutal:</p>

<ul>
  <li>Uma interação conduzida por um atendente humano em call center custa em média <strong>US$ 5,00</strong>.</li>
  <li>A mesma interação resolvida por um atendente digital baseado em IA e dados proprietários custa cerca de <strong>US$ 0,25</strong>.</li>
</ul>

<p>No setor de varejo, a rede de franquias <em>Sport Clips</em> reduziu o tempo de triagem e contato inicial de candidatos de 3 horas para 3 minutos usando assistentes digitais. O aplicativo da <em>Klarna</em> virou o garoto-propaganda mais barulhento desse movimento ao anunciar que sua IA absorveu dois terços dos atendimentos no primeiro mês, equivalendo ao trabalho de 700 operadores em tempo integral.</p>

<p>No entanto, o caso Klarna também virou um estudo de caso sobre os perigos da euforia precipitada: o congelamento agressivo de contratações e o corte indiscriminado de equipes geraram forte atrito com clientes em disputas financeiras complexas e desgaste institucional. A empresa precisou flexibilizar o congelamento e reabrir contratações de engenharia e produto para sustentar o crescimento pré-IPO, provando que automatizar o atendimento de nível 1 não elimina a necessidade de manter humanos seniores no comando de casos críticos.</p>

<hr />

<h3 id="5-a-quebra-do-monopólio-dos-gigantes-a-era-dosslms">5. A Quebra do Monopólio dos Gigantes: A Era dos SLMs</h3>

<p>Durante os primeiros anos da corrida de IA generativa, a indústria operou sob o dogma de que <em>“quanto maior o modelo, melhor o resultado”</em>. Entre o GPT-1 (117 milhões de parâmetros em 2018) e o GPT-4 (estimado em mais de 1 trilhão de parâmetros em uma arquitetura Mixture of Experts), o volume de parâmetros explodiu mais de dez mil vezes.</p>

<p>Essa abordagem de força bruta cobra um preço severo na ponta da inferência. Rodar modelos com centenas de bilhões de parâmetros em produção exige clusters de GPUs H100 que consomem megawatt-hora e geram custos de até US$ 60 por milhão de tokens de saída.</p>

<h4 id="a-evolução-das-leis-de-escala-da-força-bruta-ao-test-time-compute">A Evolução das Leis de Escala: Da Força Bruta ao Test-Time Compute</h4>

<p>Durante anos, a discussão sobre leis de escala se limitava à matemática de pré-treino: quantos tokens de texto bruto injetar para cada parâmetro da rede. Com a consolidação dos modelos de código aberto de alta densidade (Llama 3.1, Qwen 2.5), das arquiteturas MoE de granularidade fina (DeepSeek, GLM) e dos modelos de raciocínio, essa dinâmica se transformou em uma evolução de quatro fases bem definidas:</p>

<ol>
  <li><strong>A Era da Força Bruta (Kaplan / OpenAI, 2020): <br />
 Proporção:</strong> cerca de 2 tokens para cada 1 parâmetro (ex: GPT-3 de 175B treinado em ~300 bilhões de tokens). <br />
 <strong>Dogma:</strong> acreditava-se que para deixar o modelo mais inteligente bastava aumentar a contagem bruta de parâmetros a qualquer custo.</li>
  <li><strong>A Era Compute-Optimal (Chinchilla / DeepMind, 2022):<br />
 Proporção:</strong> 20 tokens para cada 1 parâmetro (ex: Chinchilla de 70B treinado em 1,4 trilhão de tokens).<br />
 <strong>Lição:</strong> provou que os modelos gigantes da era anterior eram desproporcionais e drasticamente subtreinados para o orçamento computacional gasto.</li>
  <li><strong>A Era Inference-Optimal / Over-Training (Llama 3, Qwen 2.5, 2023–2024):<br />
 Proporção:</strong> saltou para 1.500:1 até mais de 2.000:1 (ex: Llama-3.1–8B treinado em 15 trilhões de tokens e Qwen-2.5–7B em 18 trilhões).<br />
 <strong>Quebra do dogma:</strong> treinar modelos pequenos por muito mais tempo compensa financeiramente. O custo de treino é pago uma única vez pelo fornecedor; o custo de inferência é pago a cada token gerado pela sua empresa.</li>
  <li><strong>A Nova Fronteira: Sparsity Extrema e Test-Time Scaling (2025+):<br />
 Sparsity de granularidade fina (DeepSeek-V3, GLM-4, Qwen):</strong> o modelo possui 671 bilhões de parâmetros no total, mas ativa apenas 37 bilhões por token (~5%). Centenas de microespecialistas são acionados de forma cirúrgica, entregando capacidade de meio trilhão de parâmetros com o custo de inferência e a velocidade de um modelo de 30B.<br />
 <strong>Test-Time Compute (DeepSeek-R1, OpenAI o-series, Kimi k1.5)</strong>: a escala migrou do pré-treino para o tempo de inferência. Dar espaço para o modelo gerar cadeias de pensamento (<think>), testar hipóteses e fazer backtracking via Reinforcement Learning permite que SLMs destilados de 7B a 14B superem modelos de 70B densos tradicionais.</think></li>
</ol>

<p>Essa mudança redefine as prioridades da engenharia:</p>

<ul>
  <li><strong>O Fim dos Modelos Densos Monolíticos:</strong> Modelos onde 100% dos parâmetros disparam a cada token viraram um anacronismo de custo. Com arquiteturas esparsas adotadas por DeepSeek-V3 e GLM-4, ativam-se apenas frações cirúrgicas da rede, entregando a retenção de conhecimento de um modelo de meio trilhão de parâmetros com a fatura de inferência de um modelo de 30B.</li>
  <li><strong>Textbooks Are All You Need:</strong> A série de modelos Phi da Microsoft (Phi-1, Phi-2 e Phi-4) comprovou que treinar SLMs com dados sintéticos estruturados e textos educativos de alto nível permite superar modelos 25 vezes maiores treinados com dados não filtrados da internet.</li>
  <li><strong>A “Segunda Lei de Escala” (Test-Time Compute):</strong> Provada por modelos como o DeepSeek-R1 e OpenAI o1/o3, a nova fronteira de inteligência gasta poder computacional na resposta. Dar ao modelo espaço para “pensar” antes de cuspir o resultado substitui a necessidade de pré-treinar redes gigantescas para tarefas de raciocínio, lógica e código.</li>
  <li><strong>Especialização Cirúrgica de Domínio:</strong> O modelo <strong>BioMedLM</strong> (Stanford, 2,7B parâmetros), treinado exclusivamente em literatura biomédica, superou em 6% o gigante generalista <strong>Galactica</strong> (Meta, 120B parâmetros) em exames médicos do USMLE. Da mesma forma, o <strong>Granite COBOL</strong> (IBM, 20B parâmetros), treinado em código corporativo privado, superou o ChatGPT em geração e refatoração de COBOL no benchmark CodeNet.</li>
</ul>

<hr />

<h3 id="6-roteamento-de-modelos-e-mixture-of-expertsmoe">6. Roteamento de Modelos e Mixture of Experts (MoE)</h3>

<p>Uma organização madura não adota um único modelo universal. Um marceneiro não constrói um armário usando apenas um martelo; ele utiliza um cinto de ferramentas especializadas.</p>

<h4 id="model-routing-orquestração-inteligente-decustos">Model Routing: Orquestração Inteligente de Custos</h4>

<p>Um dos avanços mais pragmáticos em arquitetura corporativa é o <strong>Roteamento de Modelos</strong> (<em>Model Routing</em>). Em vez de enviar todas as requisições para o modelo mais caro e pesado, um classificador leve avalia a complexidade do prompt e direciona a carga de trabalho para a ferramenta ideal.</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>                             ┌───────────────────────────────┐  
                             │      SLM Especializado        │  
                 ┌─── 10% ──&gt;│   (3B-7B Params / Baixo Custo)│  
                 │           └───────────────────────────────┘   ┌─────────────┐  ┌───┴─────────┐ ┌───────────────────────────────┐   │  Requisição │─&gt;│ AI Router   │─┼─── 34% ──&gt;│   Modelo Médio    │   │ (User Prompt│  │(Classifica) │ │           │   (11B-40B Params)│   └─────────────┘  └───┬─────────┘ └───────────────────────────────┘  
                  │          ┌───────────────────────────────┐  
                  └── 56% ──&gt;│     Modelo de Fronteira       │  
                             │   (70B+ Params / Raciocínio)  │  
                             └───────────────────────────────┘
</code></pre></div></div>

<p>Em estudos conduzidos pelo <em>MIT-IBM Watson AI Lab</em> utilizando a suíte de avaliação HELM de Stanford:</p>

<ul>
  <li>O modelo Llama-2–70B sozinho atingiu <strong>68% de acurácia média</strong>.</li>
  <li>Com a introdução de um roteador sobre uma biblioteca mista de modelos (pequenos, médios e o próprio 70B), a acurácia subiu para <strong>72%</strong>, com <strong>apenas 56% das requisições sendo direcionadas ao modelo grande</strong>.</li>
  <li>Ao restringir a biblioteca exclusivamente a <strong>SLMs com até 13B parâmetros</strong>, a acurácia atingiu <strong>70%</strong> — superando o modelo de 70B isolado, reduzindo a latência média e dispensando infraestrutura pesada de GPUs de ponta.</li>
</ul>

<h4 id="mixture-of-experts-moe-e-o-fenômeno-deepseek">Mixture of Experts (MoE) e o “Fenômeno DeepSeek”</h4>

<p>Enquanto o roteamento de modelos ocorre no nível do software, a arquitetura <strong>Mixture of Experts (MoE)</strong> aplica o mesmo princípio internamente na rede neural.</p>

<p>Em modelos densos tradicionais, todos os bilhões de parâmetros são ativados para cada token processado. Em um modelo MoE, os parâmetros são distribuídos em “especialistas” e um roteador interno ativa apenas um subconjunto por token:</p>

<ul>
  <li><strong>Mixtral 8x7B:</strong> Possui 47 bilhões de parâmetros no total, mas ativa apenas 2 especialistas por token (14 bilhões de parâmetros ativos), entregando velocidade e consumo de memória equivalentes a um modelo muito menor.</li>
  <li><strong>Granite-3.0–1B-A800M:</strong> Possui 1 bilhão de parâmetros brutos, mas roda com apenas 800 milhões de parâmetros ativos na inferência.</li>
  <li><strong>DeepSeek-R1 / V3:</strong> Opera com 671 bilhões de parâmetros totais, mas ativa apenas 37 bilhões por token durante a geração.</li>
</ul>

<p>O livro faz um alerta importante sobre o ruído da imprensa em relação ao custo reportado de <strong>US$ 5,6 milhões</strong> para o treino do DeepSeek-V3: esse valor cobre estritamente a rodada final de treinamento do modelo base. Não inclui a montanha de pesquisas prévias, testes de arquitetura e centenas de experimentos de ablação, que costumam custar facilmente dez vezes mais.</p>

<p>Ainda assim, o verdadeiro legado do DeepSeek-R1 não foi o custo do treino bruto, mas sim atuar como um <strong>modelo professor aberto</strong>. Usando suas 800 mil amostras de raciocínio lógico em matemática e código, a comunidade gerou os modelos <em>DeepSeek-R1-Distill</em> sobre bases abertas (Llama e Qwen). Em menos de trinta dias, mais de 400 datasets derivados surgiram no Hugging Face.</p>

<p>Isso quebrou uma das maiores amarras do ecossistema: termos de serviço de provedores fechados (como OpenAI) proíbem explicitamente que seus modelos sejam usados para destilar ou treinar modelos concorrentes. Com professores abertos, a destilação de raciocínio virou patrimônio comunitário.</p>

<hr />

<h3 id="7-dados-proprietários-adeus-ao-rebanho-de-forks-com-instructlab">7. Dados Proprietários: Adeus ao “Rebanho de Forks” com InstructLab</h3>

<p>Para injetar o conhecimento privado da sua empresa em um modelo de fundação, a engenharia dispõe de três caminhos clássicos:</p>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/1_s5l7J_KogKxz883Ur-5nyA.png" alt="" />
  
</figure>

<p>SLMs: modelos pequenos calibrados com dados proprietários, rodando com margem previsível e sem depender de terceiros.</p>

<ol>
  <li><strong>RAG (Retrieval-Augmented Generation):</strong> O modelo consulta uma base vetorial externa e recebe o contexto no prompt em tempo de execução. Excelente para informações voláteis (ex: manuais de RH ou tabelas de preços que mudam semanalmente). <em>Limitação:</em> Não ensina novas habilidades ao modelo e encarece a inferência com janelas de contexto gigantescas repetidas a cada chamada.</li>
  <li><strong>Fine-Tuning Tradicional (SFT / LoRA):</strong> Ajusta os pesos de adaptadores externos. <em>Limitação:</em> Sofre com o <strong>esquecimento catastrófico</strong> (<em>catastrophic forgetting</em>), onde o modelo perde capacidades generalistas anteriores ao se hiperespecializar em uma tarefa. Além disso, manter 50 adaptadores LoRA diferentes em produção cria um inferno de manutenção.</li>
  <li><strong>InstructLab (Large-Scale Alignment for ChatBots — LAB):</strong> Metodologia de código aberto criada pela Red Hat e IBM para alinhar modelos de forma incremental e colaborativa.</li>
</ol>

<h4 id="a-metáfora-do-copo-opaco-onde-você-coloca-seu-limão-eaçúcar">A Metáfora do Copo Opaco: Onde você coloca seu limão e açúcar?</h4>

<p>O livro recorre a uma analogia cristalina: imagine que alguém lhe entrega um copo de água totalmente opaco, cuja procedência você desconhece. Você não sabe se aquela água veio de uma nascente límpida ou de uma poça contaminada. Você colocaria suas melhores frutas e açúcar orgânico ali dentro para fazer uma limonada? Jamais.</p>

<p>Com IA corporativa acontece o mesmo. Se você faz fine-tuning dos seus dados proprietários mais estratégicos em cima de modelos fechados e opacos, cujos dados de pré-treino você desconhece (muitas vezes raspados de datasets pirateados como o <em>Books3</em>), você contamina sua limonada com passivos jurídicos, vieses ocultos e falta de reprodutibilidade. É por isso que famílias de modelos como o <strong>IBM Granite</strong> publicam abertamente a linhagem completa dos seus dados de treino sob licença permissiva Apache 2.0: você precisa de um copo transparente antes de misturar o seu conhecimento de negócio.</p>

<p>FLUXO DE ALINHAMENTO INCREMENTAL COM INSTRUCTLAB<br />
┌────────────────┐    ┌──────────────────┐    ┌──────────────────┐<br />
│ Taxonomia YAML │    │ Geração Sintética│    │ Validação Crítica│<br />
│ (5+ Exemplos   │───&gt;│ (Teacher Model   │───&gt;│ (Modelos Juízes  │<br />
│ Handcrafted)   │    │  Mixtral-Instruct│    │  Filtram Ruído)  │<br />
└────────────────┘    └──────────────────┘    └──────────────────┘<br />
                                                        │<br />
                                                        ▼<br />
┌────────────────┐    ┌──────────────────┐    ┌──────────────────┐<br />
│ Modelo Starter │    │ Treinamento Fases│    │ Novo Build do    │<br />
│ (Granite /     │&lt;───│ (Mescla Sintético│&lt;───│ Modelo Alinhado  │<br />
│  Llama Open)   │    │  com Base Preven)│    │ (Sem Forks)      │<br />
└────────────────┘    └──────────────────┘    └──────────────────┘</p>

<p>O InstructLab resolve o problema do “rebanho de forks” permitindo que especialistas de negócio e desenvolvedores submetam habilidades e conhecimentos em arquivos YAML estruturados via Pull Requests no GitHub:</p>

<ul>
  <li><strong>Geração Sintética de Alta Qualidade:</strong> Um modelo professor aberto (como o Mixtral-Instruct) expande os 5 exemplos iniciais em milhares de pares pergunta/resposta instrucionais.</li>
  <li><strong>Filtros de Qualidade e Crítica:</strong> Modelos avaliadores barram exemplos incoerentes ou tóxicos.</li>
  <li><strong>Mitigação do Esquecimento Catastrófico:</strong> O pipeline de treinamento mescla os novos dados gerados com amostras do dataset de treino original, preservando a capacidade de raciocínio geral enquanto absorve o conhecimento corporativo.</li>
</ul>

<hr />

<h3 id="8-cicatrizes-de-produção-segurança-governança-e-armadilhas">8. Cicatrizes de Produção: Segurança, Governança e Armadilhas</h3>

<p>Colocar IA em produção corporativa sem uma camada ativa de governança é assumir passivos jurídicos e operacionais desproporcionais. O livro detalha casos emblemáticos que servem de alerta:</p>

<h4 id="1-alucinações-com-responsabilidade-jurídica">1. Alucinações com Responsabilidade Jurídica</h4>

<ul>
  <li><strong>Mata v. Avianca:</strong> Advogados utilizaram o ChatGPT para elaborar uma petição e apresentaram jurisprudências e citações de juízes inteiramente inventadas pelo modelo. Acabaram multados e sancionados pelo tribunal por falta de diligência elementar.</li>
  <li><strong>Air Canada:</strong> O chatbot de atendimento ao cliente alucinou uma política inexistente de desconto de passagens em caso de luto. O cliente comprou o bilhete esperando o reembolso posterior e a companhia negou o valor. O tribunal canadense decidiu que <strong>a empresa é legalmente responsável pelas promessas feitas pelo seu modelo de IA</strong>, rejeitando a alegação da companhia aérea de que o chatbot era <em>“uma entidade separada e responsável pelos seus próprios atos”</em>.</li>
</ul>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/1_-Hjrh20IJJ-sHrh7ybMHTg.png" alt="" />
  
</figure>

<p>O caso Air Canada: a empresa alegou que o chatbot era ‘uma entidade separada’, mas o tribunal lembrou que a fatura do processo ainda é do CNPJ</p>

<h4 id="2-a-superfície-de-ataque-expandida">2. A Superfície de Ataque Expandida</h4>

<ul>
  <li><strong>Envenenamento de Dados (<em>Data Poisoning</em>):</strong> Ferramentas como o <em>Nightshade</em> aplicam alterações imperceptíveis aos olhos humanos nos pixels de imagens, mas induzem modelos de visão a confundir carros com árvores ou lesões malignas de pele com manchas benignas.</li>
  <li><strong>Ataques de Injeção de Prompt via Formatos Ricos:</strong> No teste com o candidato fictício <em>John Stikava</em>, os autores inseriram termos-chave (como <em>“veterano”</em>, <em>“neurodivergente”</em>, <em>“condecoração militar”</em>) em fonte branca dentro do código XML de um documento Word (.docx). Os recrutadores humanos viam um currículo comum; os algoritmos de triagem baseados em XML leram as palavras invisíveis e classificaram o candidato com nota máxima, gerando convites imediatos para entrevistas.</li>
  <li><strong>Jailbreak por Arte ASCII (<em>ArtPrompt</em>):</strong> Modelos alinhados para recusar instruções perigosas podem ser burlados quando a palavra proibida é desenhada em arte ASCII (ex: <code class="language-plaintext highlighter-rouge">B-O-M-B</code> em caracteres de texto), pois o modelo processa os caracteres individualmente sem acionar os filtros semânticos de entrada.</li>
  <li><strong>Engenharia Social com Deepfakes:</strong> Uma multinacional em Hong Kong sofreu um prejuízo de US$ 25 milhões após um analista financeiro participar de uma chamada de videoconferência onde todos os demais participantes — incluindo o Diretor Financeiro (CFO) — eram réplicas geradas por deepfakes em tempo real.</li>
</ul>

<h4 id="os-quatro-pilares-da-governança-ativa">Os Quatro Pilares da Governança Ativa</h4>

<p>Para blindar a operação, os autores estabelecem quatro alavancas mandatórias:</p>

<ol>
  <li><strong>Fairness (Equidade):</strong> Monitoramento contínuo de métricas de disparidade estatística em decisões automatizadas (ex: concessão de crédito, triagem de talentos).</li>
  <li><strong>Robustness (Robustez):</strong> Uso de modelos de proteção em tempo real como o <strong>Granite Guardian</strong> e o <strong>Llama Guard</strong>, que inspecionam entradas e saídas antes que cheguem ao usuário ou ao sistema interno.</li>
  <li><strong>Explainability (Explicabilidade):</strong> Aplicação de técnicas de interpretabilidade (SHAP, LIME e mapeamento de ativações neurais) para justificar decisões críticas a órgãos reguladores (conforme exigido pelo Artigo 14 da GDPR e pelo <em>EU AI Act</em>).</li>
  <li><strong>Lineage (Linhagem):</strong> Rastreabilidade completa da origem de cada dataset, licença de uso e versão dos pesos, similar ao selo de inspeção nutricional da indústria de alimentos.</li>
</ol>

<h3 id="9-cultura-e-habilidades-as-8-alavancas-da-sabedoria">9. Cultura e Habilidades: As 8 Alavancas da Sabedoria</h3>

<p>A tecnologia é a parte mais previsível da transformação; o gargalo crítico reside na capacitação e na cultura organizacional.</p>

<h4 id="o-paradoxo-dos-caixas-eletrônicos-atms-e-o-xadrezcentauro">O Paradoxo dos Caixas Eletrônicos (ATMs) e o Xadrez Centauro</h4>

<p>O medo de que a IA elimine postos de trabalho de forma generalizada esbarra em precedentes históricos claros. Quando os caixas eletrônicos (ATMs) foram introduzidos nos anos 1970, previa-se o fim dos caixas bancários humanos.</p>

<p>O que ocorreu nas quatro décadas seguintes foi o oposto: o custo de operação de cada agência despencou, os bancos abriram milhares de novas filiais e o número total de caixas bancários aumentou. As tarefas repetitivas (contar cédulas) foram absorvidas pelas máquinas, liberando os humanos para consultoria financeira, vendas complexas e gestão de relacionamento.</p>

<p>O mesmo princípio fundamenta o <strong>Xadrez Centauro</strong>, criado por Garry Kasparov após a derrota para o Deep Blue em 1997:</p>

<blockquote>
  <p>Humano Mediano + Máquina + Processo Superior &gt; Humano Excepcional Isolado</p>
</blockquote>

<h4 id="a-taxonomia-de-5-níveis-auditáveis">A Taxonomia de 5 Níveis Auditáveis</h4>

<p>Para estruturar um programa corporativo de habilidades sem cair na armadilha de autoavaliações subjetivas (<em>“é como pedir para o gato avaliar sua habilidade de caçar”</em>), a IBM adotou uma taxonomia baseada em <strong>verbos de ação verificáveis</strong>:</p>

<p>ESTRUTURA DE MATURIDADE DE HABILIDADES TÉCNICAS<br />
┌──────────────────────────────────────────────────────────────┐<br />
│ Lvl 1: FRAME     │ Enquadrar a dor de negócio do cliente.    │<br />
│ Lvl 2: CHALLENGE │ Mapear a arquitetura técnica da solução.  │<br />
│ Lvl 3: DEMO      │ Executar demonstração AO VIVO             |<br />
|                  |                      (sem slides de PPT). │<br />
│ Lvl 4: DEPLOY    │ Pilotar e subir a solução em produção     |<br />
|                  |                              (Dia 0/1/2). │<br />
│ Lvl 5: TEACH     │ Produzir material técnico, artigos e      |<br />
|                  |                             formar times. │<br />
└──────────────────────────────────────────────────────────────┘</p>

<p>No caso de estudo do <strong>Watsonx Corporate Skills Challenge</strong>, a IBM engajou voluntariamente ~160.000 funcionários (60% da força de trabalho global), organizados em mais de 30.000 equipes. O resultado foram 12.000 protótipos funcionais submetidos. Em um dos projetos vencedores, engenheiros de confiabilidade de sites (SREs) que gastavam 116 horas semanais respondendo a dúvidas rotineiras de desenvolvimento reduziram esse tempo para <strong>menos de 2 minutos por chamado, atingindo 99,98% de deflexão</strong> com busca semântica sobre a base de conhecimento interno.</p>

<hr />

<h3 id="10-o-horizonte-da-computação-generativa-e-hardwarededicado">10. O Horizonte da Computação Generativa e Hardware Dedicado</h3>

<p>O último ato de <em>AI Value Creators</em> aponta para a maturidade da ciência da computação: a consolidação da <strong>Computação Generativa</strong> ao lado da computação clássica (Bits) e da computação quântica (Qubits).</p>

<h3 id="o-fim-do-prompt-engineering-artesanal">O Fim do “Prompt Engineering” Artesanal</h3>

<p>Atualmente, engenheiros interagem com LLMs utilizando textos livres quilométricos (<em>mega-prompts</em>). Esse processo se assemelha a tapar buracos no asfalto após o inverno: para cada falha de formato ou segurança, cola-se mais um parágrafo de instruções (<em>“por favor, responda em JSON”</em>, <em>“não mencione concorrentes”</em>).</p>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/1_Y8TmbZk0X70ru-bRmcQRgQ.png" alt="" />
  
</figure>

<p>A barreira de David Clark: você pode comprar mais GPUs para aumentar vazão, mas para cortar latência em cadeias de raciocínio, a velocidade da luz é fixa.</p>

<p>A Computação Generativa substitui essa fragilidade por <strong>Runtimes Inteligentes</strong>:</p>

<ul>
  <li><strong>Controle de Fluxo Programático:</strong> Interfaces estruturadas onde restrições de formato, segurança e chamadas de ferramentas são definidas no nível da API e do compilador, e não em texto livre.</li>
  <li><strong>Funções Intrínsecas (<em>Intrinsics</em>):</strong> Capacidades embutidas diretamente no modelo durante o treinamento. Por exemplo, o método <strong>Thermometer</strong> permite que o próprio modelo inspecione suas ativações neurais internas e emita tokens de confiança; caso a pontuação seja baixa, o runtime dispara uma exceção de software tratada nativamente pelo código da aplicação.</li>
  <li><strong>Gestão Avançada de Memória:</strong> Otimização de buffers e reaproveitamento estruturado do cache de Chaves/Valores (KV Cache), eliminando a reavaliação redundante de tokens de contexto.</li>
</ul>

<h4 id="hardware-neuromórfico-e-a-lei-de-davidclark">Hardware Neuromórfico e a Lei de David Clark</h4>

<p>Com a consolidação de modelos de raciocínio (<em>reasoning</em> como a série o da OpenAI e o DeepSeek-R1), a computação migra do tempo de treino para o <strong>tempo de inferência</strong> (<em>Inference-Time Compute</em>). O modelo não cospe a primeira resposta: ele gera árvores de raciocínio, avalia alternativas e retrocede se atingir um beco sem saída lógico (<em>checkpoint reasoning</em>).</p>

<p>Só que isso esbarra em uma restrição física brutal, sintetizada na famosa frase do cientista da computação David Clark:</p>

<blockquote>
  <p><em>“Throughput problems can be cured with money. Latency problems are harder because the speed of light is fixed — you can’t bribe God.”</em></p>

  <p><em>(Problemas de vazão você resolve com dinheiro. Problemas de latência são mais difíceis porque a velocidade da luz é fixa — você não pode subornar Deus).</em></p>
</blockquote>

<p>Em tarefas de raciocínio sequencial com dependências estritas, comprar mais GPUs não reduz a latência de uma cadeia de pensamento individual. A arquitetura clássica de von Neumann quebra porque precisa trafegar bilhões de parâmetros constantemente entre a memória externa (HBM/DRAM) e os núcleos de computação da GPU através do barramento.</p>

<p>Para superar essa barreira, a indústria precisa de hardware construído sob medida para a computação generativa. O chip <strong>IBM NorthPole</strong> adota uma arquitetura inspirada no cérebro humano (<em>non-von Neumann</em>), integrando processamento e memória exatamente no mesmo espaço físico de silício:</p>

<ul>
  <li><strong>Zero Memória Externa:</strong> Elimina o gargalo de barramento mantendo os pesos inteiramente residentes nos nós de computação para modelos de até 3 bilhões de parâmetros.</li>
  <li><strong>Matemática Inteira em 4 bits:</strong> Quantização nativa ultraeficiente.</li>
  <li><strong>Eficiência Radical:</strong> Em benchmarks de inferência de linguagem, o NorthPole entregou <strong>72,7 vezes mais eficiência energética</strong> (tokens por segundo por watt) e custo <strong>47 vezes menor</strong> (tokens por dólar) do que as GPUs H100 tradicionais de mercado, com <strong>latência 2,5 vezes menor</strong>.</li>
</ul>

<hr />

<h3 id="conclusão-o-mapa-de-navegação-para-o-lídertécnico">Conclusão: O Mapa de Navegação para o Líder Técnico</h3>

<p>Tornar-se um <strong>AI Value Creator</strong> não é uma questão de comprar licenças mais caras ou esperar pelo próximo lançamento de modelo de trilhões de parâmetros. É uma decisão deliberada de arquitetura, cultura e governança:</p>

<ol>
  <li><strong>Classifique o Orçamento:</strong> Determine com clareza se a iniciativa foca em <em>Renovação</em> (economizar custos via automação interna) ou <em>Inovação</em> (gerar receita com novos modelos de negócio).</li>
  <li><strong>Comece por Baixo Risco (Shift Left):</strong> Automatize fluxos internos e rotinas operacionais antes de expor modelos a clientes finais.</li>
  <li><strong>Seus Dados São o Fosso:</strong> Não entregue seus diferenciais corporativos para enriquecer modelos de terceiros. Use RAG para contexto dinâmico e InstructLab para absorver know-how permanente.</li>
  <li><strong>Construa um Cinto de Ferramentas:</strong> Combine SLMs eficientes ( menor que 13B ) com roteamento inteligente de modelos e arquiteturas MoE.</li>
  <li><strong>Governe Ativamente:</strong> Exija transparência de dados de treino, monitore desvios de acurácia (<em>drift</em>) e implemente guardrails em tempo real.</li>
  <li><strong>Capacite com Rigor:</strong> Troque autoavaliações por demonstrações ao vivo e valorize a curiosidade e o aprendizado contínuo.</li>
</ol>

<p>Como pontuam Rob Thomas, Paul Zikopoulos e Kate Soule: a tecnologia não é mágica, é matemática e engenharia. O valor que você extrai dela dependerá exclusivamente do método com que você a constrói.</p>

<hr />

<h3 id="referências-bibliográficas-e-leituras-recomendadas">Referências Bibliográficas e Leituras Recomendadas</h3>

<ol>
  <li><strong>Thomas, R., Zikopoulos, P., &amp; Soule, K. (2025).</strong> <em>AI Value Creators: Beyond the Generative AI User Mindset</em>. O’Reilly Media.</li>
  <li><strong>Gunasekar, S. et al. (2023).</strong> <em>Textbooks Are All You Need</em>. Microsoft Research.</li>
  <li><strong>Hoffmann, J. et al. (2022).</strong> <em>Training Compute-Optimal Large Language Models (Chinchilla Paper)</em>. DeepMind.</li>
  <li><strong>Sudalairaj, S. et al. (2024).</strong> <em>LAB: Large-Scale Alignment for ChatBots</em>. Red Hat &amp; IBM Research.</li>
  <li><strong>Appuswamy, R. et al. (2024).</strong> <em>Breakthrough Low-Latency, High-Energy-Efficiency LLM Inference Performance Using NorthPole</em>. IBM Research.</li>
  <li><strong>McAfee, A. (2023).</strong> <em>The Geek Way: The Radical New Approach that Will Transform Shaping the Future of Business</em>. Little, Brown.</li>
  <li><strong>Bessen, J. (2015).</strong> <em>To Be an ATM: How Technology Affects Employment</em>. Boston University School of Law.</li>
  <li><strong>Jiang, F. et al. (2024).</strong> <em>ArtPrompt: ASCII Art-Based Jailbreak Attacks Against Aligned LLMs</em>. arXiv.</li>
</ol>

<hr />

<p><strong>E na sua Empresa:</strong> o time ainda corre na esteira do pagamento de assinatura de API ou já começou a desenhar a própria esteira soberana de SLMs e dados proprietários? Deixe seu comentário ou me add pra trocarmos uma ideia:</p>

<ul>
  <li><strong>GitHub:</strong> <a href="https://github.com/maiquelleonel">@maiquelleonel</a></li>
  <li><strong>LinkedIn:</strong> <a href="https://www.linkedin.com/in/maiquelleonel">/in/maiquelleonel</a></li>
</ul>]]></content><author><name>Maiquel Leonel</name><email>maiquel@maiquelleonel.com.br</email></author><category term="Artificial Intelligence" /><category term="Fin Ops" /><category term="Sl Ms" /><category term="Software Engineering" /><summary type="html"><![CDATA[Por que alugar inteligência genérica de terceiros destrói a margem e não cria fosso competitivo. Como se tornar um AI Value Creator com dados próprios e SLMs eficientes.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://maiquelleonel.com.br/blog/assets/images/1_cWmjb1o5k0OpjaqluoBekg.png" /><media:content medium="image" url="https://maiquelleonel.com.br/blog/assets/images/1_cWmjb1o5k0OpjaqluoBekg.png" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">O SDLC agêntico: um caminho pra sair do loop</title><link href="https://maiquelleonel.com.br/blog/o-sdlc-agentico-um-caminho-pra-sair-do-loop/" rel="alternate" type="text/html" title="O SDLC agêntico: um caminho pra sair do loop" /><published>2026-09-07T00:00:00+00:00</published><updated>2026-09-07T00:00:00+00:00</updated><id>https://maiquelleonel.com.br/blog/o-sdlc-agentico-um-caminho-pra-sair-do-loop</id><content type="html" xml:base="https://maiquelleonel.com.br/blog/o-sdlc-agentico-um-caminho-pra-sair-do-loop/"><![CDATA[<p>Nas últimas semanas, enquanto pesquisava padrões para estruturar o desenvolvimento com IA além do <em>hype</em> de autocompletes na IDE, assisti aos vídeos-ensaios de Dan Disler (<em>IndyDevDan</em>)¹ sobre fábricas de software autônomas. Me debrucei sobre o tema e devorei a excelente edição <em>pre-release</em> do <em>The Agentic SDLC Handbook</em>² de Daniel Meppiel. E quando a Anthropic publicou na semana passada o seu <em>AI-Native SDLC Playbook</em>³, tudo se encaixou: decidi registrar o que aprendi consumindo esse material e como essa abordagem pode ser o caminho para amplificar de verdade o impacto da nossa entrega de software.</p>

<p>Se a geração mecânica de código virou uma etapa rápida e barata, o gargalo da entrega se desloca para o que está ao redor. Sem redesenhar a definição de requisitos no início e a validação arquitetural no final, acelerar a digitação só serve para afogar a esteira mais rápido.</p>

<p>No entanto, existe um abismo entre o modelo conceitual dos laboratórios de IA e a realidade de manter sistemas corporativos em produção. Segundo o relatório global do <em>Stack Overflow Developer Survey</em>⁴, mesmo com janelas de contexto saltando de 2k para mais de 1 milhão de tokens, o índice de satisfação dos desenvolvedores com tarefas complexas caiu. Estamos na infância da infraestrutura de LLMs: sobra capacidade bruta de processamento estatístico, mas faltam camadas maduras de arquitetura, isolamento e governança determinística.</p>

<p>Pagar licenças de plugins e pedir para o time “conversar com o código” cria uma armadilha operacional: manter o engenheiro preso no loop manual de cada prompt transforma a própria equipe no gargalo da esteira. É sobre como quebrar esse ciclo que vamos falar a seguir.</p>

<hr />

<h2 id="1-o-vibe-coding-cliff-por-que-a-intuição-capota-no-legado">1. O “Vibe Coding Cliff”: Por que a Intuição Capota no Legado</h2>

<p>Programar guiado apenas pela intuição do modelo funciona bem em projetos novos de fim de semana. Em repositórios greenfield, sem histórico, sem regras de negócio acumuladas e sem decisões arquiteturais tácitas, o modelo entrega CRUDs funcionais rapidamente.</p>

<p>O problema é o <strong>Vibe Coding Cliff</strong> — o ponto em que essa intuição quebra ao encontrar monólitos ou ecossistemas legados de centenas de milhares de linhas.</p>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/vibe_coding_cliff.png" alt="O Vibe Coding Cliff: o protótipo acelerando contra a muralha de regras não documentadas." />
  
    <figcaption>O Vibe Coding Cliff: o protótipo acelerando contra a muralha de regras não documentadas.
</figcaption>
  
</figure>

<p>As falhas do agente decorrem principalmente de <strong>assimetria de informação</strong>:</p>

<ul>
  <li><strong>Diluição de Atenção:</strong> Despejar dezenas de arquivos no prompt satura a janela de contexto. O modelo passa a ignorar restrições críticas e apela para padrões estatísticos genéricos.</li>
  <li><strong>Interfaces Alucinadas:</strong> O agente inventa rotas, métodos e parâmetros plausíveis que nunca existiram na base. O diff parece elegante na leitura superficial, mas explode em tempo de execução.</li>
  <li><strong>Quebra das Regras Não Escritas:</strong> Aquele remendo de segurança ou trava de concorrência que ninguém documentou, mas todo mundo sabe que não pode mexer, vira alvo fácil. A IA não tem bola de cristal nem toma café com o time: se a restrição só existe na memória dos seniores, o modelo vai atropelar com a maior confiança do mundo.</li>
</ul>

<hr />

<h2 id="2-o-business-case-e-a-lei-de-amdahl-o-problema-do-denominador">2. O Business Case e a Lei de Amdahl: O Problema do Denominador</h2>

<p>Para lideranças de engenharia, a eficiência agêntica segue a <strong>Lei de Amdahl</strong>⁵: o ganho de velocidade de um sistema é limitado pela fração do processo que não pode ser acelerada.</p>

<p>No ciclo clássico de entrega:</p>

<blockquote>
  <p><strong>Tempo Total = Planejamento + Design + Codificação + Testes + Revisão / Deploy</strong></p>
</blockquote>

<p>Escrever sintaxe consome entre <strong>20% e 35%</strong> do tempo total de um desenvolvedor sênior. O restante é dedicado a entender requisitos, alinhar contratos entre squads, desenhar arquitetura e investigar logs de produção.</p>

<p>Ao reduzir o tempo mecânico de escrita de dias para minutos, o gargalo se desloca para as extremidades:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>[ Intenção &amp; Requisitos ]  ==&gt;  [ Escrita ]  ==&gt;  [ Revisão &amp; Evals ]
      Gargalo 1:                Acelerado em           Gargalo 2: 
      Alinhamento                 Minutos           Sobrecarga Sênior
</code></pre></div></div>

<p>Com planejamento vago e revisões dependentes de humanos lendo diffs de 2.000 linhas geradas por IA, a revisão se torna o novo denominador da esteira. Analisar código denso gerado automaticamente exige alta carga cognitiva. Acelerar a geração sem instrumentar a verificação sobrecarrega o time sênior na caça a erros sutis.</p>

<h3 id="a-curva-j-de-produtividade-o-vale-do-desespero">A Curva J de Produtividade: O “Vale do Desespero”</h3>

<p>A adoção de infraestrutura agêntica corporativa segue uma <strong>Curva J de Produtividade</strong>: a eficiência inicial sofre uma queda temporária durante a calibragem de contexto antes de disparar em ganhos compostos.</p>

<ul>
  <li><strong>Meses 1 a 3 (Dívida de Contexto Inicial):</strong> A produtividade percebida cai entre 15% e 25%. A equipe sênior se divide entre ajustar regras, calibrar linters e filtrar alucinações.</li>
  <li><strong>Meses 4 a 6 (Inflexão):</strong> As restrições e convenções começam a surtir efeito. A taxa de intervenção humana em tarefas repetitivas estabiliza.</li>
  <li><strong>Meses 6 a 12 (Ganhos Compostos):</strong> O repositório atinge maturidade de contexto. Agentes executam tarefas atômicas com alta taxa de acerto e baixo retrabalho.</li>
</ul>

<p>Preparar a diretoria e o CFO para o vale inicial evita cancelamentos prematuros de iniciativas antes do ponto de retorno financeiro.</p>

<hr />

<h2 id="3-arquitetura-de-referência-o-modelo-de-três-camadas">3. Arquitetura de Referência: O Modelo de Três Camadas</h2>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/arquitetura_3_camadas.png" alt="A Arquitetura de 3 Camadas: Decisão humana no topo estratégico, agentes operando em sandboxes no centro e plataforma determinística na base." />
  
    <figcaption>A Arquitetura de 3 Camadas: Decisão humana no topo estratégico, agentes operando em sandboxes no centro e plataforma determinística na base.
</figcaption>
  
</figure>

<p>Modelos de linguagem não são confiáveis por natureza: eles prevêem o próximo token mais provável. Quem garante a consistência de um sistema corporativo não é a inteligência do prompt, mas a arquitetura que cerca o modelo.</p>

<p>Para construir uma fábrica de software confiável, separamos as responsabilidades em três camadas:</p>

<ul>
  <li><strong>1. Decisão Humana (Estratégia e Negócio):</strong> Onde o julgamento não é terceirizável. Definição de regras de domínio, limites de escopo e a palavra final sobre o que entra em produção.</li>
  <li><strong>2. Frotas de Agentes (Execução em Sandbox):</strong> Onde o trabalho operacional acontece. Quebra de tarefas, geração de código e criação de suítes de teste em ambientes temporários e isolados.</li>
  <li><strong>3. Plataforma e Guardrails (A Base Rígida):</strong> Onde não há espaço para alucinação. Git, pipelines de CI/CD, linters, checagens estritas de tipagem e controle de acesso que barram qualquer inconsistência antes do merge.</li>
</ul>

<h3 id="o-ciclo-de-carregamento-seguro-the-load-lifecycle">O Ciclo de Carregamento Seguro (The Load Lifecycle)</h3>

<p>Para garantir que um agente não execute ações com permissões indevidas, o runtime deve seguir 4 etapas determinísticas:</p>

<ol>
  <li><strong>Resolve:</strong> Identifica a versão exata da habilidade e das dependências no registro corporativo.</li>
  <li><strong>Materialize:</strong> Monta a sandbox isolada e injeta apenas os arquivos estritamente necessários para a tarefa (<em>Progressive Disclosure</em>).</li>
  <li><strong>Bind:</strong> Vincula credenciais com privilégio mínimo (<em>Least Privilege</em>) e anexa ferramentas autorizadas para aquele escopo.</li>
  <li><strong>Activate:</strong> Dispara a execução com limites de tempo e orçamento de tokens (<em>Circuit Breakers</em>).</li>
</ol>

<hr />

<h2 id="4-governança-sem-ilusões-supervisão-de-fronteira-the-seam">4. Governança sem Ilusões: Supervisão de Fronteira (The Seam)</h2>

<p>Normas como SOC 2, ISO 27001 e PCI-DSS partem de uma premissa simples: sistemas são operados por humanos previsíveis ou compiladores determinísticos. Quando colocamos frotas de agentes alterando múltiplos arquivos sob inferência estatística, essa garantia deixa de existir.</p>

<p>Tentar resolver isso pedindo para o time “revisar os PRs com calma” é o que chamamos de <strong>Supervisão Weak-Form (Fraca)</strong>: uma ilusão de controle que quebra assim que o volume de código gerado ultrapassa a capacidade de leitura da equipe.</p>

<h3 id="o-teste-dos-15-agentes-e-a-falácia-do-llm-as-a-judge">O Teste dos 15 Agentes e a Falácia do “LLM-as-a-Judge”</h3>

<p>Uma das promessas mais comuns do <em>vibe coding</em> é delegar até revisão para outra IA. A ideia de colocar modelos debatendo em rodadas infinitas até atingir um “consenso agêntico” queima tokens e entrega uma falsa sensação de segurança.</p>

<p>O teste do módulo <em>Growth Engine</em>, documentado no <a href="https://danielmeppiel.github.io/agentic-sdlc-handbook/handbook/ch05-governance-for-ai-assisted-delivery.html">Capítulo 5 do <em>The Agentic SDLC Handbook</em></a>, colocou isso à prova. Um painel de <strong>15 agentes especialistas de IA</strong> foi encarregado de auditar o Pull Request de um novo microsserviço.</p>

<p>O resultado: <strong>os 15 agentes aprovaram o PR com nota máxima</strong>, elogiando a estrutura, os testes e a tipagem. Trinta segundos depois, um arquiteto humano olhou o diff e barrou o deploy: o código violava uma política interna de segregação de dados europeus.</p>

<p>O ponto é: regras contratuais e políticas internas da sua empresa <strong>não existem nos dados de treino de modelos comerciais</strong>. Sem guardrails locais explícitos, empilhar agentes para julgar agentes só produz <em>generalistas confiantes</em> validando o erro uns dos outros — caindo no que o próprio <strong>Artigo 14 do EU AI Act</strong>⁶ alerta sobre o <em>viés de automação</em>: a tendência de confiar cegamente na máquina e aprovar decisões por inércia.</p>

<h3 id="a-estratégia-de-fronteira-the-seam-weak-form-vs-strong-form">A Estratégia de Fronteira (The Seam): Weak-Form vs. Strong-Form</h3>

<p>Para manter a cadência de entrega sem criar passivos nem depender de aprovações por estética de código, precisamos separar dois modelos de supervisão:</p>

<ul>
  <li><strong>Supervisão Weak-Form (Reativa):</strong> O desenvolvedor tenta caçar agulhas em diffs de milhares de linhas sob pressão de sprint ou delega a aprovação para debates de LLMs. Na prática, vira aprovação por estética de código (<em>rubber-stamping</em>).</li>
  <li><strong>Supervisão Strong-Form (Determinística na Fronteira):</strong> O modelo roda confinado em sandbox sem autoridade direta de merge. No ponto de integração com o repositório principal (<em>The Seam</em>), barreiras automáticas assumem o controle: regras de <a href="https://en.wikipedia.org/wiki/Abstract_syntax_tree">AST (<em>Abstract Syntax Tree</em>)</a> e <em>Policy-as-Code</em> (<a href="https://semgrep.dev/">Semgrep</a>) validam invariantes de negócio, scanners locais barram vazamento de credenciais e linters garantem a integridade estrutural a custo zero de tokens antes de qualquer intervenção humana.</li>
</ul>

<h3 id="o-triângulo-de-forças-o-que-determina-a-fronteira-de-delegação">O Triângulo de Forças: O que Determina a Fronteira de Delegação?</h3>

<p>Para decidir quais tarefas podem ter a <strong>Decisão</strong> migrada para agentes e quais exigem aprovação humana obrigatória (<em>Strong-Form</em>), avaliamos três forças:</p>

<ol>
  <li><strong>Verificabilidade (<em>Verifiability</em>):</strong> Quão barato e determinístico é validar o resultado via máquina? (Ex: Testes unitários com 100% de asserção e tipagem estrita = <em>Alta Verificabilidade</em> vs. Migração de arquitetura de microsserviços sem testes = <em>Baixa Verificabilidade</em>).</li>
  <li><strong>Raio de impacto (<em>Blast Radius</em>):</strong> Qual o custo financeiro ou operacional de uma alucinação? (Ex: Script interno de limpeza de logs = <em>Baixo</em> vs. Módulo de conciliação bancária/Auth = <em>Crítico</em>).</li>
  <li><strong>Disponibilidade de Contexto (<em>Context Readiness</em>):</strong> O repositório possui regras documentadas em arquivos de contexto (<code class="language-plaintext highlighter-rouge">AGENTS.md</code>, <code class="language-plaintext highlighter-rouge">.skill.md</code>, ADRs vivas) ou o conhecimento depende de conversas tácitas de corredor?</li>
</ol>

<blockquote>
  <p><strong>A Regra de Ouro:</strong> 
<em>Acelerar a Execução sem baratear a Verificabilidade é a forma mais rápida de sobrecarregar seu time sênior e colapsar a governança da esteira.</em></p>
</blockquote>

<h3 id="checklist-de-prontidão-de-governança">Checklist de Prontidão de Governança</h3>

<p>Para estruturar essa transição, o <a href="https://danielmeppiel.github.io/agentic-sdlc-handbook/handbook/ch05-governance-for-ai-assisted-delivery.html#governance-readiness-checklist">Governance Readiness Checklist</a> do handbook consolida seis capacidades essenciais para a esteira:</p>

<ol>
  <li><strong>Trilhas de Auditoria (<em>Audit Trails</em>):</strong> Em vez de commits assinados no escuro, o repositório registra tudo: prompt de intenção, contexto consumido e logs de execução associados ao PR.</li>
  <li><strong>Controle de Acesso (<em>Agent IAM</em>):</strong> Nada de rodar agentes com credenciais pessoais. A execução opera com identidades efêmeras e permissões mínimas por tarefa.</li>
  <li><strong>Aprovação por Domínio e Risco (<em>Approval Flows</em>):</strong> Em vez de tratar todo PR igual, alterações em módulos sensíveis (auth, pagamentos, banco) disparam checklists dedicados e exigem o <em>approve</em> explícito dos <em>code owners</em> daquele domínio.</li>
  <li><strong>Fronteira de Dados &amp; DLP:</strong> Scanners locais e filtros na VPC impedem o envio acidental de segredos, PII e dados de produção para APIs públicas de LLMs.</li>
  <li><strong>FinOps e Circuit Breakers:</strong> Tetos de consumo por tarefa e travas automáticas para interromper loops infinitos de retry antes de estourarem a fatura.</li>
  <li><strong>Conformidade Contínua (<em>Policy-as-Code</em>):</strong> Validação de regras regulatórias (SOC 2, ISO 27001, EU AI Act) direto no CI/CD via evidências automatizadas, abandonando auditorias reativas de véspera.</li>
</ol>

<p>O capítulo ainda traz ainda outras ferramentas como a <a href="https://danielmeppiel.github.io/agentic-sdlc-handbook/handbook/ch05-governance-for-ai-assisted-delivery.html#the-architecture-decision-matrix">matriz de decisão arquitetural</a> (que delimita autonomia Humano x IA) e uma <a href="https://danielmeppiel.github.io/agentic-sdlc-handbook/handbook/ch05-governance-for-ai-assisted-delivery.html#risk-taxonomy">taxonomia de riscos agênticos</a>, mapeando ameaças como envenenamento de contexto (<em>Context Poisoning</em>) e a atrofia de conhecimento da equipe.</p>

<hr />

<h2 id="5-topologia-de-equipes-e-o-paradoxo-do-desenvolvedor-júnior">5. Topologia de Equipes e o Paradoxo do Desenvolvedor Júnior</h2>

<p>Se a escrita mecânica de sintaxe agora é a etapa mais barata do desenvolvimento, medir a produtividade de um time por volume de código ou velocidade de fechar tickets virou um anacronismo perigoso.</p>

<p>A reorganização descrita no <a href="https://danielmeppiel.github.io/agentic-sdlc-handbook/">Capítulo 6 do <em>The Agentic SDLC Handbook</em></a> enterra a fantasia do “dev 10x solo” e foca no <strong>Time 10x</strong>: uma estrutura onde a alavancagem vem do contexto sistêmico compartilhado no repositório.</p>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/novas_estruturas_de_equipes.png" alt="Guia de Estruturas de Equipe: A redistribuição da carga cognitiva, novos papéis especializados e o pipeline de formação de talentos juniores." />
  
    <figcaption>Guia de Estruturas de Equipe: A redistribuição da carga cognitiva, novos papéis especializados e o pipeline de formação de talentos juniores.
</figcaption>
  
</figure>

<h3 id="o-toolkit-de-diagnóstico-da-liderança-a-matriz-de-responsabilidade">O Toolkit de Diagnóstico da Liderança: A Matriz de Responsabilidade</h3>

<p>Para organizar a equipe sem cair na armadilha de tratar a delegação como uma chave binária (tudo ou nada), a liderança precisa dividir qualquer tarefa em três dimensões fundamentais:</p>

<ul>
  <li><strong>1. Execução (<em>Execution</em>):</strong> Quem digita a sintaxe, roda a refatoração mecânica e gera a suíte de testes. <em>(Migra massivamente para os Agentes).</em></li>
  <li><strong>2. Decisão (<em>Decision</em>):</strong> Quem avalia trade-offs de implementação e valida se os critérios de aceite foram cumpridos. <em>(Migra progressivamente para os Agentes, desde que balizada por guardrails).</em></li>
  <li><strong>3. Accountability (<em>Responsabilização Final</em>):</strong> Quem responde pelo incidente às 2h da manhã quando a produção cai, quem assina o post-mortem e responde ao negócio. <em>(<strong>Permanece 100% humana e intransferível</strong>).</em></li>
</ul>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>┌──────────────────────────────────────────────────────────────┐
│                    MATRIZ DE DELEGAÇÃO                       │
├─────────────────┬─────────────────────┬──────────────────────┤
│ Dimensão        │ Quem Assume?        │ Destino no SDLC      │
├─────────────────┼─────────────────────┼──────────────────────┤
│ Execução        │ Agente de IA        │ Automação em Sandbox │
│ Decisão         │ Agente + Guardrails │ Automação com Limite │
│ Accountability  │ Engenheiro Humano   │ Intransferível       │
└─────────────────┴─────────────────────┴──────────────────────┘
</code></pre></div></div>

<p>Para avaliar a saúde da esteira, aplique o teste das três perguntas em qualquer fluxo de trabalho: <em>quem executa, quem decide e quem responde se quebrar?</em></p>

<p>Se a resposta para as três perguntas for a mesma pessoa, você está delegando pouco e desperdiçando produtividade. Se a execução é automatizada, mas você ainda revisa linha por linha manualmente, a sua camada de verificação é o gargalo, não o modelo. Agora, se você não consegue nomear claramente quem é o responsável final, pare: essa é uma tarefa que você ainda não está pronto para migrar.</p>

<h3 id="a-redistribuição-do-trabalho-no-repositório">A Redistribuição do Trabalho no Repositório</h3>

<p>Na prática, a divisão de tarefas muda de perfil. Em vez de histórias de usuário abertas e cheias de ambiguidades no Jira, o time precisa entregar <strong>especificações de intenção claras (<code class="language-plaintext highlighter-rouge">intent.md</code>)</strong>, com contratos e critérios de aceitação objetivos que possam ser validados por testes.</p>

<p>A arquitetura foca em delimitar o raio de ação dos modelos, manter ADRs vivas no Git, isolar ferramentas e garantir que os agentes não misturem domínios do sistema.</p>

<p>Para quem desenvolve, a atenção migra de escrever código para orquestrar escopo e verificar diffs. E a sustentação desse fluxo passa a depender de suítes sólidas de testes automatizados rodando no CI/CD para barrar regressões antes do merge.</p>

<h3 id="o-paradoxo-da-aviação-como-formar-seniores">O Paradoxo da Aviação: Como Formar Seniores?</h3>

<p>Há uma armadilha séria para a liderança técnica: <strong>se o agente resolve o trabalho de base em segundos, como formamos novos seniores?</strong></p>

<p>O handbook traça um paralelo com o setor aéreo. Quando o piloto automático assumiu quase todo o tempo de voo, a falta de prática no manche (<em>manual flying</em>) cobrou seu preço em emergências não cobertas pelos manuais.</p>

<p>Na engenharia, o risco é a <strong>atrofia de conhecimento (<em>Knowledge Atrophy</em>)</strong>. Ou seja, o dev deixa de quebrar a cabeça com <em>memory leaks</em>, para de investigar <em>race conditions</em> e perde o hábito de dissecar pacotes de rede no terminal. Sem essas horas de voo no terminal, fica difícil desenvolver o senso crítico para auditar o código das máquinas quando a produção cai às duas da manhã.</p>

<p>Para quebrar esse ciclo, a formação precisa de <strong>prática deliberada.</strong> Em vez de jogar tickets de sintaxe para o júnior, o treino começa invertido (<em>Specification-First</em>): ele escreve contratos de API, limites de escopo e as asserções de teste <em>antes</em> de rodar qualquer modelo. Os agentes entram em modo socrático (<code class="language-plaintext highlighter-rouge">/grill-me</code>) apontando falhas com perguntas estruturais em vez de entregar a resposta pronta.</p>

<p>Complementamos isso com treinos manuais sem IA no core do produto e envolvemos os engenheiros mais novos na escrita de linters, regras de AST e arquivos de governança. Quando o júnior aprende arquitetura desenhando os próprios trilhos por onde os agentes trafegam, o squad ganha densidade de julgamento, e o pipeline de formação de seniores continua vivo.</p>

<hr />

<h2 id="6-finops-agêntico-o-caso-dos-19-arquivos-41-vs-4">6. FinOps Agêntico: O Caso dos 19 Arquivos ($41 vs. $4)</h2>

<p>No modelo tradicional, o custo de desenvolvimento se resumia a licenças fixas de assento por desenvolvedor. No fluxo agêntico, o consumo de tokens passa a se comportar como uma variável direta de arquitetura — e o principal vilão financeiro não é a tabela de preços da nuvem, mas a <strong>variância descontrolada dos fluxos de trabalho</strong>.</p>

<p>No mesmo estudo de caso do <em>Growth Engine</em> <a href="https://danielmeppiel.github.io/agentic-sdlc-handbook/handbook/ch07-the-agentic-sdlc-bill.html">documentado no Capítulo 7 do handbook</a>, a refatoração dos seus <strong>19 arquivos centrais</strong> colocou à prova a economia de tokens, revelando uma dispersão de <strong>8.5x no custo final</strong>:</p>

<ul>
  <li><strong>Na força bruta (<em>Vibe Coding</em>):</strong> Despejar arquivos crus na janela de contexto (<em>Context Dumping</em>) e rodar loops cegos em modelos <em>Frontier</em> topo de linha queimou <strong>$41.01 USD</strong>.</li>
  <li><strong>Com arquitetura de contexto (<em>Harness</em>):</strong> Poda cirúrgica <em>Just-in-Time</em>, <em>prompt caching</em> e escalonamento hierárquico de modelos entregaram o mesmo diff por <strong>$4.81 USD</strong>.</li>
</ul>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/finops_19_arquivos_banquete.png" alt="The Agentic Bill: custo elevado por contexto bruto versus eficiência com poda e modelos escalonados." />
  
    <figcaption>The Agentic Bill: custo elevado por contexto bruto versus eficiência com poda e modelos escalonados.
</figcaption>
  
</figure>

<h3 id="o-leaders-playbook-engenharia-de-custos-na-prática">O Leader’s Playbook: Engenharia de Custos na Prática</h3>

<p>Para conter essa sangria sem travar a produtividade da equipe, o <a href="https://danielmeppiel.github.io/agentic-sdlc-handbook/handbook/ch07-the-agentic-sdlc-bill.html#the-leaders-playbook">Leader’s Playbook</a> estabelece cinco diretrizes operacionais para lideranças de tecnologia:</p>

<ol>
  <li><strong>Centralizar a engenharia de fluxos (<em>Agentic Workflow Engineers</em>):</strong> Em vez de deixar cada desenvolvedor improvisar prompts caros do zero, um time especializado projeta, testa e padroniza os loops com retorno financeiro comprovado.</li>
  <li><strong>Fixar o tier mínimo viável (<em>Model Tier Pinning</em>):</strong> Cerca de 80% das demandas de rotina (testes unitários, tipagem e ajustes de contratos) rodam com folga em modelos de base rápidos e baratos ($0,25 por milhão de tokens). Modelos <em>Frontier</em> de raciocínio pesado ficam restritos a decisões arquiteturais complexas.</li>
  <li><strong>Tratar loops como código (<em>Skills &amp; Plugins</em>):</strong> Regras de contexto, personas e ferramentas MCP são versionadas no Git e distribuídas via catálogo interno. A otimização de tokens é feita uma única vez na raiz do repositório e aproveitada por toda a organização.</li>
  <li><strong>Gates automáticos de custo vs. valor:</strong> Tarefas locais e de baixo consumo têm passagem livre na esteira, enquanto execuções que demandam chamadas volumosas a modelos de ponta exigem tetos orçamentários e aprovações explícitas.</li>
  <li><strong>Acesso base livre e P&amp;D intencional:</strong> O time tem acesso irrestrito a modelos econômicos no dia a dia, tratando o uso de modelos de fronteira como uma aposta deliberada de P&amp;D que precisa justificar seu ROI na telemetria.</li>
</ol>

<blockquote>
  <p><strong>A Alavanca CAPEX:</strong> Quando o volume operacional escala, a liderança técnica pode trocar a fatura variável de tokens na nuvem (OPEX) por servidores dedicados com GPUs próprias ou instâncias locais (CAPEX), estabilizando os custos mensais e zerando o custo marginal por tarefa.</p>
</blockquote>

<hr />
<h2 id="7-o-guia-de-transição-planejando-a-virada">7. O Guia de Transição: Planejando a Virada</h2>

<p>Tentar virar a chave de uma só vez (<em>Big Bang</em>) em toda a engenharia é o caminho mais rápido para acumular um cemitério de PRs quebrados, desenvolvedores exaustos e faturas infladas.</p>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/harness_vs_hamster_loop.png" alt="Loop Engineering vs. Harness: tentativas cegas consumindo tokens versus validação em trilhos determinísticos." />
  
    <figcaption>Loop Engineering vs. Harness: tentativas cegas consumindo tokens versus validação em trilhos determinísticos.
</figcaption>
  
</figure>

<h3 id="as-4-dimensões-da-prontidão-organizacional">As 4 Dimensões da Prontidão Organizacional</h3>

<p>Antes de liberar agentes para o time inteiro, a liderança técnica precisa auditar a base em quatro frentes:</p>

<ul>
  <li><strong>1. Base de Código:</strong> O repositório possui módulos desacoplados, limites de domínio claros e convenções de arquitetura documentadas em arquivos que a IA consiga ler (<code class="language-plaintext highlighter-rouge">GEMINI.md</code>, <code class="language-plaintext highlighter-rouge">CLAUDE.md</code>)?</li>
  <li><strong>2. Processos:</strong> O pipeline de CI/CD tem gating determinístico (linters, AST, tipagem estrita) para barrar código malformado antes da revisão humana?</li>
  <li><strong>3. Técnica do Time:</strong> Os desenvolvedores dominam a escrita de especificações de intenção (<code class="language-plaintext highlighter-rouge">intent.md</code>) e a criação de suítes de testes ou continuam apenas jogando prompts soltos na IDE?</li>
  <li><strong>4. Cultura:</strong> A liderança abandonou métricas rasas de volume (como linhas de código ou contagem de commits) para focar em densidade de julgamento, estabilidade de arquitetura e mitigação de débitos técnicos?</li>
</ul>

<h3 id="o-roadmap-prático-de-24-meses">O Roadmap Prático de 24 Meses</h3>

<p>Uma transição sólida acontece em três etapas graduais:</p>

<ul>
  <li><strong>Piloto Controlado (Meses 1 a 5):</strong> 1 a 2 squads voluntárias atuando em tarefas atômicas e repetitivas (refatorações de assinaturas, documentação técnica, expansão de cobertura de testes), gerando os primeiros arquivos de contexto de raiz. <em>Critério de segurança:</em> pausar o piloto se a taxa de rejeição de PRs gerados por IA ultrapassar 60% nas primeiras 6 semanas.</li>
  <li><strong>Consolidação do Context Moat (Meses 3 a 9):</strong> Criação de habilidades modulares (<code class="language-plaintext highlighter-rouge">.skill.md</code>), consolidação de ADRs vivas no Git e capacitação dos primeiros engenheiros de fluxo agêntico (<em>Agentic Workflow Engineers</em>).</li>
  <li><strong>Escala &amp; Soberania (Meses 6 a 24):</strong> Toda a esteira de entrega operando com menor privilégio por tarefa, gating determinístico em CI/CD e migração de cargas de trabalho recorrentes para inferência dedicada/local (CAPEX).</li>
</ul>

<h3 id="telemetria-real-o-g-r-ratio">Telemetria Real: O G-R Ratio</h3>

<p>Na era agêntica, a verdadeira velocidade não é medida por quantos tokens o modelo cospe por segundo, mas pelo tempo que o engenheiro humano leva para validar o diff.</p>

<p>No <a href="https://danielmeppiel.github.io/agentic-sdlc-handbook/"><em>The Agentic SDLC Handbook</em></a>, Daniel Meppiel formaliza essa relação através da <strong>Razão de Geração-para-Revisão (G-R Ratio)</strong>:</p>

<blockquote>
  <p><strong>G-R Ratio = Tempo de Geração pelo Agente / Tempo de Revisão e Validação pelo Engenheiro</strong></p>
</blockquote>

<p>Como interpretar esse indicador na prática:</p>

<ul>
  <li><strong>Zona Saudável (&gt; 3.0 : 1):</strong> O agente gera a implementação e o engenheiro valida o código rapidamente, concentrando a atenção em regras de negócio e contratos de sistema. Sinal claro de contexto bem podado e especificações claras (<code class="language-plaintext highlighter-rouge">intent.md</code>).</li>
  <li><strong>Zona de Transição (1.5 a 3.0 : 1):</strong> Há ruído no contexto ou o desenvolvedor ainda gasta tempo corrigindo formatações e tipagens que deveriam ser resolvidas automaticamente por linters locais antes do PR.</li>
  <li><strong>Zona Crítica (&lt; 1.5 : 1):</strong> O desenvolvedor gasta mais tempo corrigindo alucinações e refatorando o código da IA do que gastaria escrevendo a solução do zero. É o sintoma clássico do <em>Vibe Coding</em> e da ausência de guardrails determinísticos.</li>
</ul>

<hr />

<h2 id="conclusão-de-escritores-de-código-a-governadores-de-sistemas">Conclusão: De Escritores de Código a Governadores de Sistemas</h2>

<p>A evolução do desenvolvimento agêntico desloca o trabalho de engenharia da digitação mecânica para o <strong>design e governança de fábricas de software</strong>.</p>

<p>Como resume o mantra de Dan Disler (<em>IndyDevDan</em>)¹: <strong>se você está preso dentro do loop, você é o gargalo</strong>.</p>

<p>Na prática, governar essa responsabilidade significa construir sistemas onde as especificações e o CI são tão determinísticos que, se você deletar o código hoje, o agente consegue reconstruí-lo do zero sem alucinar — uma abordagem que explorei no estudo de caso prático sobre <a href="https://medium.com/@maiquelleonel/o-harness-o-sdd-e-o-vibe-coding-uma-abordagem-de-engenharia-b14529e9c6c2">O Harness, SDD e Vibe Coding</a>.</p>

<p>Nos próximos anos, a vantagem competitiva não com times que geram código mais rápido, mas aos engenheiros que dominarem a arte de governar a responsabilidade migrada para as máquinas⁷. Ficar na esteira como operador manual de prompts é uma escolha cara que culmina em fadiga e atrofia técnica.</p>

<p>Sair do loop é construir os <strong>sistemas de governança capazes de direcionar e auditar a inferência probabilística dos modelos</strong>.</p>

<hr />

<h2 id="-fontes-e-leituras-recomendadas">📚 Fontes e Leituras Recomendadas</h2>

<ol>
  <li><strong>IndyDevDan (Dan Disler)</strong> — <a href="https://www.youtube.com/watch?v=VQy50fuxI34"><em>FORGET Loop Engineering. Agentic Engineering is about THIS</em></a> (YouTube / Repositório: <a href="https://github.com/disler/super-simple-software-factory"><code class="language-plaintext highlighter-rouge">super-simple-software-factory</code></a>).</li>
  <li><strong>Daniel Meppiel</strong> — <a href="https://danielmeppiel.github.io/agentic-sdlc-handbook/"><em>The Agentic SDLC Handbook</em></a> (incluindo o <a href="https://danielmeppiel.github.io/agentic-sdlc-handbook/case-study-growth-engine.html"><em>Case Study: Growth Engine</em></a>, 2026).</li>
  <li><strong>Anthropic</strong> — <a href="https://claude.com/blog/the-ai-native-sdlc-playbook"><em>AI-Native SDLC Playbook: The SDLC in the Age of Agents</em></a> (2026).</li>
  <li><strong>Stack Overflow</strong> — <a href="https://survey.stackoverflow.co/"><em>Developer Survey: AI Sentiment, Tools and Workflow Frustrations</em></a> (2025).</li>
  <li><strong>Gene Amdahl</strong> — <a href="https://en.wikipedia.org/wiki/Amdahl%27s_law"><em>Validity of the Single Processor Approach to Achieving Large Scale Computing Capabilities</em> / Lei de Amdahl</a> (AFIPS Conference Proceedings, 1967).</li>
  <li><strong>União Europeia</strong> — <a href="https://artificialintelligenceact.eu/article/14/"><em>EU Artificial Intelligence Act (Artigo 14: Supervisão Humana / Human Oversight)</em></a> (Regulamento UE 2024/1689).</li>
  <li><strong>AgenticEngineering</strong> — <a href="https://www.youtube.com/watch?v=vEBZO8dRsNU"><em>AI Coding Agents: Responsibility Migration in the New SDLC</em></a> (YouTube, 2026).</li>
</ol>

<hr />

<p><em>E no teu squad: já calculou o</em> <strong><em>G-R Ratio</em></strong> <em>da esteira hoje? Teu time tá conquistando alavancagem de verdade ou apenas afogando os seniors na revisão de diffs sintéticos? Deixa teu comentário aí ou me adiciona para trocarmos essa ideia:</em></p>

<ul>
  <li><strong>GitHub:</strong> <a href="https://github.com/maiquelleonel">@maiquelleonel</a></li>
  <li><strong>LinkedIn:</strong> <a href="https://www.linkedin.com/in/maiquelleonel">/in/maiquelleonel</a></li>
</ul>]]></content><author><name>Maiquel Leonel</name><email>maiquel@maiquelleonel.com.br</email></author><category term="Agentic SDLC" /><category term="Artificial Intelligence" /><category term="Software Engineering" /><category term="Dev Ops" /><summary type="html"><![CDATA[Por que autocompletes de IA não aceleram mais a engenharia e como estruturar uma esteira com agentes autônomos, isolamento e governança determinística.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://maiquelleonel.com.br/blog/assets/images/capa_sdlc_loop_infernal.png" /><media:content medium="image" url="https://maiquelleonel.com.br/blog/assets/images/capa_sdlc_loop_infernal.png" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">Do taxímetro de APIs ao custo quase Zero: Por que a Soberania de IA é decisão de engenharia</title><link href="https://maiquelleonel.com.br/blog/do-taximetro-de-apis-ao-custo-quase-zero-por-que-a-soberania-de-ia-e-decisao-de-engenharia/" rel="alternate" type="text/html" title="Do taxímetro de APIs ao custo quase Zero: Por que a Soberania de IA é decisão de engenharia" /><published>2026-08-31T00:00:00+00:00</published><updated>2026-08-31T00:00:00+00:00</updated><id>https://maiquelleonel.com.br/blog/do-taximetro-de-apis-ao-custo-quase-zero-por-que-a-soberania-de-ia-e-decisao-de-engenharia</id><content type="html" xml:base="https://maiquelleonel.com.br/blog/do-taximetro-de-apis-ao-custo-quase-zero-por-que-a-soberania-de-ia-e-decisao-de-engenharia/"><![CDATA[<p>Parece cena de ficção científica: uma cancela de pedágio aos pés da pirâmide da Tyrell Corp cobrando uma taxa por cada bit do seu código. Daria pra chamar de <strong>“imposto de token”</strong> essa tentativa de criar um <em>lock-in</em> onde três ou quatro fornecedores de IA precificam cada linha de código que o seu time digita.</p>

<p>A armadilha é conveniente para quem vende: empacota modelos como caixas-pretas e convence todo mundo de que o único jeito de inovar é manter a bandeira 2 rodando na API deles 24 horas por dia. Se você não pagar, sua empresa fica para trás.</p>

<p>Só esqueceram de combinar com a matemática da infraestrutura e com quem realmente audita a fatura no fim do mês.</p>

<p>A economia real dos pesos abertos e evolução dos modelos chineses  estão implodindo esse pseudo-cartel. Inteligência agora é capacidade computacional fungível. Insistir em pagar pedágio por token para APIs fechadas não é um padrão técnico, é miopia financeira.</p>

<hr />

<h2 id="1-o-sócio-oculto-e-a-mecânica-da-janela-de-contexto">1. O “Sócio Oculto” e a Mecânica da Janela de Contexto</h2>

<p>Para entender por que a fatura de API explode sem aviso prévio, basta olhar como o desenvolvimento moderno assistido por IA realmente funciona na trincheira.</p>

<p>Ninguém mais programa abrindo aba de navegador para pedir regex isolada. A gente pluga agentes direto no editor (<a href="https://zed.dev">Zed Agent</a>, Claude Code, extensões via MCP). Esses agentes varrem a árvore de arquivos, puxam definições de tipos, leem logs de teste e mantêm o histórico da sessão para não perder o fio da meada.</p>

<p>E aqui mora a pegadinha: <strong>o modelo <em>pay-per-token</em> pune de maneira exponencial qualquer fluxo com sessões longas e contexto acumulado.</strong></p>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/hidden_partner.jpeg" alt="O sócio oculto na sua IDE: faturando em cima de cada Enter enquanto o seu time tenta fechar a sprint." />
  
    <figcaption>O sócio oculto na sua IDE: faturando em cima de cada Enter enquanto o seu time tenta fechar a sprint.
</figcaption>
  
</figure>

<p>A cada mensagem em uma sessão de debug, o editor não envia só os 15 caracteres que você acabou de digitar. Ele empacota todo o histórico acumulado, os diffs e os arquivos abertos. Se a sua sessão já tem 80k tokens de contexto, cada <em>Enter</em> faz o taxímetro rodar sobre esses 80k inteiros de entrada, além dos tokens gerados na resposta.</p>

<h3 id="a-conta-real-da-trincheira">A Conta Real da Trincheira</h3>

<p>Quando você audita o tráfego real de agentes em produção, o volume assusta quem ainda calcula custo achando que IA é prompt de uma linha:</p>

<ul>
  <li><strong>Dia a dia comum (Ritmo padrão):</strong> Um desenvolvedor ativo gera fácil <strong>~20 milhões de tokens/dia</strong> entre leituras de contexto, diffs de PR e rodadas de teste. A um custo médio de <strong>~R$ 35,00/dia</strong>, isso dá <strong>R$ 500 a R$ 770/mês por dev</strong> no cenário mais calmo.</li>
  <li><strong>Dia de refatoração pesada (O ralo de dinheiro):</strong> Em dias de épico novo, migração de banco ou caça a bugs em sistemas distribuídos, o consumo bate tranquilamente <strong>100 milhões de tokens em 24 horas</strong>.</li>
  <li><strong>O susto no cartão:</strong> Um único engenheiro queimando <strong>R$ 195,00 em um único dia de trabalho</strong>.</li>
</ul>

<p>Multiplique isso por um time de 5 a 8 pessoas acelerando para entregar uma release: a conta salta de R$ 2.500,00 para <strong>R$ 6.000,00 a R$ 10.000,00+</strong> no final do mês sem você nem ver a cor do dinheiro.</p>

<p>Parabéns: você colocou um sócio oculto dentro da sua IDE. Alguém que lucra mais a cada vez que o seu time resolve trabalhar duro.</p>

<hr />

<h2 id="2-a-comoditização-acelerada-pesos-abertos-vs-apis-fechadas">2. A Comoditização Acelerada: Pesos Abertos vs. APIs Fechadas</h2>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/black_ice_corp.png" alt="[Black ICE](https://en.wikipedia.org/wiki/Intrusion" />
  
    <figcaption>[Black ICE](https://en.wikipedia.org/wiki/Intrusion
</figcaption>
  
</figure>
<p>Countermeasures_Electronics) corporativo: o firewall de 1 milhão de tokens tentando vender como privilégio o que já virou commodity.*</p>

<p>A narrativa de que só superclusters de 100 bilhões de dólares conseguem gerar código de ponta envelheceu rápido. As megacorps adoram estampar “1M de tokens” e “acesso exclusivo” em murais corporativos para justificar o <em>lock-in</em>, mas no dia a dia da engenharia de software, modelos abertos modernos já entregam paridade técnica com as APIs mais caras do mercado.</p>

<h3 id="tabela-comparativa-de-mercado">Tabela Comparativa de Mercado</h3>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/market_vision.png" alt="" />
  
</figure>

<p>Com a maturidade das técnicas de quantização (AWQ, FP8, GGUF) e <em>engines</em> de inferência de alto throughput como o <a href="https://github.com/vllm-project/vllm">vLLM</a> e o <a href="https://github.com/ollama/ollama">Ollama</a>, a barreira de entrada despencou: rodar esses modelos deixou de ser ficção e virou computação padrão de nuvem.</p>

<hr />

<h2 id="3-a-arquitetura-real-48-gb-de-vram-e-gestão-ativa-de-ciclo">3. A Arquitetura Real: 48 GB de VRAM e Gestão Ativa de Ciclo</h2>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/indy_cyberDeck_v3.jpeg" alt="O Cyberdeck moderno: infraestrutura dedicada e controle total da sua própria computação." />
  
    <figcaption>O Cyberdeck moderno: infraestrutura dedicada e controle total da sua própria computação.
</figcaption>
  
</figure>

<p>Para dimensionar um cenário real, considere esta arquitetura provisionada na Google Cloud (GCP):</p>

<ul>
  <li><strong>Instância:</strong> <code class="language-plaintext highlighter-rouge">g2-standard-24</code> (24 vCPUs, 96 GB de RAM de sistema).</li>
  <li><strong>Aceleração Gráfica:</strong> <strong>2x NVIDIA L4 (24 GB de VRAM cada = 48 GB de VRAM total)</strong>.</li>
  <li><strong>Modo de Execução:</strong> <em>Tensor Parallelism</em> (<code class="language-plaintext highlighter-rouge">tp=2</code>) rodando <a href="https://github.com/vllm-project/vllm">vLLM</a> ou <a href="https://github.com/ollama/ollama">Ollama</a>.</li>
  <li><strong>Gestão Ativa de Ciclo (Cloud Scheduler / Cron):</strong> A máquina sobe às 08:45 e desliga às 19:15 em dias úteis.</li>
  <li><strong>Janela Ativa:</strong> ~10,5 horas por dia útil (22 dias úteis = 231 horas/mês), com custo zero em madrugadas e finais de semana.</li>
</ul>

<h3 id="por-que-48-gb-de-vram-é-o-ponto-de-equilíbrio">Por que 48 GB de VRAM é o Ponto de Equilíbrio?</h3>

<p>Em uma GPU isolada de 24 GB, um modelo de 32B consome quase toda a memória só para carregar os pesos. Sobra quase nada para o contexto — no primeiro <em>Enter</em> simultâneo de dois desenvolvedores, a placa bate no teto de VRAM ou estrangula a fila de inferência.</p>

<p>Dobrando para <strong>48 GB de VRAM (2x L4 ou 1x RTX 6000 Ada)</strong>, a física da memória joga a seu favor:</p>

<ul>
  <li><strong>Carga dos Pesos:</strong> O <code class="language-plaintext highlighter-rouge">Qwen-2.5-Coder-32B</code> quantizado (FP8 ou AWQ) consome ~22 GB de VRAM, divididos limpos entre as placas via <em>Tensor Parallelism</em> (<code class="language-plaintext highlighter-rouge">tp=2</code>).</li>
  <li><strong>Área de Manobra para KV Cache:</strong> Sobram <strong>mais de 20 GB de VRAM dedicados para <em>PagedAttention</em></strong>.</li>
  <li><strong>Concorrência Real de Time:</strong> A máquina segura de 5 a 8 desenvolvedores trabalhando ao mesmo tempo em janelas longas (16k a 32k tokens), sem fila, sem degradação de <em>Time to First Token</em> (TTFT) e com risco zero de <em>Out Of Memory</em> (OOM).</li>
</ul>

<hr />

<h2 id="4-a-matemática-da-infraestrutura-própria-fixo-vs-variável">4. A Matemática da Infraestrutura Própria: Fixo vs. Variável</h2>

<p>O custo sob demanda (<em>On-Demand</em>) da <code class="language-plaintext highlighter-rouge">g2-standard-24</code> com 2x L4 fica em aproximadamente <strong>$2,00/hora</strong> (computação + 2 GPUs). Em 231 horas ativas no mês (apenas horário de expediente), a fatura fecha em <strong>~$462 USD</strong> (cerca de <strong>R$ 2.650,00/mês</strong> convertidos com impostos).</p>

<p><em>Com desconto de uso contínuo (CUD de 1 ano na GCP), esse valor cai para cerca de R$ 1.700/mês.</em></p>

<h4 id="a-alternativa-em-nuvens-especializadas-de-gpu-runpod--lambda-labs">A Alternativa em Nuvens Especializadas de GPU (RunPod / Lambda Labs)</h4>

<p>Se a operação não tem amarras com os grandes provedores tradicionais de nuvem, plataformas focadas em GPU derrubam ainda mais a conta:</p>

<ul>
  <li><strong>Hardware:</strong> 1x NVIDIA RTX 6000 Ada (48 GB VRAM em placa única) no Secure Cloud do <a href="https://runpod.io">RunPod</a>.</li>
  <li><strong>Custo por hora:</strong> ~$0,84/hora.</li>
  <li><strong>Fatura mensal (231 horas úteis):</strong> 231 × $0,84 = <strong>$194 USD</strong> (~R$ 1.150/mês).</li>
  <li><strong>Ganho prático:</strong> Com 48 GB em uma única placa, o vLLM roda direto (<code class="language-plaintext highlighter-rouge">tp=1</code>), sem a sobrecarga de dividir tensores entre placas. Uma única instância dessas atende de 8 a 10 desenvolvedores em paralelo por menos do que a assinatura de dois planos comerciais de ponta.</li>
</ul>

<h4 id="para-desenvolvedores-solo-e-equipes-enxutas-gpu-serverless-scale-to-zero">Para Desenvolvedores Solo e Equipes Enxutas: GPU Serverless (Scale to Zero)</h4>

<p>Para quem trabalha solo ou em times de até 3 engenheiros e não quer pagar nem a hora ociosa de almoço ou reuniões, a saída é o <strong>GPU Serverless com Scale to Zero</strong> (via <a href="https://www.runpod.io/product/serverless">RunPod Serverless</a> ou Cloud Run com GPU no GCP):</p>

<ul>
  <li><strong>Como funciona:</strong> Você expõe o endpoint do vLLM. Sem requisição na fila, a infraestrutura vai a <strong>zero absoluto</strong> (custo de R$ 0,00).</li>
  <li><strong>Cobrança por segundo real:</strong> No instante em que você dá um <em>Enter</em> no editor ou dispara um loop de agente, uma GPU acorda, processa a inferência e cobra cerca de <strong>$0,0002 por segundo</strong> ativo.</li>
  <li><strong>A conta prática:</strong> 120 segundos de um loop agêntico pesado custam cerca de <strong>$0,02 USD</strong> (~R$ 0,14). Um dia inteiro com 50 execuções densas fecha em <strong>menos de R$ 8,00</strong>, com zero cobrança em noites e fins de semana. O único trade-off é o <em>cold start</em> de 20 a 30 segundos na primeira chamada do dia para subir os pesos na VRAM via barramento PCIe.</li>
</ul>

<h3 id="comparativo-técnico-e-financeiro">Comparativo Técnico e Financeiro</h3>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/operational_cost.png" alt="" />
  
</figure>

<h3 id="o-custo-marginal-zero">O Custo Marginal Zero</h3>

<p>Em infraestrutura própria, <strong>o custo marginal do token é rigorosamente zero</strong>.</p>

<p>Se um desenvolvedor consome 20 milhões ou ultrapassa 100 milhões de tokens em um dia de depuração pesada, a fatura no fim do mês não mexe um centavo. A capacidade já está provisionada.</p>

<p>A dinâmica da escala se inverte:</p>

<ul>
  <li>Com <strong>5 desenvolvedores</strong>, o custo unitário fica em <strong>R$ 530,00/dev</strong> no On-Demand (ou <strong>R$ 340,00/dev</strong> com CUD).</li>
  <li>Ao expandir para <strong>10 desenvolvedores</strong>, o custo unitário <strong>cai pela metade: R$ 265,00/dev</strong> (ou <strong>R$ 170,00/dev</strong> com CUD).</li>
</ul>

<p>Em APIs proprietárias, a produtividade do time vira passivo financeiro. Na infraestrutura própria, ela é absorvida com custo marginal zero.</p>

<blockquote>
  <p><em>“Mas pagar aluguel de nuvem para GCP ou RunPod não é só trocar um pedágio por outro?”</em></p>

  <p>A confusão mora em misturar <strong>taxímetro de transação</strong> com <strong>compra de capacidade</strong>. Na API fechada, se o seu time codifica 10x mais ou dispara agentes em loops complexos, a fatura decuplica de forma punitiva. Na GPU dedicada, a vazão é sua: o consumo pode explodir, mas o custo financeiro permanece fixo. Além disso, a GPU é uma <strong>commodity fungível</strong>: se o provedor subir o preço, seu container com pesos abertos migra em minutos para qualquer outra nuvem ou volta para hardware próprio no rack. No modelo de APIs proprietárias, essa liberdade simplesmente não existe.</p>
</blockquote>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/projection_cost_per_dev.png" alt="" />
  
</figure>

<hr />

<h2 id="5-endereçando-os-trade-offs-engenharia-sem-ilusões">5. Endereçando os Trade-offs: Engenharia sem Ilusões</h2>

<p>Toda decisão de arquitetura envolve escolhas e concessões. Vale analisar com frieza os três principais contra-argumentos levantados a favor do modelo SaaS:</p>

<h3 id="1-o-custo-operacional-de-manutenção-não-inviabiliza-a-conta">1. “O Custo Operacional de Manutenção não Inviabiliza a Conta?”</h3>
<p>Operar uma instância dedicada não exige uma equipe de DevOps nem um cluster frágil de Kubernetes. A implementação padrão utiliza infraestrutura imutável via <a href="https://github.com/hashicorp/terraform">Terraform</a> / <a href="https://github.com/opentofu/opentofu">OpenTofu</a> combinada com um script determinístico de <em>cloud-init</em>:</p>
<ul>
  <li>A máquina sobe, anexa os discos persistentes com os pesos dos modelos, inicia o container do <a href="https://github.com/vllm-project/vllm">vLLM</a> / <a href="https://github.com/ollama/ollama">Ollama</a> e conecta-se à malha segura da VPN (<a href="https://tailscale.com">Tailscale</a>).</li>
  <li>O esforço de setup inicial é de <strong>menos de um dia de trabalho</strong>. Não existe manutenção recorrente de sistema: a máquina é descartável e <em>stateless</em>.</li>
</ul>

<h3 id="2-e-a-janela-de-1-milhão-de-tokens-das-apis-comerciais">2. “E a Janela de 1 Milhão de Tokens das APIs Comerciais?”</h3>
<p>Provedores adoram estampar janelas de 1M a 2M de tokens em seus materiais de marketing. Na prática da engenharia de software, despejar um milhão de tokens no prompt (<em>prompt dumping</em>) é um atalho que introduz alucinações caras e latências elevadas.</p>

<p>Quando o time aplica princípios sólidos de engenharia — como <strong>Spec-Driven Development</strong>, <em>harnesses</em> bem calibrados e <strong>memória de código baseada em grafos estruturados via MCP</strong> (discussão densa que vale um ensaio técnico à parte) —, o contexto necessário para resolver 95% das tarefas cabe com precisão cirúrgica em janelas enxutas de <strong>16k a 32k tokens</strong>. Dentro desse intervalo, a latência de inferência local em 48GB de VRAM supera com folga o tempo de resposta de APIs públicas congestionadas.</p>

<h3 id="3-o-modelo-híbrido-pragmático-roteamento-de-8515">3. O Modelo Híbrido Pragmático (Roteamento de 85/15)</h3>
<p>Adotar modelos abertos não significa isolacionismo dogmático. A arquitetura mais eficiente é a de <strong>Roteamento Hierárquico</strong>:</p>
<ul>
  <li><strong>Tier 1 (Local / Infra Própria - ~85% a 90% do tráfego):</strong> Modelos abertos dentro da VPC absorvem todo o volume diário de autocompletion, refatoração, geração de testes, CI e tarefas de background.</li>
  <li><strong>Tier 2 (API sob exceção - ~10% a 15%):</strong> Chamadas pontuais para modelos proprietários gigantes apenas em tarefas extraordinárias de raciocínio multimodal ou análises fora do escopo habitual.</li>
</ul>

<p>Para orquestrar essa divisão de forma transparente, o ecossistema <em>open-source</em> oferece soluções prontas:</p>
<ul>
  <li><strong>Roteadores de Contexto e Gateways (Estilo OpenRouter Self-Hosted):</strong> Ferramentas como <a href="https://github.com/dazeb/OmniRoute">OmniRouter</a>, <a href="https://github.com/BerriAI/litellm">LiteLLM Proxy</a> e <a href="https://github.com/lm-sys/RouteLLM">RouteLLM</a> (LMSYS) expõem um endpoint único compatível com OpenAI para as IDEs, balanceando requisições, gerenciando fallbacks automáticos e direcionando queries por complexidade semântica.</li>
  <li><strong>Governança, DLP e Hub MCP:</strong> Plataformas como o <a href="https://systemprompt.io">SystemPrompt.io</a> (self-hosted em Rust) atuam como firewall e host central de <em>Model Context Protocol</em>, interceptando vazamento de credenciais nos prompts e bloqueando execuções destrutivas de agentes autônomos.</li>
</ul>

<hr />

<h2 id="6-ganhos-arquiteturais-além-da-planilha">6. Ganhos Arquiteturais Além da Planilha</h2>

<p>A previsibilidade financeira é o que salta aos olhos, mas a autonomia técnica traz vantagens estruturais permanentes:</p>

<h3 id="perímetro-fechado-de-propriedade-intelectual-e-fim-do-shadow-ai">Perímetro Fechado de Propriedade Intelectual e Fim do “Shadow AI”</h3>
<p>Como o <a href="https://www.youtube.com/watch?v=qh4vLlit97I">IndyDevDan</a> apontou: quem terceiriza inteligência para modelos proprietários paga a conta duas vezes. Ou seja, desembolsa a fatura em dólar por token e ainda entrega de bandeja o contexto, os fluxos operacionais e a propriedade intelectual do produto para alimentar a telemetria dos grandes laboratórios.</p>

<p>Além disso, existe o elefante na sala: o <strong>Shadow AI</strong>. Em quase toda empresa, colaboradores copiam planilhas, <em>reports</em>, documentos e contratos confidenciais para colar no ChatGPT ou Claude web atrás de resumos rápidos. Proibir por memorando ou bloquear via firewall corporativo não é efetivo: modelos multimodais entendem texto em imagem com perfeição e rodam em qualquer smartphone pessoal no 5G. A única saída real é desenhar um <a href="https://blog.codinghorror.com/falling-into-the-pit-of-success/">Pit of Success</a>: oferecer uma interface interna soberana conectada à infraestrutura própria da empresa, tornando o caminho seguro o mais fácil de usar.</p>

<p>Ao rodar modelos dentro da sua VPC conectada via Cloud VPN ou <a href="https://tailscale.com">Tailscale</a>, essa sangria acaba. Esquemas de bancos de dados, regras de negócio, dados de clientes e segredos de infraestrutura permanecem estritamente dentro do seu perímetro de segurança. Nada transita por endpoints públicos e nada vira insumo de treino externo.</p>

<h3 id="fim-do-estrangulamento-por-rate-limit">Fim do Estrangulamento por <em>Rate Limit</em></h3>
<p>Depender de APIs públicas significa conviver com o risco do <code class="language-plaintext highlighter-rouge">HTTP 429 Too Many Requests</code> no pior momento possível: durante um incidente em produção ou na véspera de uma release crítica. Com infraestrutura dedicada, a vazão é sua e responde unicamente à demanda do seu time.</p>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/dev_desk_429_error_v1.png" alt="HTTP 429 na veia: quando a sua IDE vira um fliperama pedindo ficha para você continuar trabalhando." />
  
    <figcaption>HTTP 429 na veia: quando a sua IDE vira um fliperama pedindo ficha para você continuar trabalhando.
</figcaption>
  
</figure>

<h3 id="a-gpu-como-ativo-de-produto-dia-e-noite">A GPU Como Ativo de Produto (Dia e Noite)</h3>
<p>A mesma instância provisionada para auxiliar os desenvolvedores durante o expediente não precisa ficar ociosa depois das 19h. Fora do horário comercial, ela pode absorver cargas assíncronas do próprio produto:</p>

<ul>
  <li>Pipelines de classificação de dados e enriquecimento textual.</li>
  <li>Extração de entidades e <em>matchmaking</em> semântico.</li>
  <li>Geração de embeddings para busca vetorial.</li>
  <li><strong>BI Privado e Text-to-SQL Seguro:</strong> Consultas analíticas automatizadas sobre réplicas de leitura internas sem expor métricas financeiras sensíveis ou dados de clientes (PII) para nuvens públicas.</li>
  <li><strong>Memória Corporativa com AnythingLLM:</strong> Backend de inferência para ferramentas de RAG corporativo (como o <a href="https://github.com/Mintplex-Labs/anything-llm">AnythingLLM</a>), unificando a base documental da empresa de forma soberana, auditável e sem <em>lock-in</em>.</li>
</ul>

<p>Uma capacidade computacional que entrou como ferramenta de trabalho passa a servir diretamente ao produto sem adicionar um único real na fatura.</p>

<hr />

<h2 id="7-fundamentos-vencem-o-hype">7. Fundamentos Vencem o Hype</h2>

<p>A ideia de que times de engenharia estão fadados a rodar com o taxímetro da IA para cada <em>commit</em> é muito conveniente pras Big Techs.</p>

<p>Só que o ecossistema de pesos abertos já passou da fase experimental faz tempo. Quantização FP8 funciona, <em>engines</em> de inferência têm vazão de sobra e subir uma GPU sob demanda é script de 10 minutos em qualquer provedor.</p>

<p>Ficar refém de API fechada virou decisão de quem prefere terceirizar a arquitetura e pagar a conta sem auditar. Na ponta da linha, a lição de engenharia é simples: <strong>preserve o controle da sua infraestrutura e nunca pague taxa por requisição pelo que você pode rodar como capacidade soberana dentro de casa.</strong></p>

<hr />

<p><strong>Gostou da reflexão?</strong> 
Como o seu time tem lidado com o consumo de tokens e o equilíbrio entre APIs e infraestrutura própria? Deixe seu comentário ou vamos trocar uma ideia:</p>

<ul>
  <li><strong>GitHub:</strong> <a href="https://github.com/maiquelleonel">@maiquelleonel</a></li>
  <li><strong>LinkedIn:</strong> <a href="https://www.linkedin.com/in/maiquelleonel">/in/maiquelleonel</a></li>
</ul>]]></content><author><name>Maiquel Leonel</name><email>maiquel@maiquelleonel.com.br</email></author><category term="Artificial Intelligence" /><category term="Fin Ops" /><category term="Local AI" /><category term="Software Engineering" /><summary type="html"><![CDATA[Por que o modelo pay-per-token de APIs fechadas vira um taxímetro insustentável em escala e como a infraestrutura local (SLMs/ONNX) garante a soberania técnica e financeira.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://maiquelleonel.com.br/blog/assets/images/capa_token_tax_dystopian.png" /><media:content medium="image" url="https://maiquelleonel.com.br/blog/assets/images/capa_token_tax_dystopian.png" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">O Engenheiro com Mentalidade de Produto: Por que código perfeito não salva produto ruim</title><link href="https://maiquelleonel.com.br/blog/o-engenheiro-com-mentalidade-de-produto-por-que-codigo-perfeito-nao-salva-produto-ruim/" rel="alternate" type="text/html" title="O Engenheiro com Mentalidade de Produto: Por que código perfeito não salva produto ruim" /><published>2026-08-24T00:00:00+00:00</published><updated>2026-08-24T00:00:00+00:00</updated><id>https://maiquelleonel.com.br/blog/o-engenheiro-com-mentalidade-de-produto-por-que-codigo-perfeito-nao-salva-produto-ruim</id><content type="html" xml:base="https://maiquelleonel.com.br/blog/o-engenheiro-com-mentalidade-de-produto-por-que-codigo-perfeito-nao-salva-produto-ruim/"><![CDATA[<h3 id="introdução-a-engenharia-como-criatura-liminar-e-colaborativa">Introdução: A Engenharia como Criatura Liminar e Colaborativa</h3>

<p>O maior erro do engenheiro de software é acreditar que código tecnicamente perfeito salva produto ruim. Passamos anos refinando algoritmos, otimizando queries e blindando pipelines de CI/CD, mas frequentemente nos isolamos na escovação de bits enquanto o produto sangra na mão do usuário.</p>

<p>Em <em>The Product-Minded Engineer</em>, Drew Hoskins utiliza uma analogia precisa: o engenheiro de software é uma criatura de fronteira, semelhante à lontra-marinha. Precisamos mergulhar nas profundezas da infraestrutura, dos bancos de dados e dos sistemas distribuídos para construir a base técnica, mas dependemos do oxigênio da superfície — as restrições reais de negócio e o comportamento do usuário — para não morrer sufocados.</p>

<p>Na natureza, lontras sobrevivem em grupos (<em>rafts</em>), segurando as patas umas das outras para não derivarem sozinhas pela correnteza. Na engenharia, isso se traduz em alinhamento: o <em>Product Thinking</em> não é um chapéu opcional que terceirizamos para a equipe de Design ou de Produto; é o contrato de governança que conecta a arquitetura técnica ao impacto real do negócio.</p>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/1__0TOJxOBYpPxc_UQ3j3ZFw.jpeg" alt="" />
  
</figure>

<p>Para navegar nessa dinâmica sem cair no purismo acadêmico, equilibramos dois modos mentais:</p>

<ul>
  <li><em>System Thinking</em> (Pensamento de Sistema): Domínio de algoritmos, estruturas de dados, tolerância a falhas, concorrência e custo de infraestrutura. É a nossa fundação técnica inegociável.</li>
  <li><em>Product Thinking</em> (Pensamento de Produto): Capacidade de mapear intenções, atritos e jornadas do usuário, usando a arquitetura técnica para viabilizar soluções de negócio com a menor fricção cognitiva possível.</li>
</ul>

<p>O modelo tradicional do <em>Double Diamond</em> (<em>Discover</em>, <em>Define</em>, <em>Develop</em>, <em>Deliver</em>) costuma afastar desenvolvedores porque começa pela abstração pura. A abordagem de Hoskins inverte esse fluxo para a engenharia: partimos da execução técnica (<em>Develop</em> e <em>Deliver</em>), onde temos maior domínio prático, e evoluímos em direção à definição e descoberta (<em>Discover</em> e <em>Define</em>), onde reside o salto de impacto para lideranças técnicas e Staff+.</p>

<h3 id="capítulo-1-o-cenário-como-primitivapor-que-código-perfeito-não-salva-produtosruins">Capítulo 1: O “Cenário” como Primitiva — Por que Código Perfeito não Salva Produtos Ruins</h3>

<p>Quando a engenharia se isola em métricas puramente técnicas, o risco de construir sistemas impecáveis que ninguém usa explode. A primitiva básica para evitar esse desperdício é o cenário.</p>

<h3 id="estudo-de-caso-teaa-batalha-entre-bob-ealice">Estudo de Caso: Tea++ — A Batalha entre Bob e Alice</h3>

<p>A Tea++ é uma rede fictícia de 300 cafeterias enfrentando queda de receita e precisando urgentemente elevar a conversão de pedidos pelo aplicativo.</p>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/1_bFn0My9e5aihlYOu_ueYag.jpeg" alt="" />
  
</figure>

<h4 id="bob-o-engenheiro-tarefeiro">Bob, o engenheiro “tarefeiro”</h4>

<p>Recebe o ticket do Jira solicitando “lista de favoritos”. Ele não questiona o contexto, modela tabelas relacionais impecáveis, cria endpoints otimizados e entrega a tarefa sem bugs. No entanto, a feature exige cinco cliques em telas distintas. A conversão de pedidos subiu pífios 0,3%. O código é perfeito, mas a empresa continua sangrando faturamento.</p>

<h4 id="alice-a-engenheira-deproduto">Alice, a engenheira de produto</h4>

<p>Antes de abrir o banco de dados, desenha a persona “Eliana” — uma motorista que faz pedidos por comando de voz no trânsito caótico. Alice percebe que o problema real não é a ausência de uma tabela de favoritos genérica, mas a fricção de selecionar a loja física correta enquanto dirige. Ela simplifica o fluxo: cria um botão de “Pedir o de Sempre” na tela inicial baseado no histórico recente e define a loja preferida por geolocalização. A conversão sobe 3,8%, mudando o faturamento da empresa.</p>

<h3 id="a-anatomia-de-um-cenário-de-altonível">A Anatomia de um Cenário de Alto Nível</h3>

<p>Um cenário não é um ticket descritivo no Jira; é um teste de aceitação de negócio composto por Personagem (quem opera) e Simulação (como o sistema reage ao contexto):</p>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/1_07Cks0pzdwK1LQ-E46I8rw.png" alt="Anatomia de um cenário: o ponto de encontro entre personas reais e a simulação de seus fluxos de uso." />
  
    <figcaption>Anatomia de um cenário: o ponto de encontro entre personas reais e a simulação de seus fluxos de uso.
</figcaption>
  
</figure>

<h3 id="heurísticas-de-empatia-shoe-shifting-e-amnésiaseletiva">Heurísticas de Empatia: Shoe-shifting e Amnésia Seletiva</h3>

<p>Para quebrar a “Maldição do Conhecimento” — o viés de conhecer cada detalhe da infraestrutura interna — , utilizamos duas técnicas mentais:</p>

<ol>
  <li><strong>*Shoe-shifting *(Troca de Sapatos)</strong>: Navegar pelo fluxo despindo-se do conhecimento de banco de dados e APIs, avaliando a tela com a perspectiva de um usuário leigo sob pressão.</li>
  <li><strong>Amnésia Seletiva:</strong> Se para entender a lentidão ou o comportamento de uma tela você precisa lembrar que <em>“o worker assíncrono processa o payload e atualiza o estado via WebSocket”</em>, o design da interface falhou.</li>
</ol>

<h3 id="premissas-do-comportamento-humano">Premissas do Comportamento Humano</h3>

<p>Ao desenhar contratos de software e interfaces, assuma três verdades brutais:</p>

<ul>
  <li><strong>Preguiça Cognitiva</strong>: Processamento mental consome energia. O usuário sempre buscará o caminho de menor esforço cerebral.</li>
  <li><strong>Aversão a Manuais</strong>: Ninguém lê documentações ou FAQs para tarefas operacionais. O fluxo precisa ser autoexplicativo por construção.</li>
  <li><strong>Foco na Conclusão da Tarefa</strong>: O usuário não entra na aplicação para contemplar a sofisticação da arquitetura; ele quer resolver um problema e fechar o app.</li>
</ul>

<h3 id="parte-i-developinterface-e-comunicação">Parte I: Develop — Interface e Comunicação</h3>

<h3 id="capítulo-2-guiando-os-usuários-pelo-seuproduto">Capítulo 2: Guiando os usuários pelo seu produto</h3>

<p>Design de interface não se limita ao trabalho de UI/UX. Engenheiros tomam decisões diárias de design ao expor endpoints, estruturar bibliotecas e definir fluxos visuais.</p>

<h4 id="significadores-signifiers-placas-detrânsito">Significadores (Signifiers): Placas de Trânsito</h4>

<p>Inspirado em Don Norman, um significador é a pista que indica a função de um componente no sistema:</p>

<ul>
  <li>Um método ou ícone cujo nome declara explicitamente sua intenção.</li>
  <li>Sombreamentos e contrastes que deixam evidente o que é clicável.</li>
  <li>Mensagens de erro que indicam com clareza o caminho de recuperação.</li>
</ul>

<p>Se uma feature depende de um <em>tooltip</em> explicativo gigante para ser compreendida, a sinalização arquitetural está quebrada.</p>

<h4 id="pdm-product-discovery-map-o-grafo-da-descoberta">PDM (Product Discovery Map): O Grafo da Descoberta</h4>

<p>O PDM mapeia o caminho de descoberta do produto como um grafo direcionado: cada nó representa um recurso ou informação, e cada aresta representa o esforço mental exigido para alcançá-lo.</p>

<p>Quando um fluxo crítico exige saltos arbitrários entre menus desconexos, o grafo está fragmentado, forçando o usuário a desistir da jornada.</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Fluxo Fragmentado (Atrito Alto):
[Home] ──&gt; [Configurações] ──&gt; [Avançado] ──&gt; 
                               [Assinatura] ──&gt; [Trocar Cartão]

Fluxo Contratual Otimizado (PDM):
[Home] ──&gt; [Alerta de Pagamento Pendente] ──&gt;
                               [Atualizar Cartão (1-Click)]
</code></pre></div></div>

<h4 id="estudo-de-caso-o-ribbon-do-microsoft-office">Estudo de Caso: O “Ribbon” do Microsoft Office</h4>

<p>Em 2003, o Microsoft Word acumulava 31 barras de ferramentas simultâneas. Usuários demandavam recursos que já existiam há anos no código, mas estavam enterrados na interface. A solução foi a criação do <em>Ribbon</em> através da Revelação Graciosa (<em>Graceful Reveal</em>): o sistema expõe menus contextuais (como formatação de imagem) apenas quando o objeto relevante é selecionado, reduzindo drasticamente a carga cognitiva e o ruído visual.</p>

<h4 id="ontologia-e-a-maldição-do-conhecimento">Ontologia e a “Maldição do Conhecimento”</h4>

<p>Ontologia é o conjunto de termos e conceitos que o produto expõe. O erro mais comum da engenharia é vazar jargões internos do banco de dados para o cliente final.</p>

<p>A Stripe tornou-se referência global de DX (<em>Developer Experience</em>) justamente por desenhar suas APIs eliminando termos contábeis antiquados e densos (como <em>“receivables”</em>) em favor de entidades semânticas limpas e diretas (charges, customers, refunds) que qualquer engenheiro generalista compreende de imediato.</p>

<p>Regra prática: prefira identificadores descritivos e autoexplicativos a acrônimos enigmáticos que exigem contexto tribal para decifração.</p>

<h4 id="engenharia-como-design-decódigo">Engenharia como Design de Código</h4>

<p>O código que você escreve é a interface consumida pelos seus pares de equipe:</p>

<ul>
  <li>Elimine Codinomes Internos: Abandone nomes crípticos como “Projeto Valhalla”. Use nomes semânticos como “Billing-Retry-Engine”.</li>
  <li>Redundância Útil em Logs e Depuração: Em momentos críticos de incidentes, variáveis e logs com contexto rico poupam horas de diagnóstico sob estresse.</li>
  <li>Nomes Explícitos para Operações Perigosas: Se um método é destrutivo, explicite o risco no nome (_hard_delete_all_records_unrecoverable).</li>
</ul>

<h3 id="capítulo-3-mensagens-de-erro-como-interface-deproduto">Capítulo 3: Mensagens de Erro como Interface de Produto</h3>

<p>Para a maioria dos times técnicos, tratamento de erro é um bloco catch protocolar escrito às pressas antes do deploy de sexta-feira.</p>

<p>Na prática, o momento do erro é quando o usuário está no ponto máximo de frustração (<em>flight risk</em>). Uma mensagem críptica é o gatilho final para o abandono do produto ou para a abertura de tickets caros de suporte.</p>

<h4 id="o-framework-de-categorização-deerros">O Framework de Categorização de Erros</h4>

<p>Antes de persistir logs ou retornar respostas HTTP genéricas, categorizamos o incidente para direcionar a ação imediata:</p>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/1_ag-fWA6bPKZbGMK7MAq8Wg.png" alt="Framework de categorização de erros: direcionando ações corretivas de forma imediata." />
  
    <figcaption>Framework de categorização de erros: direcionando ações corretivas de forma imediata.
</figcaption>
  
</figure>

<h4 id="estudo-de-caso-channelzerros-contextuais">Estudo de Caso: Channelz — Erros Contextuais</h4>

<p>A Channelz (ferramenta fictícia de comunicação corporativa estilo Slack) sofria com tickets de suporte gerados pela API de integrações, que retornava a mensagem seca: “Usuário não existe”.</p>

<p>O cliente reportou que o usuário @buckcluck existia no sistema corporativo, mas os robôs falhavam continuamente. A engenheira Elise investigou o problema e identificou que o usuário existia, mas sua conta estava temporariamente inativa. Ela ajustou a resposta da API para: “User @buckcluck has been deactivated.”</p>

<p>O volume de chamados despencou imediatamente: o próprio cliente diagnosticou a situação e reativou o usuário, eliminando a dependência do time de engenharia.</p>

<h4 id="arquitetura-de-erros-repackaging-e-chained-exceptions">Arquitetura de Erros: Repackaging e Chained Exceptions</h4>

<p>Como propagar erros da camada de persistência até a interface sem perder o contexto de depuração?</p>

<ul>
  <li><strong>Chained Exceptions</strong>: Utilize encadeamento de exceções (ex: raise DomainError(“Conta inativa”) from db_error). Isso preserva o stack trace original para observabilidade interna enquanto entrega uma mensagem tratada e segura na ponta.</li>
  <li><strong>Cadeias de Contexto Rico (Thicker Chains)</strong>: Transite entidades completas do domínio nos fluxos de validação em vez de IDs opacos (user_id: 123). Isso garante que a camada de borda tenha os metadados necessários para construir respostas acionáveis.</li>
</ul>

<h4 id="shift-left-compiladores-e-o-anti-exemplo-dolatex">Shift Left, Compiladores e o Anti-exemplo do LaTeX</h4>

<p>Capture falhas operacionais o mais cedo possível na jornada:</p>

<ul>
  <li>O Caso do LaTeX: Quem já operou LaTeX conhece o desespero do erro enigmático <em>“Underfull \hbox (badness 10000)”</em>, que acumula mais de 350 mil tópicos no StackOverflow. O erro ocorre porque o compilador perde a linhagem do token original do código. Compiladores modernos mantêm essa árvore sintática em memória para apontar exatamente a linha, coluna e caractere causador do desalinhamento.</li>
  <li>Confirmações Preventivas na CLI: Se um usuário configura um payload destrutivo ou uma política agressiva de retentativas (como 500 retries em 10 segundos na CLI do Channelz), o sistema deve interceptar a operação preventivamente, explicar o impacto e exigir uma flag explícita de confirmação (–force-risk).</li>
  <li>Erros Estruturados: Nunca force o consumidor da sua API a fazer <em>string parsing</em> de mensagens de erro. Retorne payloads estruturados com códigos de domínio, campos afetados e links diretos para a documentação de resolução.</li>
</ul>

<h3 id="parte-ii-delivervalidação-eiteração">Parte II: Deliver — Validação e Iteração</h3>

<h3 id="capítulo-4-dogfooding-e-a-matriz-de-trade-off-detestes">Capítulo 4: Dogfooding e a Matriz de Trade-off de Testes</h3>

<p>Times de engenharia frequentemente caem na ilusão de confiar em 100% de cobertura de testes unitários enquanto empurram a descoberta de falhas de usabilidade para os clientes em produção.</p>

<p>Donald Knuth estabeleceu o princípio clássico: quem projeta um sistema deve ser seu primeiro usuário intensivo e o autor do rascunho inicial de sua documentação. O <em>Dogfooding</em> atua como um mecanismo de <em>Shift Left</em>, interceptando falhas conceituais antes do lançamento.</p>

<h4 id="a-pirâmide-tradicional-vs-a-matriz-de-trade-off-detestes">A Pirâmide Tradicional vs. A Matriz de Trade-off de Testes</h4>

<p>A pirâmide de testes tradicional é puramente orientada ao custo computacional da pipeline: empilha testes unitários porque são rápidos e baratos, e evita testes ponta a ponta porque são lentos e custosos.</p>

<p>No entanto, ela não responde à pergunta fundamental: <strong>o sistema está gerando o valor esperado?</strong></p>

<p>Para balancear esforço de engenharia e risco de negócio, adaptei essa dinâmica em uma <strong>Matriz de Trade-off de Testes (Importância vs. Urgência)</strong>:</p>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/1_B1u773LzNufXqzoJEWPslg.png" alt="A Matriz de Eisenhower aplicada à estratégia de testes de software: priorizando a cobertura para maximizar o valor do produto e a estabilidade técnica." />
  
    <figcaption>A Matriz de Eisenhower aplicada à estratégia de testes de software: priorizando a cobertura para maximizar o valor do produto e a estabilidade técnica.
</figcaption>
  
</figure>

<ol>
  <li><strong>Faça Agora (Validar Produto — Alta Importância + Alta Urgência)</strong>: Testes de cenário e fluxos E2E críticos (login, checkout, liquidação financeira). Se quebrarem, o negócio para imediatamente.</li>
  <li><strong>Planeje (Mitigar Risco — Alta Importância + Baixa Urgência)</strong>: Testes unitários e de integração focados em regras complexas de domínio. Garantem que refatorações estruturais não introduzam regressões silenciosas.</li>
  <li><strong>Delegue (Automação de Baixo Custo — Baixa Importância + Alta Urgência)</strong>: Testes superficiais de interface e verificações sintáticas. Devem rodar via <em>quality gates</em> automatizados sem consumir tempo nobre de análise da liderança técnica.</li>
  <li><strong>Elimine (Débito Técnico — Baixa Importância + Baixa Urgência)</strong>: Testes duplicados, instáveis (<em>flaky tests</em>) ou que testam detalhes efêmeros de implementação. Destrua-os sem hesitação; eles apenas inflacionam o tempo de CI e geram fadiga de alertas.</li>
</ol>

<h4 id="estudo-de-caso-netflixtestes-de-cenário-com-fakes-de-alta-fidelidade">Estudo de Caso: Netflix — Testes de Cenário com Fakes de Alta Fidelidade</h4>

<p>Para validar a experiência de navegação e reprodução de vídeos na Netflix sem a fatura proibitiva de instanciar bancos distribuídos reais a cada <em>build</em> de CI, o time utiliza <em>Fakes</em> de alta fidelidade.</p>

<p>O teste automatizado simula a navegação real consumindo links dinâmicos no HTML/JS e garantindo que o gatilho de <em>streaming</em> seja disparado corretamente na API. Diferente de mocks estáticos que apenas retornam payloads cegos, os fakes compartilham o fluxo de execução real de produção, isolando apenas a instabilidade de rede.</p>

<h4 id="estudo-de-caso-stripeo-test-mode-como-alavanca-denegócio">Estudo de Caso: Stripe — O “Test Mode” como Alavanca de Negócio</h4>

<p>A <strong>Stripe</strong> transformou testes em diferencial competitivo através do seu ambiente de Test Mode. Ao disponibilizar cartões de crédito sintéticos parametrizados (que disparam retornos cirúrgicos como cartão expirado, fundos insuficientes ou bloqueios de fraude), o desenvolvedor cliente valida cenários complexos de erro sem transacionar capital real. O teste deixa de ser uma operação tensa e passa a ser uma rampa fluida de integração.</p>

<h4 id="friction-logging-o-caso-david-singleton-cto-dastripe">Friction Logging: O Caso David Singleton (CTO da Stripe)</h4>

<p>O <em>Friction Log</em> é o registro cronológico e sem filtros de cada segundo de hesitação, erro de interface ou ambiguidade encontrado ao operar a própria aplicação.</p>

<p>Na Stripe, o lendário CTO David Singleton passava semanas operando as ferramentas internas como se fosse um desenvolvedor recém-chegado, gerando diários de fricção que expunham falhas estruturais de usabilidade antes que chegassem aos clientes.</p>

<p>Regra de ouro: nunca exija abertura de chamados formais no Jira para relatos internos de fricção de produto; barreiras burocráticas silenciam <em>feedbacks</em> críticos.</p>

<h4 id="documentação-como-arquitetura-o-modelo-prfaq-daamazon">Documentação como Arquitetura: O Modelo PR/FAQ da Amazon</h4>

<p>Escrever a documentação ou um <em>PR/FAQ</em> (a prática da Amazon de redigir comunicados de imprensa fictícios antes de codificar) atua como o primeiro teste de sanidade do sistema. Se explicar o funcionamento de uma funcionalidade na documentação pública exige contorcionismos textuais e exceções infinitas, a arquitetura interna está disfuncional e precisa ser simplificada antes da primeira linha de código.</p>

<h3 id="capítulo-5-o-zelador-do-gêmeodigital">Capítulo 5: O Zelador do Gêmeo Digital</h3>

<p>O código-fonte é o motor do sistema; o Gêmeo Digital (Digital Twin) é a instrumentação de telemetria que expõe o comportamento operacional desse motor em produção sob as ações reais do usuário. Engenheiros não são tarefeiros que entregam código e somem; são responsáveis pela estabilidade e governança dessa entidade viva.</p>

<h4 id="estudo-de-caso-temporalmétricas-de-vaidade-vs-métricas-deimpacto">Estudo de Caso: Temporal — Métricas de Vaidade vs. Métricas de Impacto</h4>

<p>Evite a armadilha de otimizar indicadores que não traduzem saúde de produto (como volume de <em>commits</em> ou linhas de código). A equipe da plataforma Temporal reformulou sua estratégia de métricas abandonando métricas de vaidade em favor de indicadores de impacto real:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>+---------------------+---------------------------------------+
| Categoria           | Aplicação Prática (Caso Temporal)     |
+---------------------+---------------------------------------+
| Métricas de Adoção  | Abandonaram pageviews na documentação |
| (Leading            | para focar em Managed Deployments     |  
|    Indicators)      | Ativos em produção.                   | 
+---------------------+---------------------------------------+
| Métricas de Valor   | Em vez de apenas monitorar erros após |
| (Trailing           | deploys, medem % de erros críticos de | 
|    Indicators)      | upgrade.                              |
+---------------------+---------------------------------------+
| KPIs de Negócio     | Impacto direto em NRR (Net Revenue    |
| (Alinhamento        | Retention), churn técnico e redução   |
|    Estratégico)     | de chamados operacionais.             |
+---------------------+---------------------------------------+
</code></pre></div></div>

<h4 id="o-flywheel-de-suporte-respondendo-com-documentação">O Flywheel de Suporte: Respondendo com Documentação</h4>

<p>Suporte técnico não é interrupção de trabalho; é o canal de auditoria mais transparente sobre as deficiências do seu produto.</p>

<p>A regra é estrita: todo chamado de suporte resolvido pela engenharia deve resultar na atualização direta do código ou na melhoria da documentação pública. Esse ciclo de realimentação (<em>flywheel</em>) expande a autonomia do cliente, reduz a reincidência de tickets e alimenta bases de contexto técnico para suporte automatizado.</p>

<h3 id="parte-iii-discoverliderança-e-simulação">Parte III: Discover — Liderança e Simulação</h3>

<h3 id="capítulo-6-personas-reais-vs-usuários-espantalho">Capítulo 6: Personas Reais vs. Usuários Espantalho</h3>

<p>O maior vetor de desperdício em desenvolvimento é projetar soluções baseadas em perfis imaginários convenientes — arquétipos criados exclusivamente para justificar nossas escolhas técnicas prediletas.</p>

<h4 id="os-quatro-usuários-espantalho-strawmen">Os Quatro Usuários Espantalho (Straw Men)</h4>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/1_tzP7-nF98kZsgu5hs05y2Q.png" alt="Os quatro tipos de Espantalhos que Hoskins descreve no livro. Com um toque de “originalidade” gemini-ânica. :D" />
  
    <figcaption>Os quatro tipos de Espantalhos que Hoskins descreve no livro. Com um toque de “originalidade” gemini-ânica. :D
</figcaption>
  
</figure>

<ol>
  <li><strong>O Seu Clone</strong>: O desenvolvedor idealizado. Conhece o <em>schema</em> do banco tão bem quanto você, tolera terminais complexos e adora ler especificações cruas. Ele não existe fora do time técnico.</li>
  <li><strong>O Monge Estoico</strong>: Um usuário irreal com paciência infinita, que ao se deparar com um erro 500 ou uma tela travada simplesmente respira fundo e reinicia o processo sem reclamar ou cancelar a assinatura.</li>
  <li><strong>A “<em>Manic Pixie Dream User</em>”</strong>: A usuária fictícia que ama o software incondicionalmente e engaja espontaneamente em qualquer refatoração técnica interna sem exigir retorno prático de valor.</li>
  <li><strong>O Ator Irracional</strong>: Alguém que age ignorando incentivos econômicos e contextuais básicos da própria rotina de trabalho.</li>
</ol>

<h4 id="o-funil-de-entrevista-cdi-e-o-efeitocthulhu">O Funil de Entrevista (CDI) e o Efeito Cthulhu</h4>

<p>Ao conduzir entrevistas de descoberta (<em>Customer Discovery Interviews</em>), postergue a revelação da sua solução para blindar o processo contra o <strong>Efeito Cthulhu</strong>.</p>

<p>Assim como a entidade mitológica de Lovecraft que corrompe a mente de quem a contempla, assim que o cliente visualiza o seu protótipo, a espontaneidade é destruída. A partir daquele momento, ele tentará ser educado, validando sua ideia para evitar atritos sociais.</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>FUNIL DE ENTREVISTA DE DESCOBERTA (CDI)
   ┌───────────────────────────────────────────────────────────┐
   │ 1. O Mundo do Usuário (Topo):                             │
   │    Narrações cronológicas de fatos passados reais.        │
   │    "Como você resolveu esse problema na última terça?"    │
   ├───────────────────────────────────────────────────────────┤
   │ 2. Fricções Reais (Meio):                                 │
   │    Mapeamento de gargalos sem mencionar soluções.         │
   │    "Qual etapa desse processo consumiu mais tempo?"       │
   ├───────────────────────────────────────────────────────────┤
   │ 3. Revelação Controlada (Base):                           │
   │    Protótipos expostos apenas nos minutos finais.         │
   │    Captura de reações viscerais e feedbacks de atrito.    │
   └───────────────────────────────────────────────────────────┘
</code></pre></div></div>

<h4 id="estudo-de-caso-facebook-app-centera-matriz-de-personas-emação">Estudo de Caso: Facebook App Center — A Matriz de Personas em Ação</h4>

<p>No lançamento do <em>App Center</em>, a equipe de engenharia do Facebook evitou meses de desperdício ao definir com rigor quem o produto atendia e quem ele decidia ignorar ativamente:</p>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/1_rOOdmGQT-JSpWKVbL1I37Q.png" alt="Matriz de personas: clareza operacional sobre o público prioritário e as não-personas" />
  
    <figcaption>Matriz de personas: clareza operacional sobre o público prioritário e as não-personas
</figcaption>
  
</figure>

<p>Ao categorizar o <em>Hard-core Gamer</em> como uma Não-Persona explícita, a engenharia rejeitou a criação de subsistemas complexos de <em>matchmaking</em> global em tempo real e engines 3D pesadas no navegador. O foco foi direcionado exclusivamente para APIs simples de convites sociais e notificações no Feed, atendendo a persona prioritária.</p>

<h4 id="tese-e-antítese-de-engenharia">Tese e Antítese de Engenharia</h4>

<p>Para combater o otimismo ingênuo, adote o princípio do método científico: para toda Tese de Produto, a engenharia deve formular sua respectiva Antítese.</p>

<ul>
  <li>Tese: <em>“A nova API pública aumentará a integração orgânica do ecossistema de parceiros.”</em></li>
  <li>Antítese: <em>“Parceiros não têm capacidade técnica para consumir a API e continuarão exigindo integrações customizadas via Webhook.”</em></li>
</ul>

<p>Manter a antítese ativa no radar técnico prepara o time para pivotar rapidamente diante dos primeiros sinais de atrito em produção.</p>

<h3 id="capítulo-7-north-star-scenarios-e-as-quatro-verdadesbrutais">Capítulo 7: North Star Scenarios e as Quatro Verdades Brutais</h3>

<p>O <em>North Star Scenario</em> (Cenário Estrela-Guia) é o vetor técnico que aponta para o estado ideal da arquitetura no longo prazo. Mesmo que não seja implementado no dia zero, ele estabelece as fronteiras e restrições arquiteturais para que o sistema não seja construído sobre fundações descartáveis.</p>

<p>Para fatiar o escopo do <em>milestone zero</em>, avaliamos o trade-off Bang-for-the-Buck:</p>

<blockquote>
  <p>O <strong>Bang</strong>: O impacto tangível e mensurável gerado no negócio e na experiência do usuário.</p>
</blockquote>

<blockquote>
  <p>O <strong>Buck</strong>: O custo real de engenharia — horas de desenvolvimento, manutenção de infraestrutura, dívida técnica e complexidade operacional.</p>
</blockquote>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/1_Mkq4asgbi23Ione45f-6Sw.png" alt="As Quatro Verdades Brutais da entrega de software." />
  
    <figcaption>As Quatro Verdades Brutais da entrega de software.
</figcaption>
  
</figure>

<p>A armadilha clássica de times de engenharia é focar exclusivamente na redução do <em>Buck</em> (escrever menos código hoje), mesmo que isso transfira um atrito infernal para o usuário final.</p>

<p>Essa postura cria uma cultura de fuga de desafios técnicos relevantes. Por outro lado, sacrificar a integridade da arquitetura para acelerar entregas ativa a quarta verdade brutal: Sustentar software é difícil. O débito técnico acumulado destrói a velocidade futura do time. A qualidade do código não serve à vaidade acadêmica; serve à viabilidade econômica e à longevidade do produto no mercado.</p>

<h3 id="parte-iv-definedesign-de-interação-e-arquitetura">Parte IV: Define — Design de Interação e Arquitetura</h3>

<h3 id="capítulo-8-interaction-design-e-o-poço-dosucesso">Capítulo 8: Interaction Design e o Poço do Sucesso</h3>

<p>Todo desenvolvimento de software é, na essência, design de interação de sistemas. O design de qualquer interface — seja uma UI gráfica ou uma API REST — consiste em selecionar capacidades operacionais e sinalizar como acessá-las com segurança.</p>

<h4 id="affordances-acessibilidades-vs-signifiers-significadores">Affordances (Acessibilidades) vs. Signifiers (Significadores)</h4>

<p>Estes dois conceitos clássicos de Don Norman são as ferramentas de ouro para decifrar como humanos colidem com o seu código ou com as suas telas:</p>

<ul>
  <li><em>Affordances</em> (Acessibilidades): O conjunto de ações possíveis que um objeto permite, intencionais ou não. No código, métodos public em uma classe são affordances expostas para consumo externo.</li>
  <li><em>Signifiers</em> (Significadores): As sinalizações que indicam quais daquelas <em>affordances</em> são recomendadas e seguras. No código, o prefixo _ em métodos Python atua como um anti-significador: a capacidade técnica de execução existe, mas a convenção sinaliza que se trata de uma operação interna restrita.</li>
</ul>

<h4 id="o-semáforo-de-capacidades">O Semáforo de Capacidades</h4>

<p>O autor propõe que dividamos as capacidades expostas do nosso software em três cores principais para guiar o fluxo e evitar acidentes:</p>

<p>Organize as operações do sistema em três zonas de risco:</p>

<ul>
  <li>🟢 <strong>Verde (Operações Seguras)</strong>: Devem contar com significadores claros e atrito zero de execução.</li>
  <li>🟡 <strong>Amarelo (Operações Críticas)</strong>: Mudanças de credenciais, configurações avançadas e exclusões de recursos secundários. Exigem fricções intencionais de segurança (confirmações contextuais e revisões de impacto).</li>
  <li>🔴 <strong>Vermelho (Operações Destrutivas)</strong>: Exclusões irreversíveis de dados e operações financeiras manuais. Exigem barreiras rígidas de autenticação multifator e isolamento de execução.</li>
</ul>

<h4 id="o-poço-do-sucesso-the-pit-of-success-o-caso-facebook-entschema">O Poço do Sucesso (The Pit of Success): O Caso Facebook EntSchema</h4>

<p>Sistemas resilientes constroem o Poço do Sucesso: uma arquitetura desenhada para que o desenvolvedor e o usuário caiam naturalmente no caminho correto, em vez de exigir esforço contínuo para evitar desastres.</p>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/1_0n6ZKLr5EViQYspP3pJknQ.png" alt="" />
  
</figure>

<p>No Facebook, engenheiros frequentemente corrompiam bases de dados ao persistir dados estruturados (e-mails, telefones) em campos genéricos de string (string_fields). Em vez de empilhar manuais de boas práticas que ninguém leria, o time de infraestrutura criou o EntSchema. A ferramenta passou a bloquear o build se um tipo semântico não fosse utilizado (email_string_field), acoplando higienização e validação nativas. A decisão arquitetural correta tornou-se o único caminho executável.</p>

<h3 id="capítulo-9-arquitetura-de-produto-como-diferencial-competitivo">Capítulo 9: Arquitetura de Produto como Diferencial Competitivo</h3>

<p>Decisões de infraestrutura, estratégias de failover e modelos de consistência de dados não são detalhes operacionais isolados; são decisões que definem diretamente a experiência e os limites do produto.</p>

<h4 id="o-efeito-poste-streetlight-effect">O Efeito Poste (Streetlight Effect)</h4>

<p>O Efeito Poste descreve a tendência de gastar energia otimizando o que é fácil de medir ou tecnicamente estimulante, ignorando onde reside o gargalo real do usuário.</p>

<p>É o caso do desenvolvedor que consome duas semanas otimizando um algoritmo local de <em>O(N²)</em> para <em>O(N log N)</em> para economizar 15 milissegundos, enquanto a tela inicial continua bloqueada por 4 segundos aguardando chamadas síncronas a serviços terceiros lentos.</p>

<h4 id="estudo-de-caso-stripe--shopifydisponibilidade-sobre-consistência-imediata">Estudo de Caso: Stripe &amp; Shopify — Disponibilidade sobre Consistência Imediata</h4>

<p>Ao liquidar transações em plataformas parceiras massivas (como a Shopify), a Stripe calculava e persistia as taxas de repasse de forma síncrona na mesma transação de <em>checkout</em> para manter consistência estrita.</p>

<p>Quando instâncias de banco de dados de parceiros oscilavam, a indisponibilidade cascateava e derrubava o <em>checkout</em> principal de lojistas saudáveis independentes.</p>

<p>A engenharia da Stripe reestruturou o fluxo desacoplando as operações: o <em>checkout</em> tornou-se resiliente e isolado, enquanto o cálculo e a reconciliação de taxas foram movidos para filas assíncronas de consistência eventual. A escolha por consistência eventual foi uma decisão estratégica de produto para assegurar 99,999% de disponibilidade no momento crítico de conversão financeira.</p>

<h4 id="consistência-de-dados-orientada-aousuário">Consistência de Dados Orientada ao Usuário</h4>

<p>Em vez de debater abstrações acadêmicas isoladas, projete garantias de consistência que protejam a experiência humana:</p>

<ul>
  <li><strong>Read-your-Writes (RyW)</strong>: O usuário deve enxergar imediatamente a mutação que acabou de disparar. Se uma foto de perfil é atualizada, a interface não pode exibir a imagem antiga no segundo seguinte por atraso de propagação em cache; essa inconsistência gera incerteza e induz o usuário a repetir cliques desnecessários.</li>
  <li><strong>Write-after-others’ Writes (WoW)</strong>: Barreiras de concorrência que impedem que alterações simultâneas de múltiplos usuários em ambientes colaborativos sobrescrevam estados silenciosamente sem tratamento de conflito.</li>
</ul>

<h3 id="conclusão-engenharia-com-propósito-denegócio">Conclusão: Engenharia com Propósito de Negócio</h3>

<p>A saúde da base de código, a sofisticação da arquitetura e o rigor da infraestrutura não existem para alimentar o ego técnico da equipe. Elas existem por um único propósito: garantir a sustentabilidade, a resiliência e a evolução do produto no mercado.</p>

<p>O engenheiro sênior de alto impacto habita as duas fronteiras com naturalidade: mergulha nas complexidades profundas de sistemas distribuídos e concorrência, mas emerge continuamente para respirar o ar da realidade do negócio e do usuário.</p>

<p>Menos apego a código isolado. Mais foco nos contratos e sistemas que sustentam o valor real na ponta.</p>]]></content><author><name>Maiquel Leonel</name><email>maiquel@maiquelleonel.com.br</email></author><category term="Product Engineering" /><category term="Software Architecture" /><category term="Leadership" /><category term="Product Management" /><summary type="html"><![CDATA[Por que a excelência técnica isolada não garante o sucesso de um produto. Como unir System Thinking e Product Thinking para construir software que realmente gera impacto.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://maiquelleonel.com.br/blog/assets/images/1_tPuy3qW6Qasyn27nQk_XmA.jpeg" /><media:content medium="image" url="https://maiquelleonel.com.br/blog/assets/images/1_tPuy3qW6Qasyn27nQk_XmA.jpeg" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">O Harness, o SDD e o Vibe-Coding: uma abordagem de engenharia</title><link href="https://maiquelleonel.com.br/blog/o-harness-o-sdd-e-o-vibe-coding-uma-abordagem-de-engenharia/" rel="alternate" type="text/html" title="O Harness, o SDD e o Vibe-Coding: uma abordagem de engenharia" /><published>2026-05-28T00:00:00+00:00</published><updated>2026-05-28T00:00:00+00:00</updated><id>https://maiquelleonel.com.br/blog/o-harness-o-sdd-e-o-vibe-coding-uma-abordagem-de-engenharia</id><content type="html" xml:base="https://maiquelleonel.com.br/blog/o-harness-o-sdd-e-o-vibe-coding-uma-abordagem-de-engenharia/"><![CDATA[<h3 id="infraestrutura-como-contrato-o-harness-contendo-a-entropia-da-automação">Infraestrutura como contrato: o Harness contendo a entropia da automação</h3>

<p>Mover um software além da fase “mashup” exige substituir a intuição por uma governança de engenharia rígida. No cenário atual, onde agentes de IA escrevem linhas de código em segundos, o papel do engenheiro muda de forma drástica. Em operações orientadas por modelos de linguagem, o gargalo deixa de ser a velocidade de escrita da sintaxe e passa a ser o controle de qualidade. O grande desafio do Software Engineer moderno é garantir que o sistema continue previsível, coerente e sustentável conforme múltiplos ciclos de automação começam a modificar e expandir a base de código de forma autônoma.</p>

<p>Recentemente, resolvi testar essa premissa de forma estruturada em um projeto relativamente pequeno, mas que impõe desafios reais de arquitetura: o <strong>Savage Worlds Dice Roller</strong> — uma extensão de navegador projetada para automatizar mecânicas de RPG dentro do Google Meet.</p>

<p>A ideia inicial parecia simples: rolar dados do meu RPG favorito, enviar os resultados no chat, controlar a iniciativa dos combatentes e sincronizar a rodada. Na prática, contudo, o projeto acabou se tornando um excelente laboratório para avaliar o impacto real do <strong>Specification Driven Development (SDD)</strong>, da governança orientada por contratos, de um harness de validação local e da adoção prática do ecossistema <code class="language-plaintext highlighter-rouge">github/spec-kit</code>.</p>

<p>Mais importante do que validar a tecnologia em si, o objetivo era entender exatamente até onde a IA realmente ajuda a engenharia antes de começar a introduzir um ruído arquitetural caótico e insustentável na base de código.</p>

<hr />

<h3 id="o-problema-do-vibe-coding">O problema do “vibe coding”</h3>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/harness_plausibilidade_local.png" alt="A ilusão da plausibilidade local: o colapso silencioso do código sem fronteiras." />
  
    <figcaption>A ilusão da plausibilidade local: o colapso silencioso do código sem fronteiras.
</figcaption>
  
</figure>

<p>Uma das primeiras evidências colhidas durante o projeto foi a tendência natural que os agentes de IA têm de produzir códigos altamente plausíveis, mas estruturalmente insustentáveis. LLMs não operam sob a lógica do minimalismo arquitetural ou da manutenibilidade de longo prazo; elas tendem à maximização da plausibilidade local, ou seja, leva em conta apenas o contexto imediato que ela esta editando e não como o que ela faz afeta o todo.</p>

<p>Quando o ambiente de desenvolvimento não impõe contratos claros, boundaries definidos, regras de negócio bem estabelecidas ou critérios objetivos de validação, o sistema entra em um fluxo constante de regressão silenciosa. O ciclo vicioso do vibe coding é previsível: o agente gera um trecho que funciona para o escopo imediato, mas quebra uma feature correlata; em seguida, ele corrige a quebra, mas refatora um bloco estável sem necessidade e altera comportamentos globais de forma imperceptível. Tudo parece individualmente coerente em nível local, mas globalmente o sistema degrada. Essa entropia ficou nítida já nas primeiras iterações do plugin, antes que eu começasse a estruturar formalmente os contratos de arquitetura.</p>

<hr />

<h3 id="por-que-savage-worlds">Por que Savage Worlds?</h3>

<p>A escolha pelo motor de regras de Savage Worlds foi proposital, justamente por apresentar problemas complexos de modelagem matemática e gerenciamento de estado. A mecânica de dados do sistema não é linear, exigindo regras de <em>Exploding Dice</em> — onde o maior resultado possível em um dado libera rolagens adicionais cumulativas ad infinitum — , além do cálculo de falhas críticas combinadas entre o dado de atributo e o dado selvagem (<em>Wild Die</em>). Soma-se a isso a necessidade de gerenciar dinamicamente modificadores de bônus e ônus sobre múltiplos fluxos probabilísticos.</p>

<p>Outro desafio legal foi o baralho na iniciava. O sistema exige a modelagem fiel de um baralho completo de 54 cartas, incluindo os Curingas. Isso impõe à arquitetura o controle de estados primitivos e persistencia de descarte; a ordenação de desempate é baseada nos naipes, gatilhos de embaralhamento e a propagação de efeitos. Lidar com essa alternância de estados e regras determinísticas tornou o projeto o ambiente perfeito pros meus testes.</p>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/harness_dice_unsplash.jpg" alt="Photo by Ian Talmacs on Unsplash" />
  
    <figcaption>Photo by Ian Talmacs on Unsplash
</figcaption>
  
</figure>

<hr />

<h3 id="a-primeira-decisão-importante-separar-completamente-core-e-interface">A primeira decisão importante: Separar completamente Core e Interface</h3>

<p>A premissa inicial de design foi isolar completamente o Core da Interface. Determinei desde o primeiro ciclo que o arquivo <code class="language-plaintext highlighter-rouge">core.js</code> deveria conter apenas lógica pura e funcional. Ele não pode conhecer o DOM, o navegador, o ecossistema do Google Meet ou qualquer elemento HTML. Toda a inteligência das regras de jogo, o processamento de dados e o sorteio de cartas existem de forma isolada, enquanto o arquivo <code class="language-plaintext highlighter-rouge">content.js</code> atua estritamente como uma periferia burra de integração com o browser. Essa camada externa captura o evento gerado na interface do usuário, despacha a carga de dados para o core, recebe uma resposta puramente estruturada e injeta o texto final formatado no chat. Esse desacoplamento radical facilitou pra cacete a escrita de testes de comportamento isolados, eliminando por completo a necessidade de acoplar abstrações pesadas ou emuladores de ambiente como o JSDOM.</p>

<hr />

<h3 id="tá-e-por-que-bun">Tá, e por que Bun?</h3>

<p>A decisão de adotar o Bun no lugar do Node.js tradicional ou do Deno foi estritamente orientada à eficiência e à redução drástica do tempo do feedback loop, um fator crítico quando trabalhamos com automação assistida por IA. O test runner nativo do Bun executa dezenas de testes em aproximadamente 5 milissegundos rodando sobre o JavaScriptCore. Além da velocidade pura de processamento, o Bun oferece um bundler embutido que simplificou o empacotamento dos módulos ES nativos para a extensão sem o atrito de gerenciar configurações complexas de Webpack ou Vite. Esse conjunto robusto e integrado de infraestrutura permitiu mover praticamente todas as travas de validação para githooks locais executados antes do commit. O código gerado pelo agente de IA simplesmente não sai da máquina se quebrar as regras básicas ou o limite de cobertura estabelecido.</p>

<hr />

<h3 id="onde-a-ia-falhou-de-forma-perigosa">Onde a IA falhou de forma perigosa</h3>

<p>Os problemas mais complexos não surgiram na geração de sintaxe limpa, mas sim quando o projeto começou a evoluir e o agente de IA tentou tomar decisões de design de forma autônoma. O caso mais emblemático ocorreu quando o Gemini decidiu remover por completo o <code class="language-plaintext highlighter-rouge">github/spec-kit</code> do projeto. O modelo demorou de dois a quatro ciclos para compreender o contexto da ferramenta e acabou confundindo o framework oficial do GitHub com um pacote antigo e homônimo do ecossistema Node.js (AJV). Sugerindo replicar a estrutura da maneira dela mas ignorando os limites da ferramenta que roda em python. E não faz parte do projeto.</p>

<p>Outro erro crônico surgiu na escrita de testes. Como o sistema lida com a aleatoriedade de dados e cartas, o agente insistia em refatorar as funções de negócio e testar pontos flutuantes de forma dinâmica, mas escrevendo asserts estáticos e fixos no runner. Os testes passavam de primeira, mas mascaravam regressões silenciosas nas ramificações probabilísticas. Precisei de uns cinco ciclos de atrito manual para endurecer as restrições e forçar a IA a injetar um gerador de dados estático pra ajustar as asserções. Além disso, em momentos como a Task 002, o modelo demonstrou uma clara tendência ao overengineering desnecessário, tentando desenhar uma arquitetura complexa baseada em eventos para monitorar a presença de usuários no chat de um MVP que sequer possuía tráfego real.</p>

<hr />

<h3 id="agentsmd-e-architecturemd-restrições-sobre-prompts">AGENTS.md e ARCHITECTURE.md: Restrições sobre prompts</h3>

<p>Conforme o volume de iterações crescia, ficou evidente que guiar o comportamento do agente utilizando apenas prompts longos e voláteis escala muito mal. Para mitigar esse problema, formalizei a governança do repositório através de dois manifestos em Markdown: o <code class="language-plaintext highlighter-rouge">ARCHITECTURE.md</code> e o <code class="language-plaintext highlighter-rouge">AGENTS.md</code>. Longe de servirem como uma documentação passiva para fins organizacionais, esses arquivos funcionam como políticas executáveis de restrição para a IA.</p>

<p>O <code class="language-plaintext highlighter-rouge">ARCHITECTURE.md</code> delimita as fronteiras arquiteturais, contratos de interface e regras de isolamento de código do projeto. Já o <code class="language-plaintext highlighter-rouge">AGENTS.md</code> funciona como o manual de conduta operacional da LLM, especificando detalhadamente o que ela tem permissão para alterar, o que é inegociável e quais regras de negócio não podem sofrer refatoração sob hipótese alguma. Com essas barreiras documentadas no repositório, o próprio agente de IA passou a analisar suas intenções de refatoração contra os arquivos de restrição, invalidando suas próprias propostas de reescrita desnecessária antes mesmo de tocar no código fonte estável.</p>

<hr />

<h3 id="entrando-no-spec-kit-via-gemini-cli">Entrando no Spec-Kit via gemini-cli</h3>

<p>A introdução do <code class="language-plaintext highlighter-rouge">github/spec-kit</code> ocorreu com a arquitetura do plugin já estabilizada pelos manifestos de restrição, servindo como uma excelente validação de adoção do framework em bases de código legadas. O speckit funciona diretamente no <code class="language-plaintext highlighter-rouge">gemini-cli</code>, transformando a governança conceitual em um pipeline opinativo e sequencial comandado por CLI. O primeiro comando depois de tudo instalado é o <code class="language-plaintext highlighter-rouge">/speckit.constitution</code>, que faz o modelo a mapear o repositório, assimilar o <code class="language-plaintext highlighter-rouge">ARCHITECTURE.md</code> e o <code class="language-plaintext highlighter-rouge">AGENTS.md</code> e entender as fundações da arquitetura na pasta <code class="language-plaintext highlighter-rouge">.specify/memory/</code>. A partir dessa consciência técnica, o fluxo avança pelas fases de especificação detalhada da issue (<code class="language-plaintext highlighter-rouge">/speckit.specify</code>), desenho estruturado do plano de mudanças (<code class="language-plaintext highlighter-rouge">/speckit.plan</code>) e consolidação do checklist de tarefas e critérios de aceitação (<code class="language-plaintext highlighter-rouge">/speckit.tasks</code>); por fim <code class="language-plaintext highlighter-rouge">/speckit.implement</code> para codificar a solução.</p>

<p>Esse cerimonial retira a liberdade criativa da IA; eu nem abria mais o <code class="language-plaintext highlighter-rouge">core.js</code> ou <code class="language-plaintext highlighter-rouge">content.js</code> durante o processo. Se noto que o modelo começou a poluir o plano com tarefas redundantes ou desalinhadas, edito o enunciado do escopo, rodo o comando <code class="language-plaintext highlighter-rouge">/speckit.clarify</code> e o framework reconfigura automaticamente todo o grafo de dependências das tarefas. O experimento também expôs uma resistência comportamental interessante das LLMs: em múltiplos momentos, o Gemini tentava me convencer a abandonar a burocracia do Spec-Kit, alegando que já havia compreendido o padrão e poderia codificar diretamente “na mão” para acelerar o processo. As IAs tentam constantemente otimizar o ganho de curto prazo removendo a fricção operacional; cabe ao engenheiro manter a rigidez framework assim com fazemos com Django ou Rails.</p>

<hr />

<h3 id="quality-gates-e-o-harness-operacional">Quality Gates e o Harness Operacional</h3>

<p>O sucesso prático do laboratório residiu na robustez do Harness de automação local, desenhado sob a premissa de que nenhuma modificação de código atinge o repositório remoto sem passar por travas estritas de validação. O pipeline de integração une branchs principais protegidas e validação contínua no CI via GitHub Actions. O runner de testes foi configurado via <code class="language-plaintext highlighter-rouge">test:threshold</code> para exigir cobertura obrigatória de 100% no core do sistema; se a IA introduzir qualquer linha sem teste, o build falha. Como a suíte do Bun executa em 5 milissegundos, integrei os testes em um git-hook pre-commit. Se o agente de IA falhar em atender ao contrato ou introduzir uma regressão lúdica, a ferramenta barra a operação localmente e mantém o modelo em um loop contínuo de autocorreção antes que qualquer linha de código inválida seja empurrada para a esteira remota do GitHub Actions.</p>

<p>A definição e a manutenção dos arquivos <code class="language-plaintext highlighter-rouge">AGENTS.md</code> e <code class="language-plaintext highlighter-rouge">ARCHITECTURE.md</code> foram mantidas sob controle estritamente humano e manual. Enquanto deleguei ao agente a capacidade de codar e gerar artefatos de tarefas e planos, as definições de boundaries, tolerâncias de erro e contratos abstratos de negócio permanecem comigo. Essa separação de responsabilidades provou ser obrigatória para o sucesso de qualquer projeto sério que utilize automação assistida por IA.</p>

<hr />

<h3 id="o-trade-off-real-do-sdd">O trade-off real do SDD</h3>

<p>Adotar o Spec-Driven Development significa aceitar desacelerar brutalmente os primeiros 20% do projeto para obter uma aceleração previsível e exponencial nos 80% restantes. Esse modelo impõe um custo real de overhead cognitivo e um processo burocrático massivo no início do ciclo. As primeiras tentativas foram exaustivas, demandando revisões manuais constantes, respostas a perguntas redundantes do modelo e um esforço alto de engenharia para contornar problemas de compatibilidade do pacote <code class="language-plaintext highlighter-rouge">node-pty</code> entre o <code class="language-plaintext highlighter-rouge">gemini-cli</code> e o Bun.</p>

<p>No início, a sensação é de pura burocracia, dado que uma única linha de intenção gera dezenas de arquivos Markdown populando a pasta <code class="language-plaintext highlighter-rouge">.specify</code>. O ganho de eficiência só se manifestou após algumas iterações, quando o aprendi a escrever specs melhores. Quanto mais precisa, concisa, granular e contextualizada for a spec inicial, mais liso o agente executa o código final.</p>

<p>Com a maturidade obtida no uso do framework, o tempo de ciclo para implementar uma nova funcionalidade completa despencou para menos de trinta minutos: gastam-se cerca de dois minutos definindo o escopo, vinte minutos refinando e validando o plano gerado pelo agente, cinco minutos na escrita automatizada do código fonte via <code class="language-plaintext highlighter-rouge">/speckit.implement</code> e cinco minutos em um teste manual de fumaça dentro do navegador.</p>

<hr />

<h3 id="os-números-e-o-ganho-real">Os Números e o Ganho Real</h3>

<p>A engenharia baseada em métricas sólidas demonstra que o ganho real de produtividade ao adotar o SDD e o Spec-Kit reside na redução do Custo de Mudança e no controle estatístico de falhas. O repositório atualmente conta com 29 testes, o tempo de compilação fixado em 4 milissegundos e uma taxa histórica de regressão controlada em 3.77%. O esforço de desenvolvimento do plugin estabilizou em uma distribuição onde 80% do código fonte é escrito de forma automatizada pela IA e 20% do tempo é despendido no design humano de contratos e especificações. O tempo necessário para onboardar e estabilizar uma nova feature caiu de um ciclo errático de até duas horas de iteração com IA para um fluxo determinístico de menos de meia hora.</p>

<p>Essa mudança transformou radicalmente a minha postura em Code Reviews: o foco deixou de ser a revisão estática de sintaxe ou estilo de escrita — fatores que viraram subproduto irrelevante do pipeline automatizado. Hoje, o diff do pull request é auditado estritamente para avaliar a preservação de contratos de dados, o isolamento dos boundaries e o respeito às regras de negócio mapeadas na especificação. Se a IA cumpre o contrato, a implementação física do algoritmo torna-se secundária.</p>

<hr />

<h3 id="conclusão-governança-é-o-novo-framework">Conclusão: Governança é o novo Framework</h3>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/harness_governanca_eterna.png" alt="O código atual é efêmero e descartável. A governança e os contratos são eternos." />
  
    <figcaption>O código atual é efêmero e descartável. A governança e os contratos são eternos.
</figcaption>
  
</figure>

<p>A indústria de tecnologia atual sofre de um desalinhamento sério: muito se propaga sobre a eficiência operacional do desenvolvimento por IA, mas pouquíssimos casos reais de engenharia estruturada são expostos (muito se fala, pouco se mostra). O mercado vive um cenário saturado de discursos evangelistas baseados em truísmos comerciais e demonstrações rasas em Streamlit que ocultam problemas severos de concorrência, conciliação de estado e manutenibilidade a longo prazo. Foca-se no ganho imediato de digitação de código e negligencia-se a arquitetura de software, gerando um débito técnico invisível e catastrófico.</p>

<p>A evolução prática deste laboratório aponta para a mudança de paradigma inevitável na carreira técnica de engenheiros seniores e líderes de plataforma. Na era dos agentes, o profissional perde relevância se indicar que quer se posicionar apenas como coder. Escrever linhas de código virou uma commodity de execução automatizada e barata. O engenheiro moderno precisa subir um degrau na abstração técnica e assumir o papel de arquiteto do sistema que gera o sistema. Nosso valor reside em desenhar as fronteiras invisíveis da arquitetura, estabelecer as restrições de governança das LLMs e garantir a solidez das esteiras automatizadas de validação lógica. O código gerado tornou-se efêmero e descartável. Se eu deletar a pasta <code class="language-plaintext highlighter-rouge">src/</code> do repositório hoje, o sistema não morre; ele continua preservado nas especificações, nos contratos de dados, nas travas do Harness e nas regras de negócio da pasta <code class="language-plaintext highlighter-rouge">.specify</code>. O software moderno deixou de ser um bloco de código fonte para se transformar em uma compilação de constraints arquiteturais controladas por humanos.</p>

<hr />

<p>🔬 <strong>Repositório do projeto:</strong> <a href="https://github.com/maiquelleonel/savage-dice-roller">https://github.com/maiquelleonel/savage-dice-roller</a><br />
🎲 <strong>Link do plugin:</strong> <a href="https://chromewebstore.google.com/detail/savage-worlds-dice-roller/gbchefnadoljbafdaaccjkoffghbagoe">https://chromewebstore.google.com/detail/savage-worlds-dice-roller/gbchefnadoljbafdaaccjkoffghbagoe</a></p>]]></content><author><name>Maiquel Leonel</name><email>maiquel@maiquelleonel.com.br</email></author><category term="Spec Driven Development" /><category term="AI Agents" /><category term="Software Engineering" /><category term="DevOps" /><summary type="html"><![CDATA[Mover um software além da fase mashup exige substituir a intuição por uma governança de engenharia rígida. Estudo de caso com Savage Worlds Dice Roller, Bun e Spec-Kit.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://maiquelleonel.com.br/blog/assets/images/capa_harness.png" /><media:content medium="image" url="https://maiquelleonel.com.br/blog/assets/images/capa_harness.png" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">SPRINT: O método para validar e lançar grandes ideias em apenas 5 dias</title><link href="https://maiquelleonel.com.br/blog/sprint-o-metodo-para-validar-e-lancar-grandes-ideias-em-apenas-5-dias/" rel="alternate" type="text/html" title="SPRINT: O método para validar e lançar grandes ideias em apenas 5 dias" /><published>2019-06-26T00:00:00+00:00</published><updated>2019-06-26T00:00:00+00:00</updated><id>https://maiquelleonel.com.br/blog/sprint-o-metodo-para-validar-e-lancar-grandes-ideias-em-apenas-5-dias</id><content type="html" xml:base="https://maiquelleonel.com.br/blog/sprint-o-metodo-para-validar-e-lancar-grandes-ideias-em-apenas-5-dias/"><![CDATA[<p>Sabe aquelas reuniões intermináveis que nunca chegam a lugar nenhum? Aquele produto que você passou meses construindo para descobrir que ninguém queria usar? O livro <strong>SPRINT: O método usado no Google para testar e aplicar novas ideias em apenas cinco dias</strong> traz a resposta direta para esse pesadelo corporativo.</p>

<p>Criado por Jake Knapp no Google Ventures e testado em dezenas de startups (como Slack, Blue Bottle Coffee e Flatiron Health), o Design Sprint é um processo estruturado de cinco dias para responder a perguntas críticas de negócios através de design, prototipagem e testes rápidos com clientes reais.</p>

<p>Abaixo, consolidei um resumo prático e guia de campo de cada etapa da semana.</p>

<hr />

<h3 id="segunda-feira-mapear-o-problema">Segunda-feira: Mapear o Problema</h3>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/sprint_segunda.jpg" alt="Photo by Paul Hanaoka on Unsplash" />
  
    <figcaption>Photo by Paul Hanaoka on Unsplash
</figcaption>
  
</figure>

<p>O primeiro dia é dedicado a entender o terreno e escolher onde focar a energia do time:</p>

<ol>
  <li><strong>Comece pelo fim:</strong> Defina o objetivo de longo prazo. Onde a empresa/produto quer estar daqui a seis meses ou um ano?</li>
  <li><strong>Liste as perguntas críticas:</strong> O que precisa ser verdade para alcançarmos esse objetivo? Se o projeto fracassar, qual será o motivo?</li>
  <li><strong>Faça o mapa do fluxo:</strong> Desenhe um mapa simples de 5 a 15 passos mostrando como o cliente interage com o seu produto, do primeiro contato ao objetivo final.</li>
  <li><strong>Pergunte aos especialistas:</strong> Entreviste pessoas-chave da equipe (produto, tecnologia, marketing, vendas) para coletar insights e identificar pontos cegos.</li>
  <li><strong>Notas “Como Poderíamos” (How Might We):</strong> Transforme problemas em oportunidades anotando perguntas em post-its.</li>
  <li><strong>Escolha o Alvo:</strong> O Definidor (Decider) seleciona um único cliente-alvo e um momento crítico no mapa para resolver durante o Sprint.</li>
</ol>

<hr />

<h3 id="terça-feira-esboçar-soluções">Terça-feira: Esboçar Soluções</h3>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/sprint_terca.jpg" alt="Photo by Danae Paparis on Unsplash" />
  
    <figcaption>Photo by Danae Paparis on Unsplash
</figcaption>
  
</figure>

<p>Na terça, o foco migra da análise para a criação de soluções individuais em paralelo:</p>

<ol>
  <li><strong>Demonstrações-Relâmpago (Lightning Demos):</strong> Apresentações de 3 minutos de produtos e ideias inspiradoras de outros mercados.</li>
  <li><strong>Processo de 4 Etapas para Esboçar:</strong>
    <ul>
      <li><strong>Anotações:</strong> Coleta livre de ideias e lembretes do mapa.</li>
      <li><strong>Ideias:</strong> Rascunhos rápidos e primeiras hipóteses visuais.</li>
      <li><strong>Crazy 8’s:</strong> Dobre uma folha em 8 partes e esboce 8 variações em 8 minutos (força o cérebro a sair do óbvio).</li>
      <li><strong>Storyboard de Solução (3 painéis):</strong> Cada membro cria anonimamente um plano detalhado e autoexplicativo da sua solução.</li>
    </ul>
  </li>
  <li><strong>Recrutamento:</strong> Inicie o processo de recrutamento dos 5 clientes para os testes de sexta-feira.</li>
</ol>

<hr />

<h3 id="quarta-feira-decidir-a-melhor-abordagem">Quarta-feira: Decidir a Melhor Abordagem</h3>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/sprint_quarta.jpg" alt="Photo by Caleb Jones on Unsplash" />
  
    <figcaption>Photo by Caleb Jones on Unsplash
</figcaption>
  
</figure>

<p>Metade da semana é o momento da verdade: escolher as melhores ideias sem debates infinitos:</p>

<ol>
  <li><strong>Museu de Arte:</strong> Cole todos os storyboards anonimamente na parede.</li>
  <li><strong>Mapa de Calor:</strong> Cada participante cola adesivos pequenos nas partes que mais gostar (sem falar).</li>
  <li><strong>Crítica-Relâmpago:</strong> O facilitador repassa cada storyboard em 3 minutos destacando as ideias mais votadas.</li>
  <li><strong>Pesquisa de Opinião:</strong> Cada pessoa dá 1 voto oficial na sua ideia favorita.</li>
  <li><strong>Supervoto:</strong> O Definidor toma a decisão final com seus votos decisivos.</li>
  <li><strong>Roteiro Quadro a Quadro (Storyboarding):</strong> Monte um roteiro de 10 a 15 quadros detalhando o fluxo passo a passo que será prototipado.</li>
</ol>

<hr />

<h3 id="quinta-feira-prototipar-fachada-de-hollywood">Quinta-feira: Prototipar (Fachada de Hollywood)</h3>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/sprint_quinta.jpg" alt="Photo by Hal Gatewood on Unsplash" />
  
    <figcaption>Photo by Hal Gatewood on Unsplash
</figcaption>
  
</figure>

<p>O objetivo da quinta-feira não é construir código de produção, mas criar uma ilusão convincente (<em>Goldilocks Quality</em>):</p>

<ol>
  <li><strong>Mindset do Protótipo:</strong> “Falso o suficiente para aprender, realista o suficiente para engajar”.</li>
  <li><strong>Dividir e Conquistar:</strong>
    <ul>
      <li><strong>Makers:</strong> Montam as telas/telas no Figma, Keynote ou HTML leve.</li>
      <li><strong>Stitcher (Costureiro):</strong> Junta as partes e garante consistência de tom e design.</li>
      <li><strong>Writer (Redator):</strong> Escreve textos realistas (evite <em>Lorem Ipsum</em> a todo custo).</li>
      <li><strong>Asset Collector:</strong> Busca ícones, fotos e logos realistas.</li>
      <li><strong>Entrevistador:</strong> Finaliza o roteiro da entrevista de sexta-feira.</li>
    </ul>
  </li>
  <li><strong>Ensaio Geral:</strong> No final da tarde, faça um teste de fumaça interno do início ao fim.</li>
</ol>

<hr />

<h3 id="sexta-feira-testar-com-clientes-reais">Sexta-feira: Testar com Clientes Reais</h3>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/sprint_sexta.jpg" alt="Photo by José Alejandro Cuffia on Unsplash" />
  
    <figcaption>Photo by José Alejandro Cuffia on Unsplash
</figcaption>
  
</figure>

<p>O ápice do Sprint: observar pessoas reais usando o protótipo:</p>

<ol>
  <li><strong>A Regra dos 5 Usuários:</strong> Jakob Nielsen comprovou que 85% dos problemas de usabilidade são identificados com apenas 5 testes.</li>
  <li><strong>Entrevista em 5 Atos:</strong>
    <ul>
      <li>Boas-vindas calorosas e quebra-gelo.</li>
      <li>Perguntas de contexto sobre a rotina do usuário.</li>
      <li>Apresentação do protótipo (lembrando que estamos testando o produto, não a pessoa).</li>
      <li>Tarefas orientadas com pensamento em voz alta (<em>Think Aloud</em>).</li>
      <li>Desbriefing rápido sobre a percepção geral.</li>
    </ul>
  </li>
  <li><strong>Observação ao Vivo:</strong> O restante do time assiste em outra sala anotando aprendizados em post-its (verde para positivo, vermelho para atrito).</li>
</ol>

<hr />

<h3 id="conclusão-aprendizado-validado">Conclusão: Aprendizado Validado</h3>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/sprint_conclusao.jpg" alt="Photo by SpaceX on Unsplash" />
  
    <figcaption>Photo by SpaceX on Unsplash
</figcaption>
  
</figure>

<p>No final da sexta-feira, você terá respostas concretas para as perguntas mais difíceis do seu negócio. Mesmo que o protótipo falhe, você economizou meses de desenvolvimento, dinheiro em servidores e energia da equipe em uma ideia que não tinha tração.</p>

<p>O Sprint não é apenas uma ferramenta de design — é uma postura de engenharia pragmática: <strong>validar antes de construir.</strong></p>]]></content><author><name>Maiquel Leonel</name><email>maiquel@maiquelleonel.com.br</email></author><category term="Product Design" /><category term="Design Sprint" /><category term="Agile" /><category term="Innovation" /><summary type="html"><![CDATA[Como a metodologia do Google Ventures ajuda times de tecnologia a validar hipóteses de produto em apenas 5 dias antes de escrever uma única linha de código.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://maiquelleonel.com.br/blog/assets/images/sprint_capa.jpg" /><media:content medium="image" url="https://maiquelleonel.com.br/blog/assets/images/sprint_capa.jpg" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">Usando Raspberry Pi, rsync e inotify para um video wall de baixo custo</title><link href="https://maiquelleonel.com.br/blog/usando-raspberry-pi-rsync-e-inotify-para-um-video-wall-de-baixo-custo/" rel="alternate" type="text/html" title="Usando Raspberry Pi, rsync e inotify para um video wall de baixo custo" /><published>2018-04-10T00:00:00+00:00</published><updated>2018-04-10T00:00:00+00:00</updated><id>https://maiquelleonel.com.br/blog/usando-raspberry-pi-rsync-e-inotify-para-um-video-wall-de-baixo-custo</id><content type="html" xml:base="https://maiquelleonel.com.br/blog/usando-raspberry-pi-rsync-e-inotify-para-um-video-wall-de-baixo-custo/"><![CDATA[<p>Sabe aquele brinquedo que tu sempre quis brincar, desmontar e entender como funciona? Tipo o Atari que tu teves na infância? Ok, no meu caso um CCE Supergame mas né… Anos 80, portos fechados, a gente nem era tão exigente com as marcas naquela época… Enfim, sempre me senti assim com o Raspberry Pi.</p>

<p>O Raspberry Pi é um “miniPC” de baixíssimo custo. Tu encontras a versão mais potente dele, a Model B+, por cerca de U$40,00. Sim o “PC” completo, com processador Quad Core 1.2GHz, 4 portas USB, rede wifi e RJ-45, saída HDMI e 1GB de RAM por 40 “trumps”?! É muito barato! Lembrando que outras versões não tão atuais do PCzinho com menos processamento e RAM são ainda mais baratas! Chegando a versões de U$20,00 ou menos.</p>

<figure>
  <img src="https://maiquelleonel.com.br/blog/assets/images/1_1-TBFdfsQVQHGONx4vJz_A.jpeg" alt="Raspberry Pi 3 model B+ 1GB de RAM" />
  
    <figcaption>Raspberry Pi 3 model B+ 1GB de RAM
</figcaption>
  
</figure>

<p>Agora tu deves estar se perguntando: “Tá! Mas o que eu farei com um Hardware tão modesto?” Bom, existe uma série de utilidades pro PCzinho. Sério são muitas mesmo! Uma olhada nesse site de projetos já te deixa envolvido por horas a fio.</p>

<p>Falando da distro GNU/Linux que o RaspberryPi embarca: ela é a Raspbian, uma derivada de Debian com os drivers, ambiente gráfico e outros apps escolhidos “a dedo” pra funcionar perfeitamente no PCzinho. Sou entusiasta de Debian (e derivadas) desde 2004/2005, não tive dificuldade nenhuma. Foi só escolher os softwares certos e correr pro abraço!</p>

<hr />

<h2 id="o-problema">O PROBLEMA</h2>

<p>O projeto é bem simples: tocar videos de propaganda em loop nos “terminais” do quiosque, de maneira que os vídeos pudessem ser periodicamente atualizados. Basicamente: um “videolooper atualizável”. Depois de algumas tentativas com outras ferramentas conhecidas de “arquivos em nuvem” que não rodaram bem com o RaspberryPi, decidimos resolver de uma maneira mais “braçal” porém funcional.</p>

<hr />

<h2 id="a-solução">A SOLUÇÃO</h2>

<p>A solução que desenhamos foi bem sucinta: um usuário sobe um video para um FTP específico, o RaspberryPi monitora esse endereço via rsync e o inotify-tools informa o sistema operacional que recebeu um novo vídeo, o S.O. por sua vez faz um reboot para que o novo video comece a tocar no video looper e tudo sincroniza automágicamente :D. Barbada né? Pois é, nem tanto.</p>

<hr />

<h2 id="a-implantação">A IMPLANTAÇÃO</h2>

<p>Depois de instalado o videolooper, precisei mexer na cron do Raspberry para agendar a execução tanto o rsync quanto do inotify. O detalhe é que, seja lá por qual motivo, a cron de usuário simplesmente não funcionou. De jeito nenhum! Nem agendando na cron do root, nem salvando do /etc/hourly.d/. O jeito foi salvar na cron do sistema mesmo. Depois ainda descobri no stackOverflow que é um “detalhe” da própria distro. Feito isso, conseguimos o comportamento esperado.</p>

<hr />

<h2 id="aquele-super-detalhamento-maroto">AQUELE SUPER-DETALHAMENTO MAROTO</h2>

<p>A primeira coisa a se fazer é instalar as libs rsync e inotify-tools com o apt velho de guerra. Pensei que fosse preciso configurar algum PPA mas pra minha surpresa ambos estavam no mirror do Raspbian. Então foi muito simples.</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nv">$ </span><span class="nb">sudo </span>apt <span class="nb">install </span>rsync inotify-tools
</code></pre></div></div>

<p>Dependências instaladas, o show pode começar. A primeira tarefa é fazer o rsync monitorar a pasta remota na pasta que o videolooper lerá. Isso eu farei por um shellscript. Crio um arquivo chamado <code class="language-plaintext highlighter-rouge">atualizador.sh</code>, dou permissão de execução com o comando <code class="language-plaintext highlighter-rouge">chmod +x atualizador.sh</code>, e adiciono o seguinte conteúdo:</p>
<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c">#!/bin/bash</span>

<span class="nv">RSYNC</span><span class="o">=</span>/usr/bin/rsync
<span class="nv">SSH</span><span class="o">=</span>/usr/bin/ssh
<span class="nv">KEY</span><span class="o">=</span>/home/pi/.ssh/remoteuser_rsa.pem
<span class="nv">RUSER</span><span class="o">=</span>remoteuser
<span class="nv">RHOST</span><span class="o">=</span>remotehost.com.br
<span class="nv">RPATH</span><span class="o">=</span>/home/remoteuser/videos/<span class="k">*</span>
<span class="nv">LPATH</span><span class="o">=</span>/home/pi/Videos/

<span class="nv">$RSYNC</span> <span class="nt">-razp</span> <span class="nt">--force</span> <span class="nt">--delete-before</span> <span class="nt">--ignore-errors</span> <span class="nt">-e</span> <span class="s2">"</span><span class="nv">$SSH</span><span class="s2"> -i </span><span class="nv">$KEY</span><span class="s2">"</span> <span class="nv">$RUSER</span>@<span class="nv">$RHOST</span>:<span class="nv">$RPATH</span> <span class="nv">$LPATH</span>
<span class="nb">exit </span>0
</code></pre></div></div>

<p>Explicando detalhadamente: o que fiz foi deixar em variáveis tudo o que vamos precisar para diminuir o tamanho do comando e melhorar a legibilidade. Ficou uma variável por linha e o comando no final, façinho!</p>

<p>Onde:</p>
<ul>
  <li><strong>RSYNC</strong>: é o path para o binário do rsync</li>
  <li><strong>SSH</strong>: é a path para o shell</li>
  <li><strong>KEY</strong>: é a chave de acesso</li>
  <li><strong>RUSER</strong>: é o usuário para conectar no servidor remoto</li>
  <li><strong>RHOST</strong>: é o endereço do servidor remoto</li>
  <li><strong>RPATH</strong>: é o caminho onde os vídeos serão upados periódicamente</li>
  <li><strong>LPATH</strong>: é o caminho local onde serão salvos os vídeos</li>
</ul>

<p>A última linha é o comando em si, as opções são as seguintes:</p>

<ul>
  <li>-r de cópia recursiva</li>
  <li>-a de modo arquivamento</li>
  <li>-z para compactar o arquivo durante a transferência (e descompactar no destino)</li>
  <li>-p para preservar as permissões do arquivo</li>
  <li>–force para executar sem confirmação</li>
  <li>–delete-before para excluir o destino antes da tranferência</li>
  <li>–ignore-errors para não levantar erros no shell, travando o script</li>
  <li>-e para dizer pro rsync usar a autenticação via SSH em detrimento da SFTP, assim não trafegamos senhas em texto plano pela rede.</li>
</ul>

<p>*Aqui poderíamos usar um SFTP sem grandes problemas a não ser a senha desse usuário restrito rolar pela rede indiscriminadamente. Logo o SSH sobre SFTP se mostra mais seguro e rápido também. Mas vai de cada cenário.</p>

<p>Feito isso, agora temos que dizer pro Raspbian que queremos consultar o servidor remoto, a cada 1h, em busca de novos videos. Fazemos isso agendando na crontab do Raspbian, adicionando ao final do arquivo /etc/contrab a seguinte linha:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">*</span> <span class="k">*</span>/1 <span class="k">*</span> <span class="k">*</span> <span class="k">*</span> root /home/pi/atualizador.sh
</code></pre></div></div>

<p>Só isso bastaria para manter o Raspberry Pi atualizado, entretanto o processo videolooper não era morto pelo S.O. para trocar o video em exibição. A solução aqui foi fazer reboot. Sendo assim, ao final do boot o videolooper sobe e exibe o video atualizado. Com um S.O. rodando em um SDCard, o boot não leva mais de 10 segundos. Um tempo bem aceitável pra um monitor de propaganda</p>

<hr />

<p>Lembrei que tinha feito um teste para uma vaga de emprego anos atrás onde o usuário fazia algo muito similar ao nosso cenário: upava um arquivo com uma métrica expecífica em um diretório e um script fazia o parse desse arquivo de lote, resultando em outros arquivos com conteúdo distinto. Durante a pesquisa pra resolver esse teste foi que eu conheci o inotify-tools. O que esse carinha faz é te dar alguns eventos em arquivos e/ou diretórios que tu configuras para ele monitorar. Assim tu podes saber se determinado recurso foi atualizado, excluído, criado, modificado etc.</p>

<p>Configurar o inotify-tools: Criei um arquivo chamado <code class="language-plaintext highlighter-rouge">monitor.sh</code> (<code class="language-plaintext highlighter-rouge">chmod +x monitor.sh</code>) para executar um reboot sempre que um arquivo no diretório <code class="language-plaintext highlighter-rouge">/home/pi/Videos/</code> for fechado para escrita.</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c">#!/bin/sh</span>
inotifywait <span class="nt">--recursive</span> <span class="nt">--monitor</span> <span class="nt">--quiet</span> <span class="nt">--event</span> close_write <span class="nt">--format</span> <span class="s1">'%f'</span> /home/pi/Videos/ |
<span class="k">while </span><span class="nb">read </span>FILE <span class="p">;</span> <span class="k">do
    </span>reboot
<span class="k">done</span>
</code></pre></div></div>

<p>O que eu faço aí é “dizer” pro inotifywait: execute um reboot sempre que algum recurso de formato ‘%f’ (arquivo) no diretório /home/pi/Videos/ for fechado para escrita, sem avisos, em modo monitor, de maneira recursiva. Os parâmetros são autoexplicativos.</p>

<p>Ao executar o monitor com um ./monitor.sh o inotify faz seu trabalho perfeitamente. Porém, é necessário que pasta seja monitorada pelo inotify na sequência do startup do sistema. Foi só colocar ao final do /etc/crontab a linha:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>@reboot root /home/pi/monitor.sh
</code></pre></div></div>

<p>O Raspberry já esta configurado e pronto pra uso. Bastando instalar os monitores, conectar o monitor na saida HDMI e partir pro abraço! Lembrando que como estou usando a crontab do sistema operacional, é preciso declarar o usuário que executará o comando.</p>

<hr />

<h2 id="pós-instalação">PÓS INSTALAÇÃO</h2>

<p>Depois de pronto acabamos descobrindo que, por algum motivo, o rsync não deletava os arquivos nos Raspberry, mesmo eles sendo deletados do servidor remoto. A solução foi: criar um arquivo vazio com o mesmo nome do video e mandar limpar arquivos vazios junto com a execução do atualizador.sh. Como fiz isso? Simples! Adicionei a seguinte linha logo após o comando do rsync:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>find /home/pi/Videos/ <span class="nt">-type</span> f <span class="nt">-size</span> 0 <span class="nt">-delete</span>
</code></pre></div></div>

<p>Ou seja, busque nesse diretório por recursos tipo file, de tamanho 0 bytes e delete. Assim o atualizador ficou “autolimpante”.</p>

<hr />

<p>Primeiramente, gostaria de agradecer quem leu até aqui. Me esforcei pra ser o mais detalhado e sucinto na explicação de cada passo. “Segundamente”, se gostou desse conteúdo considere compartilhar com a galera. Considere ainda me seguir no github e/ou nas redes sociais. E claro! Deixe suas palminhas :D Comente em caso de dúvida, crítica ou contribuição :). Toda a ajuda é bem-vinda!</p>

<p>Um abraço!</p>]]></content><author><name>Maiquel Leonel</name><email>maiquel@maiquelleonel.com.br</email></author><category term="Linux" /><category term="Raspberry Pi" /><category term="Shell Script" /><category term="Hardware" /><summary type="html"><![CDATA[Como construir um sistema de looping de vídeo automatizado e sincronizado remotamente usando Raspberry Pi, scripts em bash e monitoramento inotify.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://maiquelleonel.com.br/blog/assets/images/1_1-TBFdfsQVQHGONx4vJz_A.jpeg" /><media:content medium="image" url="https://maiquelleonel.com.br/blog/assets/images/1_1-TBFdfsQVQHGONx4vJz_A.jpeg" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">Valet Linux: o servidor web descomplicado</title><link href="https://maiquelleonel.com.br/blog/valet-linux-o-servidor-web-descomplicado/" rel="alternate" type="text/html" title="Valet Linux: o servidor web descomplicado" /><published>2018-04-02T00:00:00+00:00</published><updated>2018-04-02T00:00:00+00:00</updated><id>https://maiquelleonel.com.br/blog/valet-linux-o-servidor-web-descomplicado</id><content type="html" xml:base="https://maiquelleonel.com.br/blog/valet-linux-o-servidor-web-descomplicado/"><![CDATA[<p>O <a href="https://laravel.com/">Laravel</a> possui uma série de facilidades em termos de ambiente pro desenvolvedor. Existe um cara chamado <a href="https://laravel.com/docs/5.6/homestead">Homestead</a>, um ambiente parrudo e com muita coisa otimizada pro Laravel. Porém foi um carinha chamado Valet que roubou minha atenção.</p>

<figure>
  <img src="https://cdn-images-1.medium.com/max/800/1*Y7Uj0OjcIP5eFHdkQQRUmA.png" alt="" />
  
    <figcaption>O servidor “de bolso”
</figcaption>
  
</figure>

<p>O Valet é um ambiente de desenvolvimento minimalista e altamente descomplicado, otimizado para o Laravel e sem uma grande parafernália de instrumentos e configurações por parte do desenvolvedor. Basta clonar o código, apontar o navegador pra pasta do projeto e pronto! Tudo funcionando nos “trinks”! Originalmente liberado para Mac, no github encontrei o <a href="https://laravel.com/docs/5.6/valet">Valet para Linux</a>, com um port bem fiel ao original.</p>

<p>Olha, eu garanto que depois de descobrir o Valet tu nunca mais vai querer saber de configurar ambientes de desenvolvimento na “unha”. Sem Vagrant, sem <code class="language-plaintext highlighter-rouge">/etc/hosts</code> e o mais legal: com <strong>compartilhamento público de url</strong>  usando tunelamento local e “automágico”.</p>

<p>Ainda não sei se a versão pra windows já está estável, mas sei de uma galera que
está tentando portar. Tu encontra o projeto em</p>

<p>*Ainda não sei se a versão pra windows já está estável, mas sei de uma galera que está tentando portar. Se for do teu interesse o projeto está em <a href="https://github.com/cretueusebiu/valet-windows">Valet-windows</a>.</p>

<hr />

<h2 id="instalação">Instalação</h2>

<p>O Valet-linux é construído para PHP e com o PHP. É necessário pelo menos o PHP5.6 e claro o <a href="http://getcomposer.org">composer</a>. Antes de instalá-lo é preciso baixar algumas dependências para que a mágica do Valet aconteça. Assumindo que tu estejas no Ubuntu:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>sudo apt install network-manager libnss3-tools jq xsel
sudo apt install php*-cli php*-curl php*-mbstring php*-mcrypt php*-xml php*-zip
sudo apt install php*-sqlite3 php*-mysql php*-pgsql
</code></pre></div></div>
<p><sup><sup><em>Troque os * pela versão do PHP em uso.</em></sup></sup></p>

<p>Para outras distros e mais detalhes a <a href="https://cpriego.github.io/valet-linux/requirements">documentação</a> é bem completa.
Garantidas as dependências, basta instalar o projeto com:</p>

<p><code class="language-plaintext highlighter-rouge">composer global require cpriego/valet-linux</code></p>

<p>Depois de finalizar a parte do composer basta rodar <code class="language-plaintext highlighter-rouge">valet install</code>.
O Valet identifica a tua distribuição e configura em background tudo que ele
precisa pra funcionar, o <a href="https://nginx.org/en/">Nginx</a>, o <a href="https://en.wikipedia.org/wiki/Dnsmasq">Dnsmasq</a> e todo o resto.</p>

<h3 id="agora-a-mágica-começa">Agora a mágica começa!</h3>

<figure>
  <img src="https://cdn-images-1.medium.com/max/800/1*X8OYKHlK_ZWpLbK0Pxts9g.jpeg" alt="" />
  
    <figcaption>servidor automágico
</figcaption>
  
</figure>

<p>Por padrão o Valet define um “dominio” inicial <code class="language-plaintext highlighter-rouge">.test</code> TLD, que tu podes mudar facilmente com o comando <code class="language-plaintext highlighter-rouge">valet domain [domain]</code>. Entre no diretório do seu Laravel, ou no diretório dos seus projetos, avise o Valet que é pra ele monitorar ali com o comando <code class="language-plaintext highlighter-rouge">valet park</code>. E é isso! <strong>Sim! É só isso!</strong>
Para ver ele em ação basta um <code class="language-plaintext highlighter-rouge">valet open</code> ou apontar o browser para [meuprojeto].test e pronto.
Que mumuzinho né?! Fala sério! :D</p>

<h4 id="outros-recursos">Outros recursos</h4>

<p>O Valet também pode criar links entre projetos ou para pastas que não estão na pasta monitorada.
Por exemplo, pra fazer o phpmyadmin funcionar com ele, navegue até o diretório <code class="language-plaintext highlighter-rouge">/usr/share/phpmyadmin</code>
e dentro dele execute um <code class="language-plaintext highlighter-rouge">valet link phpmyadmin</code>. A partir daí, accesse em <code class="language-plaintext highlighter-rouge">phpmyadmin.test</code>. Isso
pode ser feito para quaisquer diretórios, inclusive dentro do “park”.</p>

<p>Outras “tricks” interessantes são: deixar a rota forçando https, com o comando <code class="language-plaintext highlighter-rouge">valet secure</code>. (Para reverter basta um
<code class="language-plaintext highlighter-rouge">valet unsecure</code> no mesmo diretório) e a mais legal de todas, o comando <code class="language-plaintext highlighter-rouge">valet share</code>.</p>

<p>Esse comando possibilita ao Valet criar facilmente, através do <a href="http://ngrok.io">ngrok</a>, um túnel de DNS
que deixa teu projeto acessível pra todo mundo! Através de um link que pode durar até 7 horas. Demais né?! Para mais opções, comandos e configurações use <code class="language-plaintext highlighter-rouge">valet list</code>.</p>

<p>Vale salientar que o Valet não é um substituto completo pro Vagrant ou pro
Homestead. O foco dele é ter um ambiente local, completo, simples e minimalista.
Até o momento, o Valet tem drivers para <a href="https://laravel.com">Laravel</a> e <a href="https://lumen.laravel.com/">Lumen</a>, além de <a href="https://symfony.com/">Symfony</a>, <a href="https://framework.zend.com/">Zend</a>
<a href="https://cakephp.org/">CakePHP 3</a>, <a href="https://wordpress.org/">WordPress</a>, <a href="https://roots.io/bedrock/">Bedrock</a>, <a href="https://craftcms.com/">Craft</a>, <a href="https://statamic.com/">Statamic</a>, <a href="http://jigsaw.tighten.co/">Jigsaw</a>, HTML estático.</p>

<hr />

<p>Era isso! Se gostou considere compartilhar com a “rapeize”, me seguir no <a href="http://github.com/maiquelleonel">github</a>
e/ou nas redes sociais.</p>

<p>Abraço!</p>]]></content><author><name>Maiquel Leonel</name><email>maiquel@maiquelleonel.com.br</email></author><category term="desenvolvimento web" /><category term="valet" /><category term="laravel" /><category term="nginx" /><category term="php" /><summary type="html"><![CDATA[O Laravel possui uma série de facilidades em termos de ambiente pro desenvolvedor. Existe um cara chamado Homestead, um ambiente parrudo e com muita coisa otimizada pro Laravel. Porém foi um carinha chamado Valet que roubou minha atenção.]]></summary></entry></feed>