Principal Engineer & Cloud Architect. Focado em arquitetura de software, IA agêntica, governança de código (SDD/Harness) e FinOps de inferência local. Menos hype, mais fundamentos e cicatrizes reais de produção.
·
19 min. de leitura
O loop infernal do Vibe Coding e a transição para o SDLC Agêntico
Nas últimas semanas, enquanto pesquisava padrões para estruturar o desenvolvimento com IA além do hype de autocompletes na IDE, assisti aos vídeos-ensaios de Dan Disler (IndyDevDan)¹ sobre fábricas de software autônomas. Me debrucei sobre o tema e devorei a excelente edição pre-release do The Agentic SDLC Handbook² de Daniel Meppiel. E quando a Anthropic publicou na semana passada o seu AI-Native SDLC Playbook³, tudo se encaixou: decidi registrar o que aprendi consumindo esse material e como essa abordagem pode ser o caminho para amplificar de verdade o impacto da nossa entrega de software.
Se a geração mecânica de código virou uma etapa rápida e barata, o gargalo da entrega se desloca para o que está ao redor. Sem redesenhar a definição de requisitos no início e a validação arquitetural no final, acelerar a digitação só serve para afogar a esteira mais rápido.
No entanto, existe um abismo entre o modelo conceitual dos laboratórios de IA e a realidade de manter sistemas corporativos em produção. Segundo o relatório global do Stack Overflow Developer Survey⁴, mesmo com janelas de contexto saltando de 2k para mais de 1 milhão de tokens, o índice de satisfação dos desenvolvedores com tarefas complexas caiu. Estamos na infância da infraestrutura de LLMs: sobra capacidade bruta de processamento estatístico, mas faltam camadas maduras de arquitetura, isolamento e governança determinística.
Pagar licenças de plugins e pedir para o time “conversar com o código” cria uma armadilha operacional: manter o engenheiro preso no loop manual de cada prompt transforma a própria equipe no gargalo da esteira. É sobre como quebrar esse ciclo que vamos falar a seguir.
1. O “Vibe Coding Cliff”: Por que a Intuição Capota no Legado
Programar guiado apenas pela intuição do modelo funciona bem em projetos novos de fim de semana. Em repositórios greenfield, sem histórico, sem regras de negócio acumuladas e sem decisões arquiteturais tácitas, o modelo entrega CRUDs funcionais rapidamente.
O problema é o Vibe Coding Cliff — o ponto em que essa intuição quebra ao encontrar monólitos ou ecossistemas legados de centenas de milhares de linhas.
O Vibe Coding Cliff: o protótipo acelerando contra a muralha de regras não documentadas.
As falhas do agente decorrem principalmente de assimetria de informação:
Diluição de Atenção: Despejar dezenas de arquivos no prompt satura a janela de contexto. O modelo passa a ignorar restrições críticas e apela para padrões estatísticos genéricos.
Interfaces Alucinadas: O agente inventa rotas, métodos e parâmetros plausíveis que nunca existiram na base. O diff parece elegante na leitura superficial, mas explode em tempo de execução.
Quebra das Regras Não Escritas: Aquele remendo de segurança ou trava de concorrência que ninguém documentou, mas todo mundo sabe que não pode mexer, vira alvo fácil. A IA não tem bola de cristal nem toma café com o time: se a restrição só existe na memória dos seniores, o modelo vai atropelar com a maior confiança do mundo.
2. O Business Case e a Lei de Amdahl: O Problema do Denominador
Para lideranças de engenharia, a eficiência agêntica segue a Lei de Amdahl⁵: o ganho de velocidade de um sistema é limitado pela fração do processo que não pode ser acelerada.
No ciclo clássico de entrega:
Tempo Total = Planejamento + Design + Codificação + Testes + Revisão / Deploy
Escrever sintaxe consome entre 20% e 35% do tempo total de um desenvolvedor sênior. O restante é dedicado a entender requisitos, alinhar contratos entre squads, desenhar arquitetura e investigar logs de produção.
Ao reduzir o tempo mecânico de escrita de dias para minutos, o gargalo se desloca para as extremidades:
Com planejamento vago e revisões dependentes de humanos lendo diffs de 2.000 linhas geradas por IA, a revisão se torna o novo denominador da esteira. Analisar código denso gerado automaticamente exige alta carga cognitiva. Acelerar a geração sem instrumentar a verificação sobrecarrega o time sênior na caça a erros sutis.
A Curva J de Produtividade: O “Vale do Desespero”
A adoção de infraestrutura agêntica corporativa segue uma Curva J de Produtividade: a eficiência inicial sofre uma queda temporária durante a calibragem de contexto antes de disparar em ganhos compostos.
Meses 1 a 3 (Dívida de Contexto Inicial): A produtividade percebida cai entre 15% e 25%. A equipe sênior se divide entre ajustar regras, calibrar linters e filtrar alucinações.
Meses 4 a 6 (Inflexão): As restrições e convenções começam a surtir efeito. A taxa de intervenção humana em tarefas repetitivas estabiliza.
Meses 6 a 12 (Ganhos Compostos): O repositório atinge maturidade de contexto. Agentes executam tarefas atômicas com alta taxa de acerto e baixo retrabalho.
Preparar a diretoria e o CFO para o vale inicial evita cancelamentos prematuros de iniciativas antes do ponto de retorno financeiro.
3. Arquitetura de Referência: O Modelo de Três Camadas
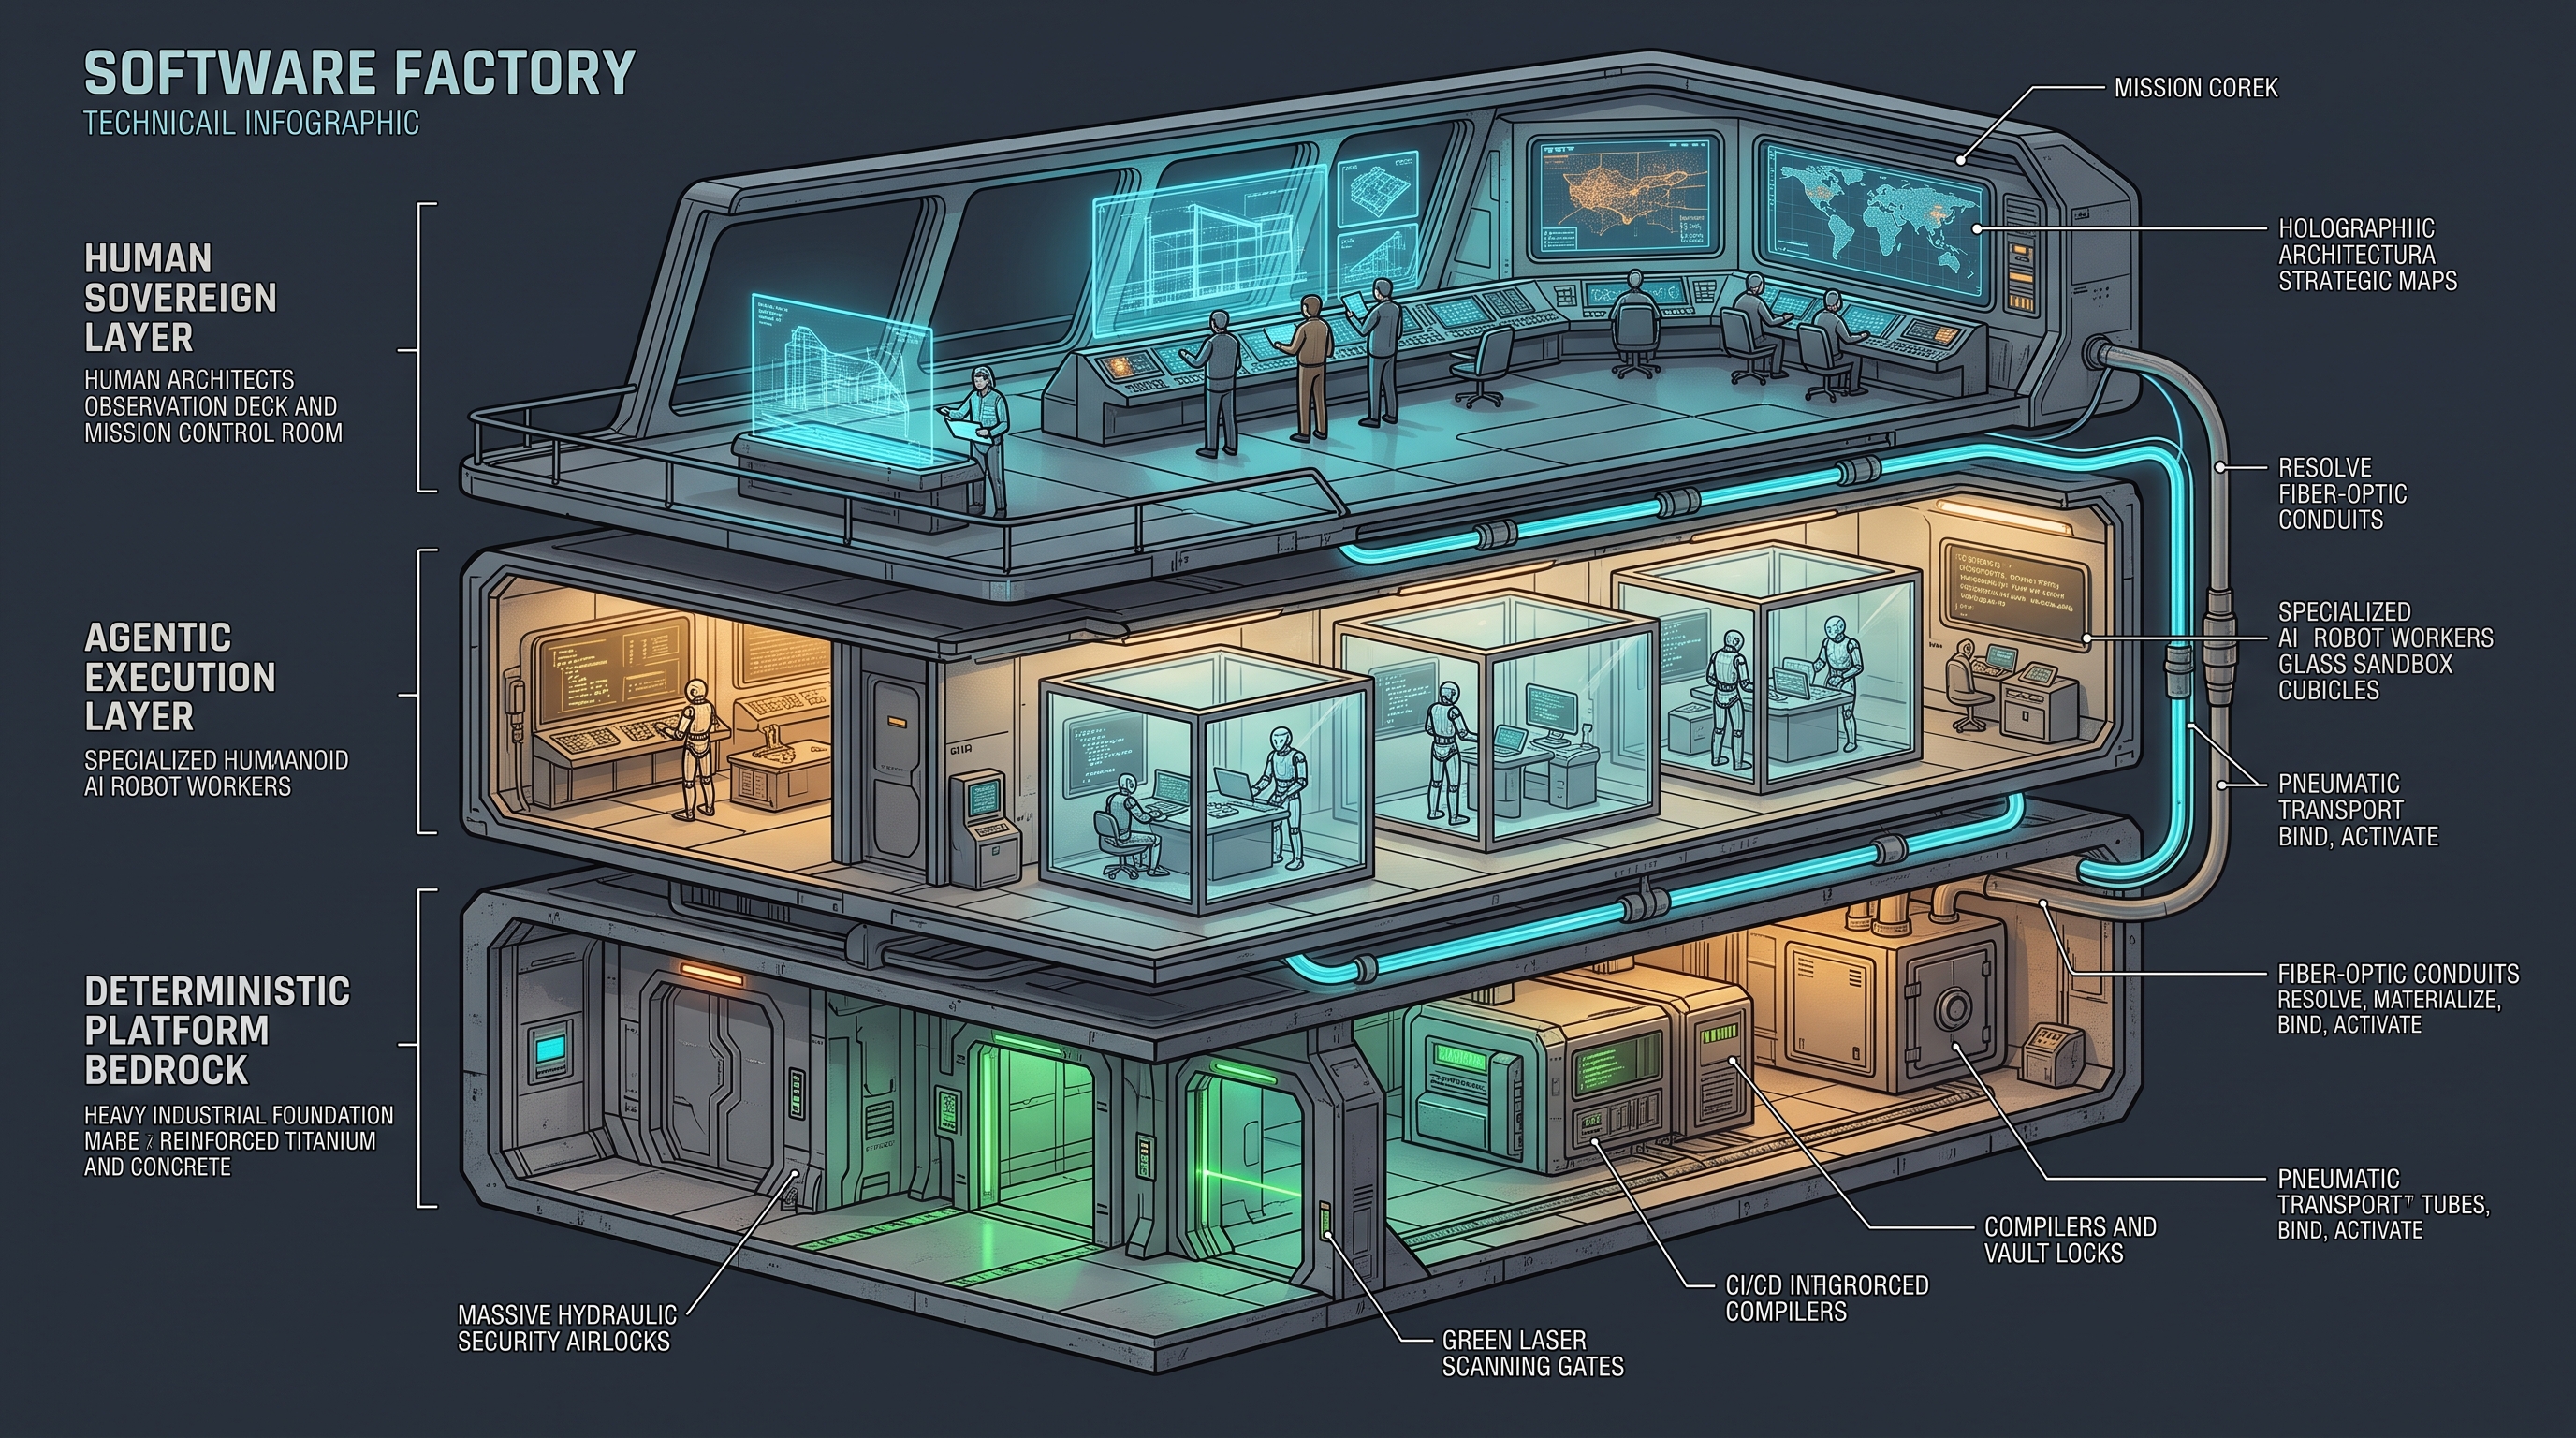
A Arquitetura de 3 Camadas: Decisão humana no topo estratégico, agentes operando em sandboxes no centro e plataforma determinística na base.
Modelos de linguagem não são confiáveis por natureza: eles prevêem o próximo token mais provável. Quem garante a consistência de um sistema corporativo não é a inteligência do prompt, mas a arquitetura que cerca o modelo.
Para construir uma fábrica de software confiável, separamos as responsabilidades em três camadas:
1. Decisão Humana (Estratégia e Negócio): Onde o julgamento não é terceirizável. Definição de regras de domínio, limites de escopo e a palavra final sobre o que entra em produção.
2. Frotas de Agentes (Execução em Sandbox): Onde o trabalho operacional acontece. Quebra de tarefas, geração de código e criação de suítes de teste em ambientes temporários e isolados.
3. Plataforma e Guardrails (A Base Rígida): Onde não há espaço para alucinação. Git, pipelines de CI/CD, linters, checagens estritas de tipagem e controle de acesso que barram qualquer inconsistência antes do merge.
O Ciclo de Carregamento Seguro (The Load Lifecycle)
Para garantir que um agente não execute ações com permissões indevidas, o runtime deve seguir 4 etapas determinísticas:
Resolve: Identifica a versão exata da habilidade e das dependências no registro corporativo.
Materialize: Monta a sandbox isolada e injeta apenas os arquivos estritamente necessários para a tarefa (Progressive Disclosure).
Bind: Vincula credenciais com privilégio mínimo (Least Privilege) e anexa ferramentas autorizadas para aquele escopo.
Activate: Dispara a execução com limites de tempo e orçamento de tokens (Circuit Breakers).
4. Governança sem Ilusões: Supervisão de Fronteira (The Seam)
Normas como SOC 2, ISO 27001 e PCI-DSS partem de uma premissa simples: sistemas são operados por humanos previsíveis ou compiladores determinísticos. Quando colocamos frotas de agentes alterando múltiplos arquivos sob inferência estatística, essa garantia deixa de existir.
Tentar resolver isso pedindo para o time “revisar os PRs com calma” é o que chamamos de Supervisão Weak-Form (Fraca): uma ilusão de controle que quebra assim que o volume de código gerado ultrapassa a capacidade de leitura da equipe.
O Teste dos 15 Agentes e a Falácia do “LLM-as-a-Judge”
Uma das promessas mais comuns do vibe coding é delegar até revisão para outra IA. A ideia de colocar modelos debatendo em rodadas infinitas até atingir um “consenso agêntico” queima tokens e entrega uma falsa sensação de segurança.
O teste do módulo Growth Engine, documentado no Capítulo 5 do The Agentic SDLC Handbook, colocou isso à prova. Um painel de 15 agentes especialistas de IA foi encarregado de auditar o Pull Request de um novo microsserviço.
O resultado: os 15 agentes aprovaram o PR com nota máxima, elogiando a estrutura, os testes e a tipagem. Trinta segundos depois, um arquiteto humano olhou o diff e barrou o deploy: o código violava uma política interna de segregação de dados europeus.
O ponto é: regras contratuais e políticas internas da sua empresa não existem nos dados de treino de modelos comerciais. Sem guardrails locais explícitos, empilhar agentes para julgar agentes só produz generalistas confiantes validando o erro uns dos outros — caindo no que o próprio Artigo 14 do EU AI Act⁶ alerta sobre o viés de automação: a tendência de confiar cegamente na máquina e aprovar decisões por inércia.
A Estratégia de Fronteira (The Seam): Weak-Form vs. Strong-Form
Para manter a cadência de entrega sem criar passivos nem depender de aprovações por estética de código, precisamos separar dois modelos de supervisão:
Supervisão Weak-Form (Reativa): O desenvolvedor tenta caçar agulhas em diffs de milhares de linhas sob pressão de sprint ou delega a aprovação para debates de LLMs. Na prática, vira aprovação por estética de código (rubber-stamping).
Supervisão Strong-Form (Determinística na Fronteira): O modelo roda confinado em sandbox sem autoridade direta de merge. No ponto de integração com o repositório principal (The Seam), barreiras automáticas assumem o controle: regras de AST (Abstract Syntax Tree) e Policy-as-Code (Semgrep) validam invariantes de negócio, scanners locais barram vazamento de credenciais e linters garantem a integridade estrutural a custo zero de tokens antes de qualquer intervenção humana.
O Triângulo de Forças: O que Determina a Fronteira de Delegação?
Para decidir quais tarefas podem ter a Decisão migrada para agentes e quais exigem aprovação humana obrigatória (Strong-Form), avaliamos três forças:
Verificabilidade (Verifiability): Quão barato e determinístico é validar o resultado via máquina? (Ex: Testes unitários com 100% de asserção e tipagem estrita = Alta Verificabilidade vs. Migração de arquitetura de microsserviços sem testes = Baixa Verificabilidade).
Raio de impacto (Blast Radius): Qual o custo financeiro ou operacional de uma alucinação? (Ex: Script interno de limpeza de logs = Baixo vs. Módulo de conciliação bancária/Auth = Crítico).
Disponibilidade de Contexto (Context Readiness): O repositório possui regras documentadas em arquivos de contexto (AGENTS.md, .skill.md, ADRs vivas) ou o conhecimento depende de conversas tácitas de corredor?
A Regra de Ouro:Acelerar a Execução sem baratear a Verificabilidade é a forma mais rápida de sobrecarregar seu time sênior e colapsar a governança da esteira.
Checklist de Prontidão de Governança
Para estruturar essa transição, o Governance Readiness Checklist do handbook consolida seis capacidades essenciais para a esteira:
Trilhas de Auditoria (Audit Trails): Em vez de commits assinados no escuro, o repositório registra tudo: prompt de intenção, contexto consumido e logs de execução associados ao PR.
Controle de Acesso (Agent IAM): Nada de rodar agentes com credenciais pessoais. A execução opera com identidades efêmeras e permissões mínimas por tarefa.
Aprovação por Domínio e Risco (Approval Flows): Em vez de tratar todo PR igual, alterações em módulos sensíveis (auth, pagamentos, banco) disparam checklists dedicados e exigem o approve explícito dos code owners daquele domínio.
Fronteira de Dados & DLP: Scanners locais e filtros na VPC impedem o envio acidental de segredos, PII e dados de produção para APIs públicas de LLMs.
FinOps e Circuit Breakers: Tetos de consumo por tarefa e travas automáticas para interromper loops infinitos de retry antes de estourarem a fatura.
Conformidade Contínua (Policy-as-Code): Validação de regras regulatórias (SOC 2, ISO 27001, EU AI Act) direto no CI/CD via evidências automatizadas, abandonando auditorias reativas de véspera.
O capítulo ainda traz ainda outras ferramentas como a matriz de decisão arquitetural (que delimita autonomia Humano x IA) e uma taxonomia de riscos agênticos, mapeando ameaças como envenenamento de contexto (Context Poisoning) e a atrofia de conhecimento da equipe.
5. Topologia de Equipes e o Paradoxo do Desenvolvedor Júnior
Se a escrita mecânica de sintaxe agora é a etapa mais barata do desenvolvimento, medir a produtividade de um time por volume de código ou velocidade de fechar tickets virou um anacronismo perigoso.
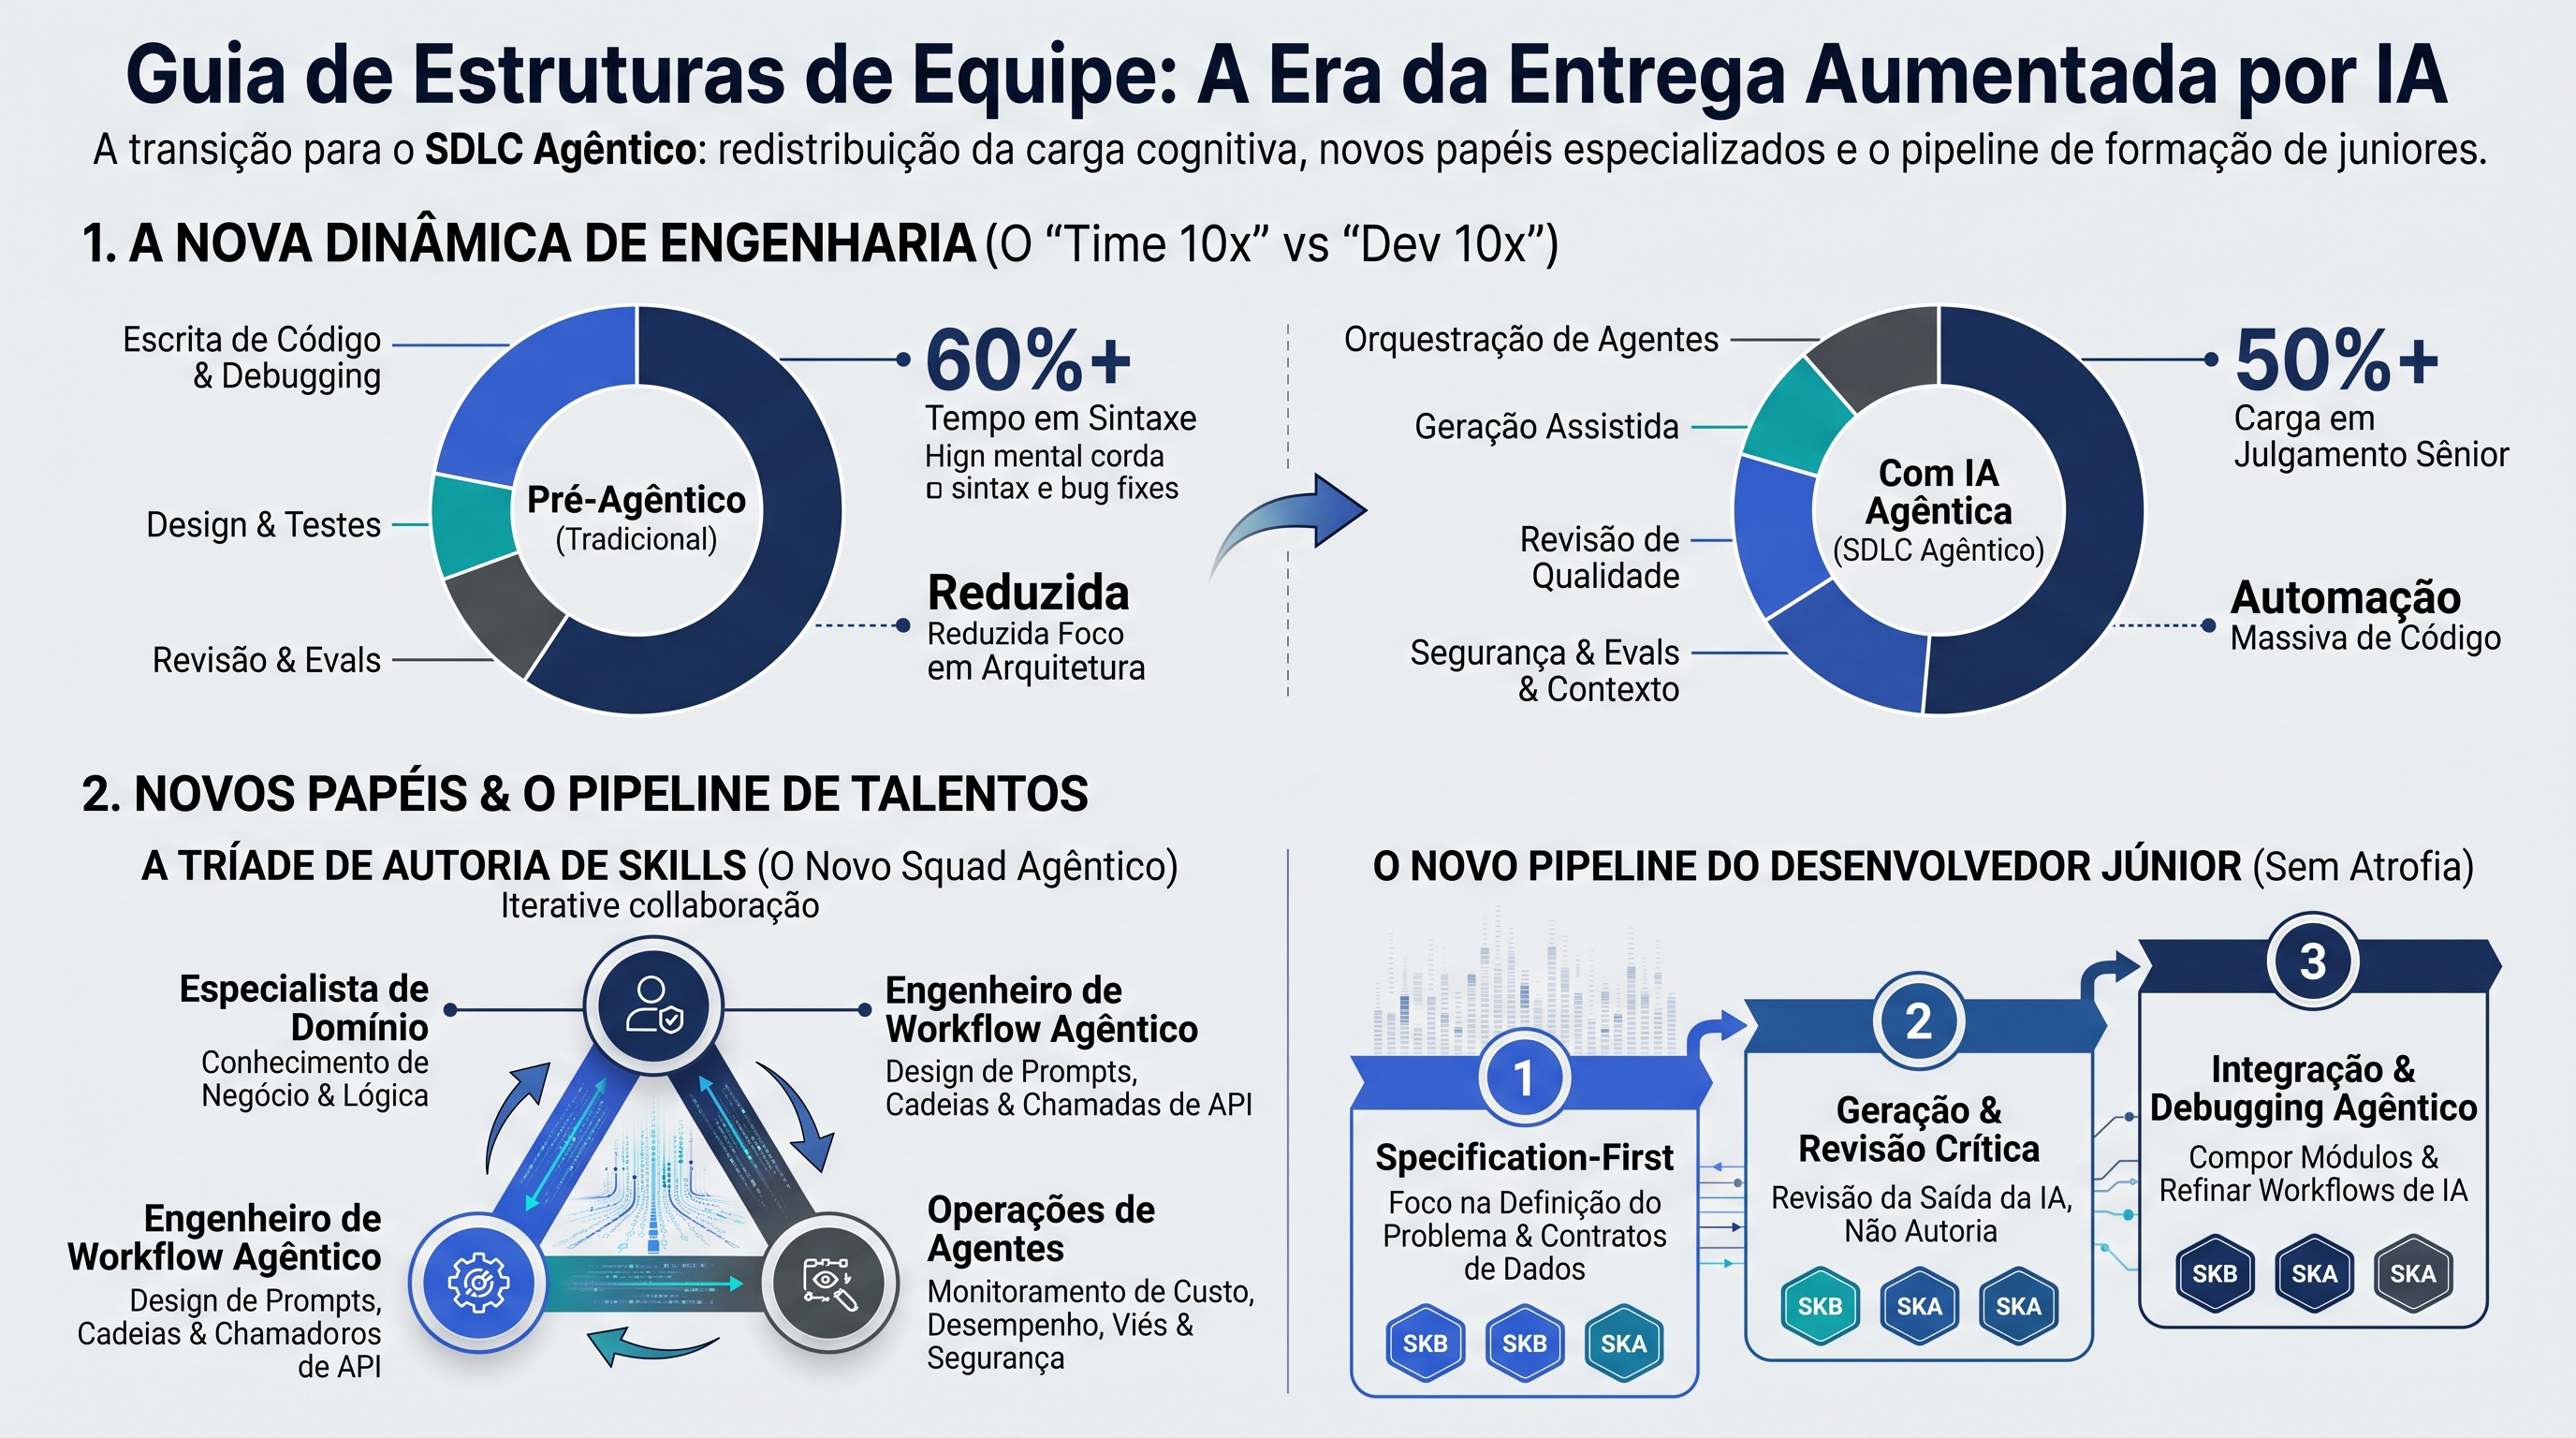
A reorganização descrita no Capítulo 6 do The Agentic SDLC Handbook enterra a fantasia do “dev 10x solo” e foca no Time 10x: uma estrutura onde a alavancagem vem do contexto sistêmico compartilhado no repositório.
Guia de Estruturas de Equipe: A redistribuição da carga cognitiva, novos papéis especializados e o pipeline de formação de talentos juniores.
O Toolkit de Diagnóstico da Liderança: A Matriz de Responsabilidade
Para organizar a equipe sem cair na armadilha de tratar a delegação como uma chave binária (tudo ou nada), a liderança precisa dividir qualquer tarefa em três dimensões fundamentais:
1. Execução (Execution): Quem digita a sintaxe, roda a refatoração mecânica e gera a suíte de testes. (Migra massivamente para os Agentes).
2. Decisão (Decision): Quem avalia trade-offs de implementação e valida se os critérios de aceite foram cumpridos. (Migra progressivamente para os Agentes, desde que balizada por guardrails).
3. Accountability (Responsabilização Final): Quem responde pelo incidente às 2h da manhã quando a produção cai, quem assina o post-mortem e responde ao negócio. (Permanece 100% humana e intransferível).
┌──────────────────────────────────────────────────────────────┐
│                    MATRIZ DE DELEGAÇÃO                       │
├─────────────────┬─────────────────────┬──────────────────────┤
│ Dimensão        │ Quem Assume?        │ Destino no SDLC      │
├─────────────────┼─────────────────────┼──────────────────────┤
│ Execução        │ Agente de IA        │ Automação em Sandbox │
│ Decisão         │ Agente + Guardrails │ Automação com Limite │
│ Accountability  │ Engenheiro Humano   │ Intransferível       │
└─────────────────┴─────────────────────┴──────────────────────┘
Para avaliar a saúde da esteira, aplique o teste das três perguntas em qualquer fluxo de trabalho: quem executa, quem decide e quem responde se quebrar?
Se a resposta para as três perguntas for a mesma pessoa, você está delegando pouco e desperdiçando produtividade. Se a execução é automatizada, mas você ainda revisa linha por linha manualmente, a sua camada de verificação é o gargalo, não o modelo. Agora, se você não consegue nomear claramente quem é o responsável final, pare: essa é uma tarefa que você ainda não está pronto para migrar.
A Redistribuição do Trabalho no Repositório
Na prática, a divisão de tarefas muda de perfil. Em vez de histórias de usuário abertas e cheias de ambiguidades no Jira, o time precisa entregar especificações de intenção claras (intent.md), com contratos e critérios de aceitação objetivos que possam ser validados por testes.
A arquitetura foca em delimitar o raio de ação dos modelos, manter ADRs vivas no Git, isolar ferramentas e garantir que os agentes não misturem domínios do sistema.
Para quem desenvolve, a atenção migra de escrever código para orquestrar escopo e verificar diffs. E a sustentação desse fluxo passa a depender de suítes sólidas de testes automatizados rodando no CI/CD para barrar regressões antes do merge.
O Paradoxo da Aviação: Como Formar Seniores?
Há uma armadilha séria para a liderança técnica: se o agente resolve o trabalho de base em segundos, como formamos novos seniores?
O handbook traça um paralelo com o setor aéreo. Quando o piloto automático assumiu quase todo o tempo de voo, a falta de prática no manche (manual flying) cobrou seu preço em emergências não cobertas pelos manuais.
Na engenharia, o risco é a atrofia de conhecimento (Knowledge Atrophy). Ou seja, o dev deixa de quebrar a cabeça com memory leaks, para de investigar race conditions e perde o hábito de dissecar pacotes de rede no terminal. Sem essas horas de voo no terminal, fica difícil desenvolver o senso crítico para auditar o código das máquinas quando a produção cai às duas da manhã.
Para quebrar esse ciclo, a formação precisa de prática deliberada. Em vez de jogar tickets de sintaxe para o júnior, o treino começa invertido (Specification-First): ele escreve contratos de API, limites de escopo e as asserções de teste antes de rodar qualquer modelo. Os agentes entram em modo socrático (/grill-me) apontando falhas com perguntas estruturais em vez de entregar a resposta pronta.
Complementamos isso com treinos manuais sem IA no core do produto e envolvemos os engenheiros mais novos na escrita de linters, regras de AST e arquivos de governança. Quando o júnior aprende arquitetura desenhando os próprios trilhos por onde os agentes trafegam, o squad ganha densidade de julgamento, e o pipeline de formação de seniores continua vivo.
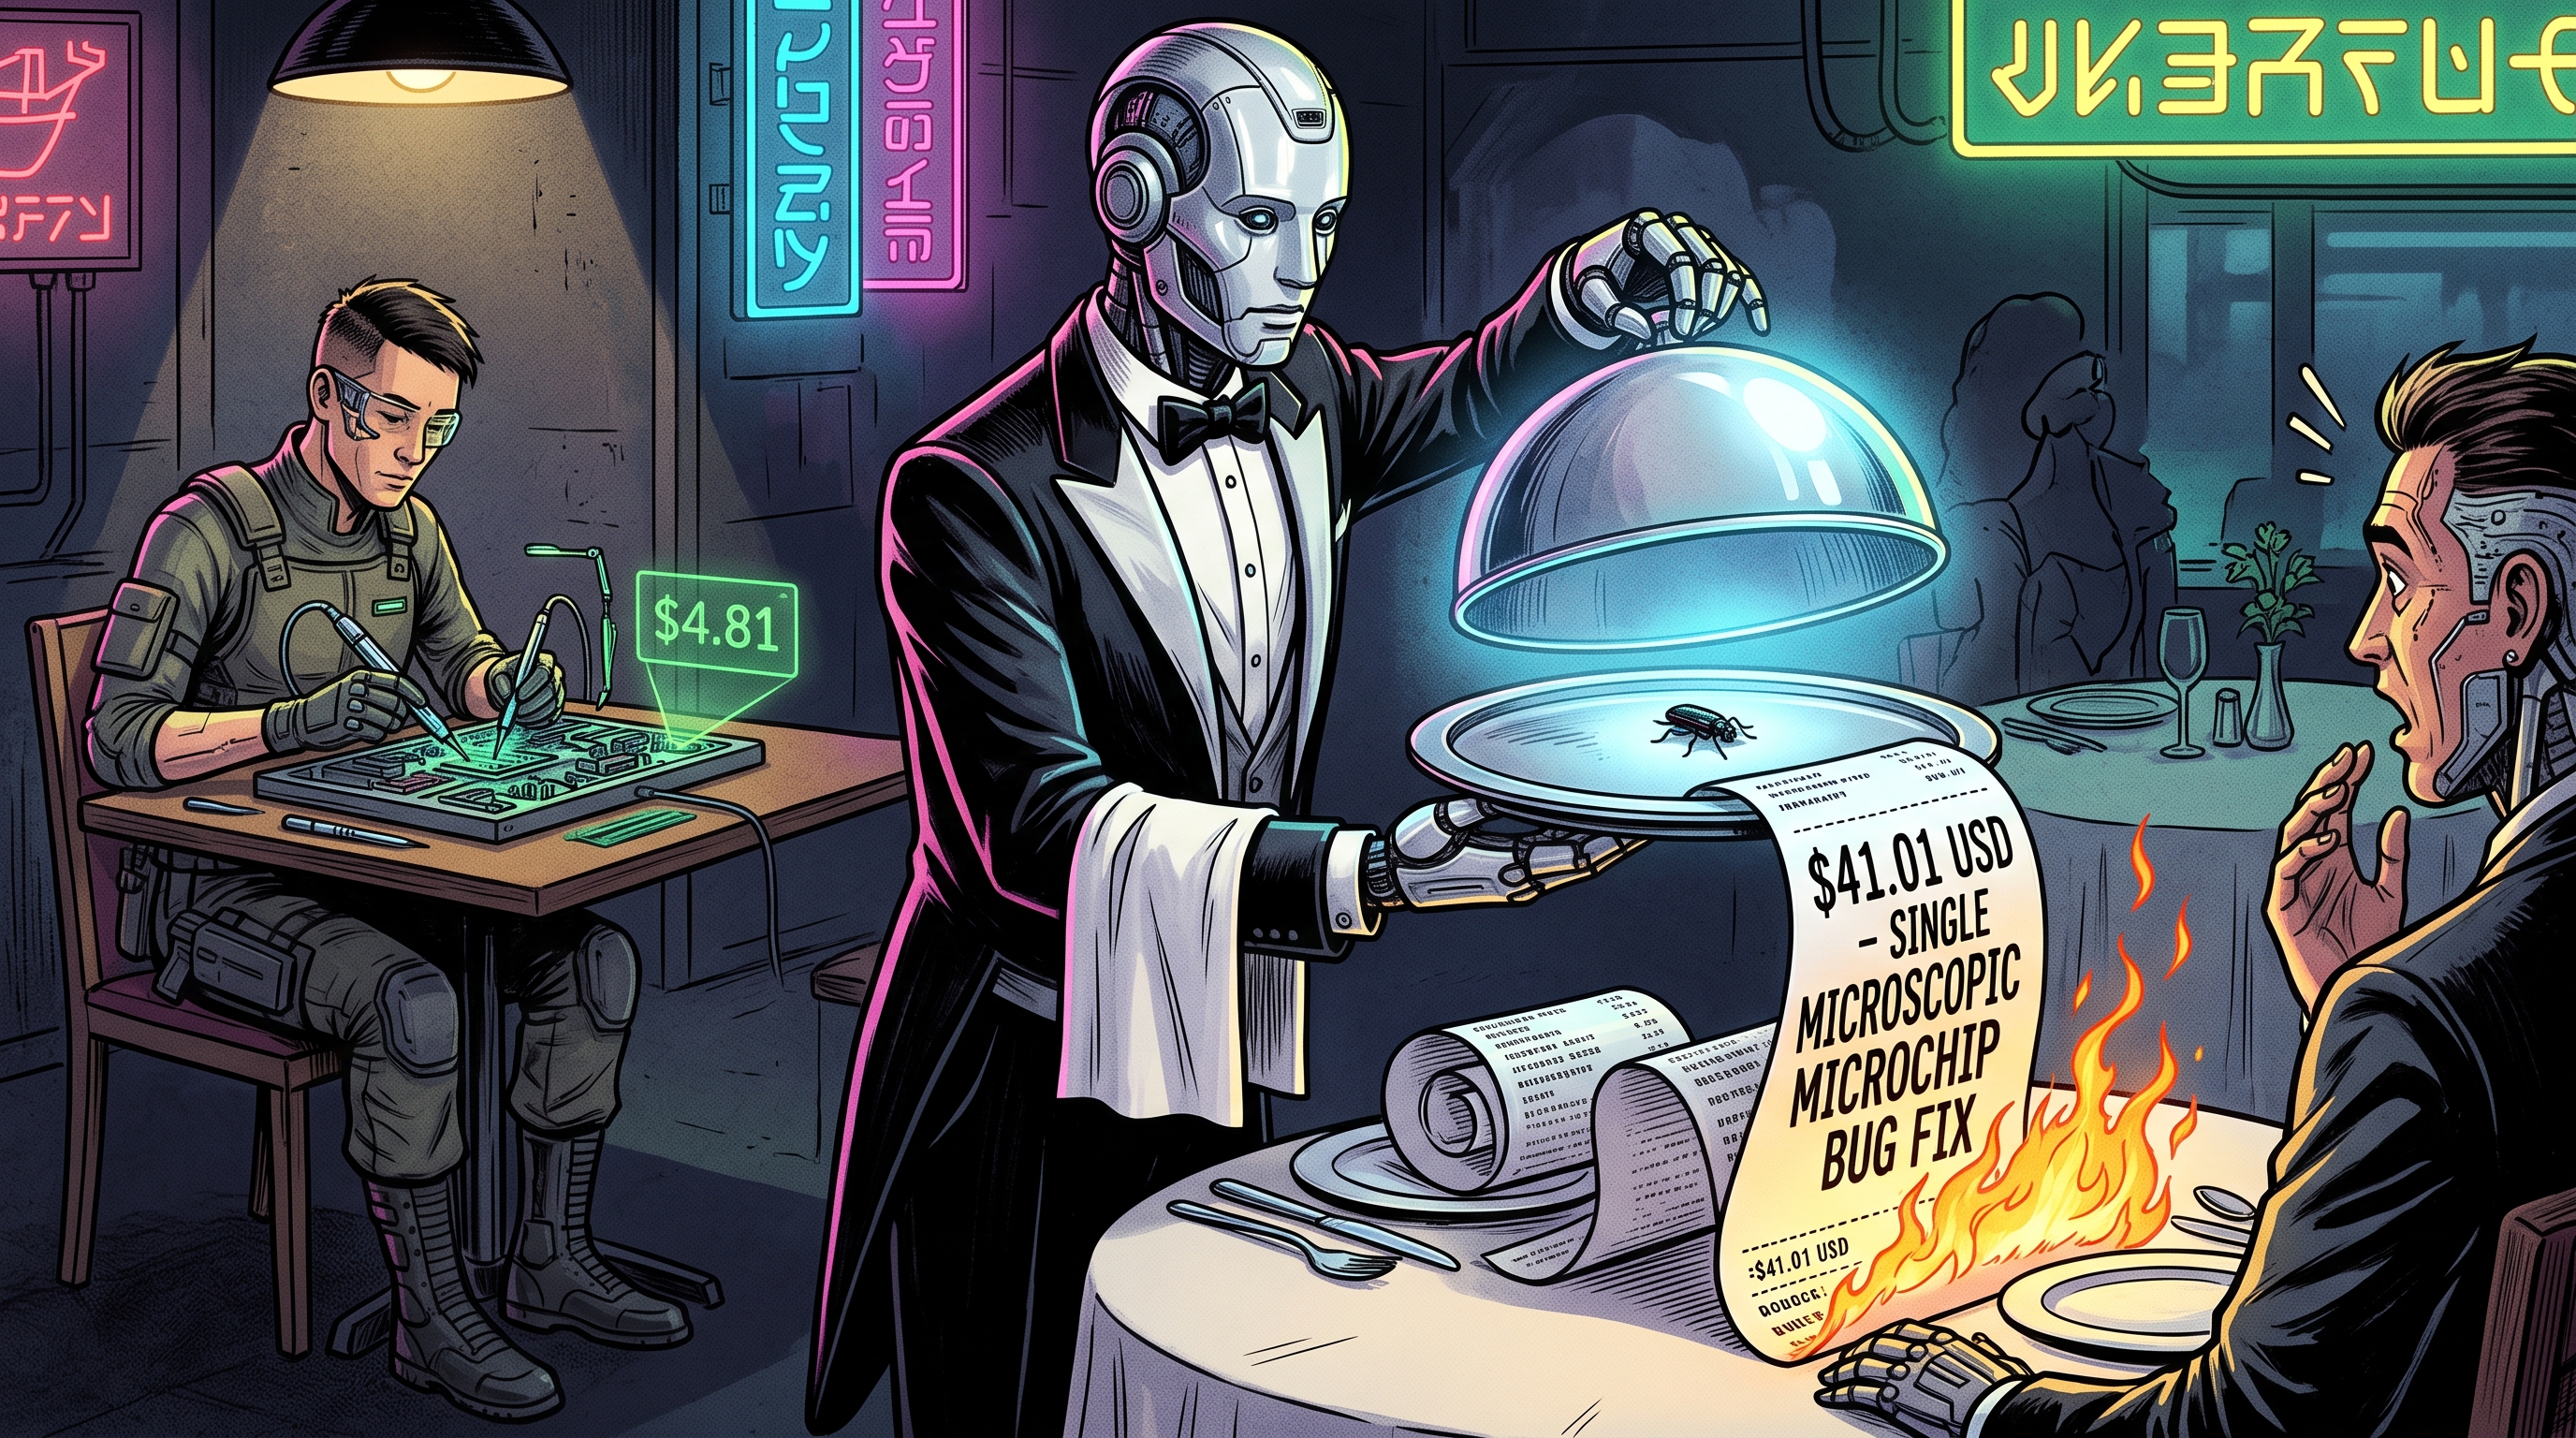
6. FinOps Agêntico: O Caso dos 19 Arquivos ($41 vs. $4)
No modelo tradicional, o custo de desenvolvimento se resumia a licenças fixas de assento por desenvolvedor. No fluxo agêntico, o consumo de tokens passa a se comportar como uma variável direta de arquitetura — e o principal vilão financeiro não é a tabela de preços da nuvem, mas a variância descontrolada dos fluxos de trabalho.
No mesmo estudo de caso do Growth Enginedocumentado no Capítulo 7 do handbook, a refatoração dos seus 19 arquivos centrais colocou à prova a economia de tokens, revelando uma dispersão de 8.5x no custo final:
Na força bruta (Vibe Coding): Despejar arquivos crus na janela de contexto (Context Dumping) e rodar loops cegos em modelos Frontier topo de linha queimou $41.01 USD.
Com arquitetura de contexto (Harness): Poda cirúrgica Just-in-Time, prompt caching e escalonamento hierárquico de modelos entregaram o mesmo diff por $4.81 USD.
The Agentic Bill: custo elevado por contexto bruto versus eficiência com poda e modelos escalonados.
O Leader’s Playbook: Engenharia de Custos na Prática
Para conter essa sangria sem travar a produtividade da equipe, o Leader’s Playbook estabelece cinco diretrizes operacionais para lideranças de tecnologia:
Centralizar a engenharia de fluxos (Agentic Workflow Engineers): Em vez de deixar cada desenvolvedor improvisar prompts caros do zero, um time especializado projeta, testa e padroniza os loops com retorno financeiro comprovado.
Fixar o tier mínimo viável (Model Tier Pinning): Cerca de 80% das demandas de rotina (testes unitários, tipagem e ajustes de contratos) rodam com folga em modelos de base rápidos e baratos ($0,25 por milhão de tokens). Modelos Frontier de raciocínio pesado ficam restritos a decisões arquiteturais complexas.
Tratar loops como código (Skills & Plugins): Regras de contexto, personas e ferramentas MCP são versionadas no Git e distribuídas via catálogo interno. A otimização de tokens é feita uma única vez na raiz do repositório e aproveitada por toda a organização.
Gates automáticos de custo vs. valor: Tarefas locais e de baixo consumo têm passagem livre na esteira, enquanto execuções que demandam chamadas volumosas a modelos de ponta exigem tetos orçamentários e aprovações explícitas.
Acesso base livre e P&D intencional: O time tem acesso irrestrito a modelos econômicos no dia a dia, tratando o uso de modelos de fronteira como uma aposta deliberada de P&D que precisa justificar seu ROI na telemetria.
A Alavanca CAPEX: Quando o volume operacional escala, a liderança técnica pode trocar a fatura variável de tokens na nuvem (OPEX) por servidores dedicados com GPUs próprias ou instâncias locais (CAPEX), estabilizando os custos mensais e zerando o custo marginal por tarefa.
7. O Guia de Transição: Planejando a Virada
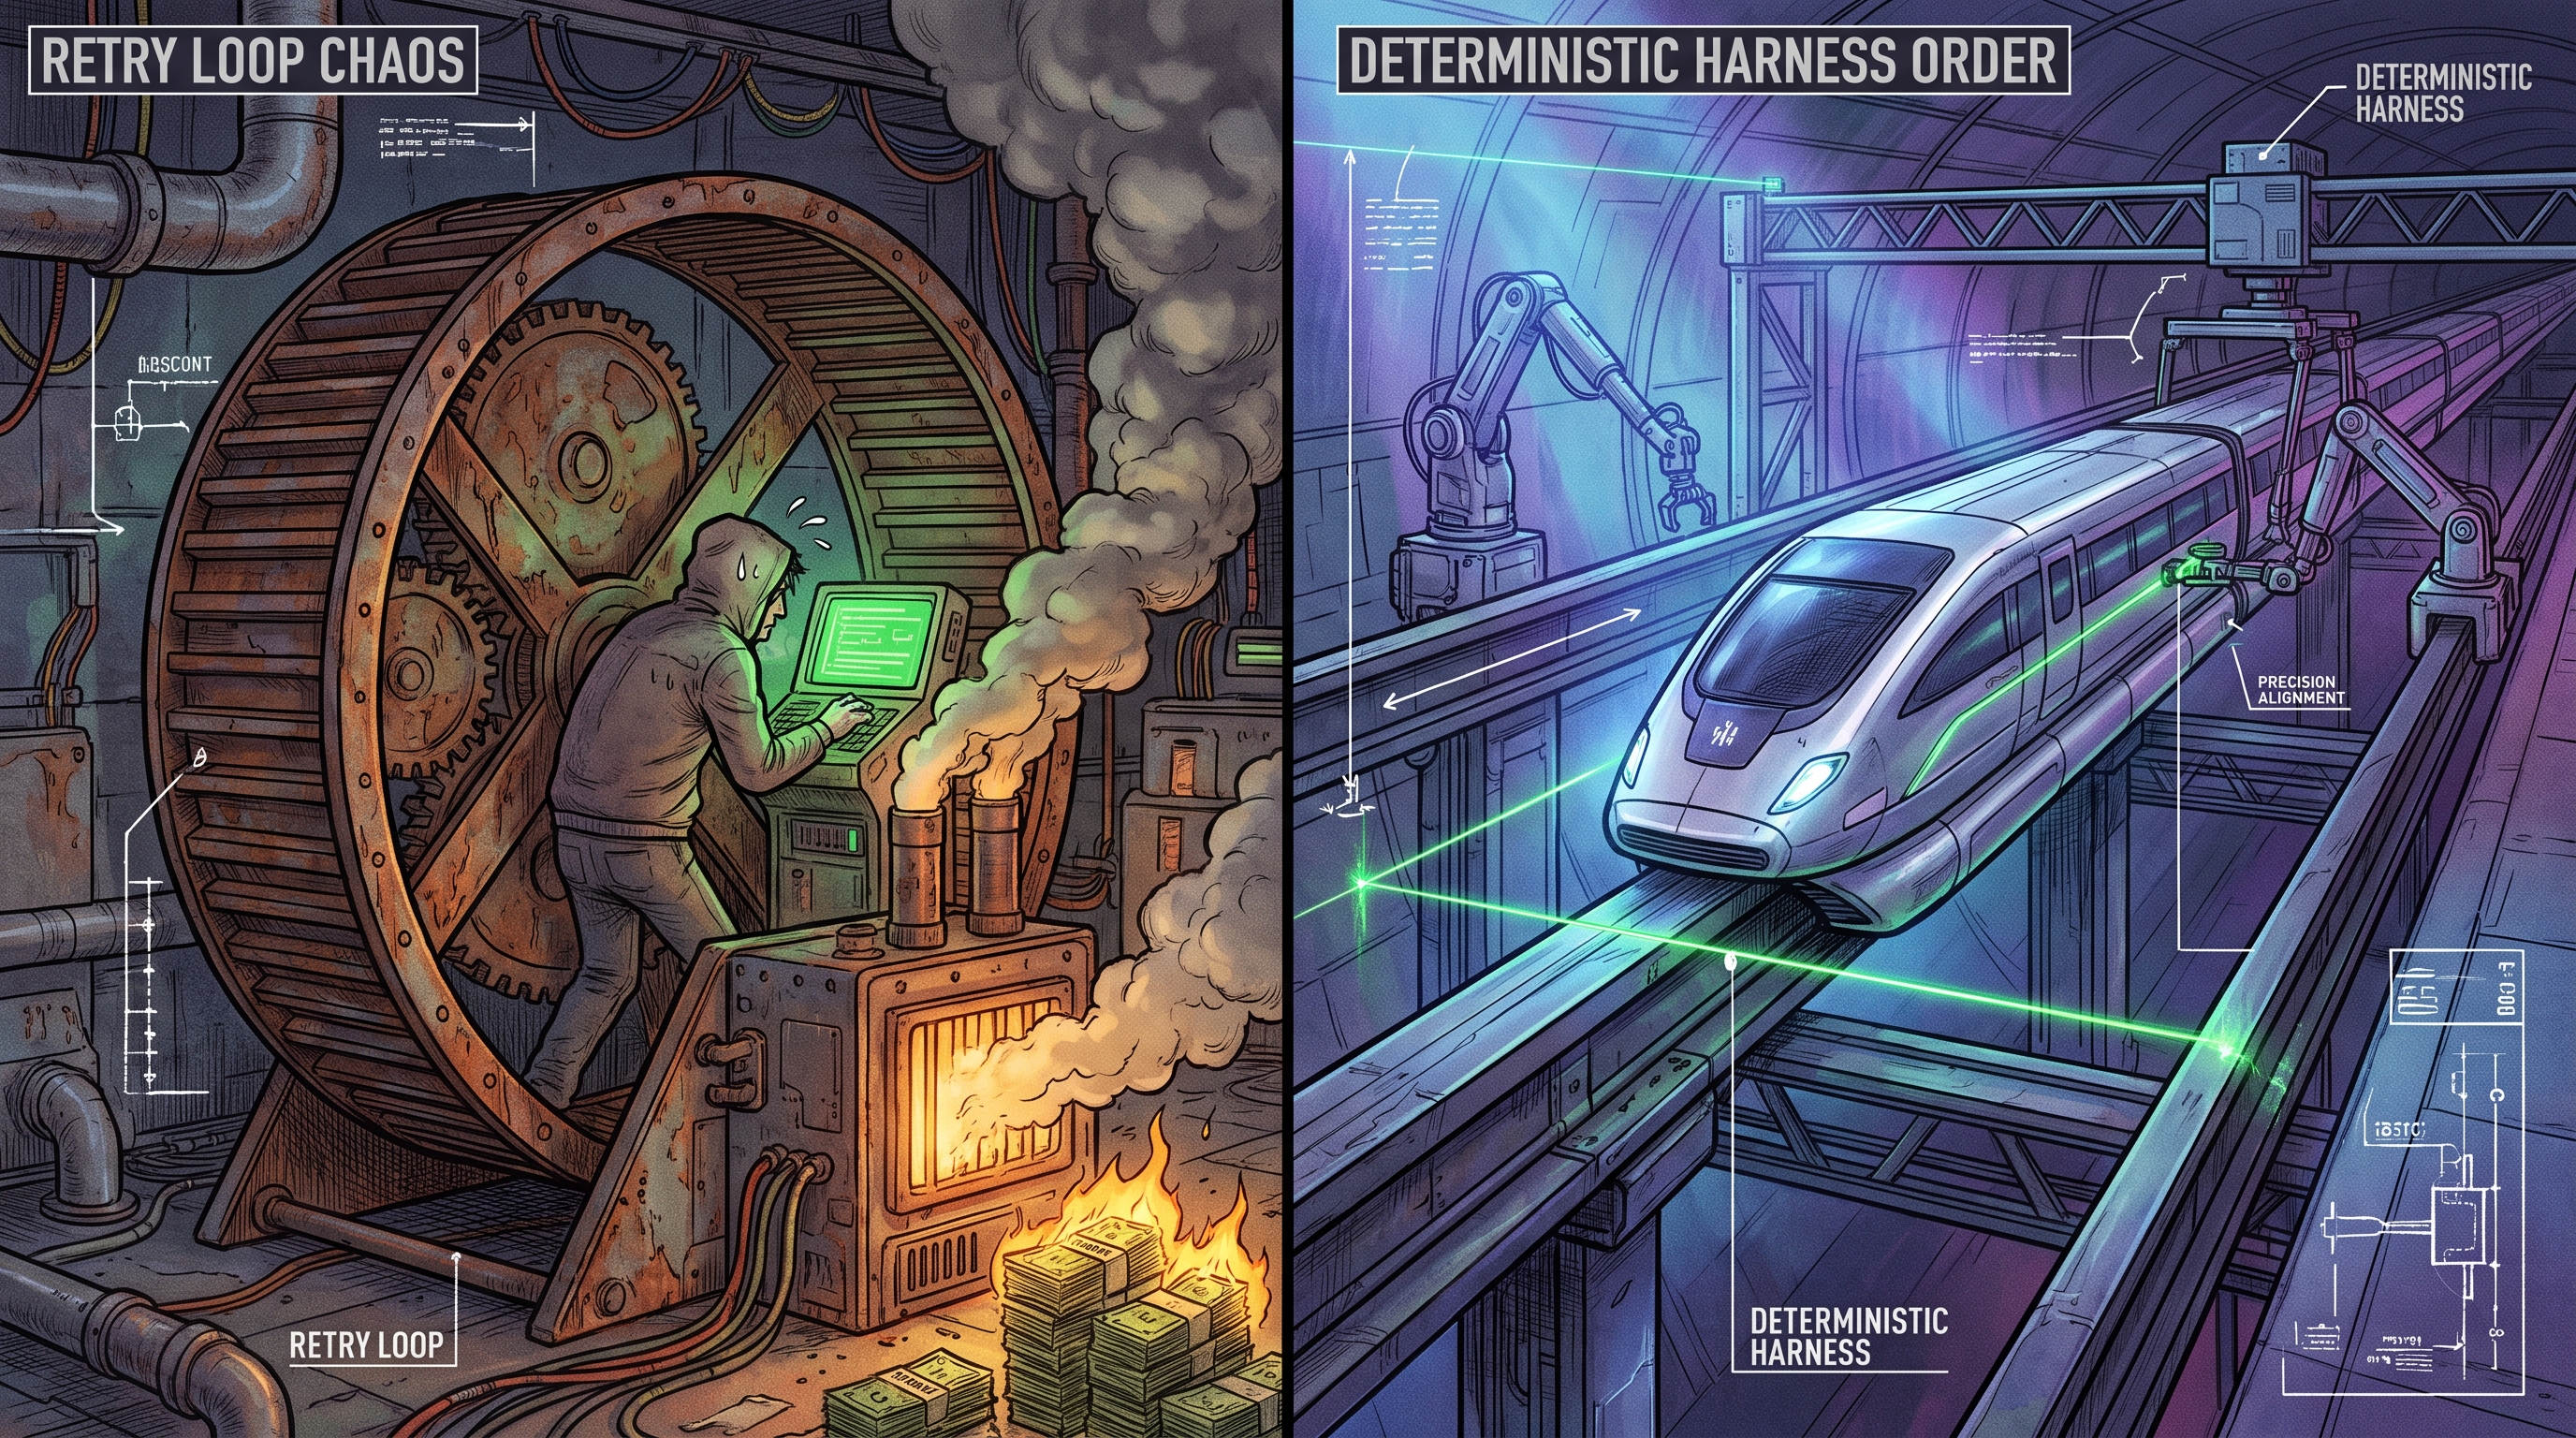
Tentar virar a chave de uma só vez (Big Bang) em toda a engenharia é o caminho mais rápido para acumular um cemitério de PRs quebrados, desenvolvedores exaustos e faturas infladas.
Loop Engineering vs. Harness: tentativas cegas consumindo tokens versus validação em trilhos determinísticos.
As 4 Dimensões da Prontidão Organizacional
Antes de liberar agentes para o time inteiro, a liderança técnica precisa auditar a base em quatro frentes:
1. Base de Código: O repositório possui módulos desacoplados, limites de domínio claros e convenções de arquitetura documentadas em arquivos que a IA consiga ler (GEMINI.md, CLAUDE.md)?
2. Processos: O pipeline de CI/CD tem gating determinístico (linters, AST, tipagem estrita) para barrar código malformado antes da revisão humana?
3. Técnica do Time: Os desenvolvedores dominam a escrita de especificações de intenção (intent.md) e a criação de suítes de testes ou continuam apenas jogando prompts soltos na IDE?
4. Cultura: A liderança abandonou métricas rasas de volume (como linhas de código ou contagem de commits) para focar em densidade de julgamento, estabilidade de arquitetura e mitigação de débitos técnicos?
O Roadmap Prático de 24 Meses
Uma transição sólida acontece em três etapas graduais:
Piloto Controlado (Meses 1 a 5): 1 a 2 squads voluntárias atuando em tarefas atômicas e repetitivas (refatorações de assinaturas, documentação técnica, expansão de cobertura de testes), gerando os primeiros arquivos de contexto de raiz. Critério de segurança: pausar o piloto se a taxa de rejeição de PRs gerados por IA ultrapassar 60% nas primeiras 6 semanas.
Consolidação do Context Moat (Meses 3 a 9): Criação de habilidades modulares (.skill.md), consolidação de ADRs vivas no Git e capacitação dos primeiros engenheiros de fluxo agêntico (Agentic Workflow Engineers).
Escala & Soberania (Meses 6 a 24): Toda a esteira de entrega operando com menor privilégio por tarefa, gating determinístico em CI/CD e migração de cargas de trabalho recorrentes para inferência dedicada/local (CAPEX).
Telemetria Real: O G-R Ratio
Na era agêntica, a verdadeira velocidade não é medida por quantos tokens o modelo cospe por segundo, mas pelo tempo que o engenheiro humano leva para validar o diff.
No The Agentic SDLC Handbook, Daniel Meppiel formaliza essa relação através da Razão de Geração-para-Revisão (G-R Ratio):
G-R Ratio = Tempo de Geração pelo Agente / Tempo de Revisão e Validação pelo Engenheiro
Como interpretar esse indicador na prática:
Zona Saudável (> 3.0 : 1): O agente gera a implementação e o engenheiro valida o código rapidamente, concentrando a atenção em regras de negócio e contratos de sistema. Sinal claro de contexto bem podado e especificações claras (intent.md).
Zona de Transição (1.5 a 3.0 : 1): Há ruído no contexto ou o desenvolvedor ainda gasta tempo corrigindo formatações e tipagens que deveriam ser resolvidas automaticamente por linters locais antes do PR.
Zona Crítica (< 1.5 : 1): O desenvolvedor gasta mais tempo corrigindo alucinações e refatorando o código da IA do que gastaria escrevendo a solução do zero. É o sintoma clássico do Vibe Coding e da ausência de guardrails determinísticos.
Conclusão: De Escritores de Código a Governadores de Sistemas
A evolução do desenvolvimento agêntico desloca o trabalho de engenharia da digitação mecânica para o design e governança de fábricas de software.
Como resume o mantra de Dan Disler (IndyDevDan)¹: se você está preso dentro do loop, você é o gargalo.
Na prática, governar essa responsabilidade significa construir sistemas onde as especificações e o CI são tão determinísticos que, se você deletar o código hoje, o agente consegue reconstruí-lo do zero sem alucinar — uma abordagem que explorei no estudo de caso prático sobre O Harness, SDD e Vibe Coding.
Nos próximos anos, a vantagem competitiva não com times que geram código mais rápido, mas aos engenheiros que dominarem a arte de governar a responsabilidade migrada para as máquinas⁷. Ficar na esteira como operador manual de prompts é uma escolha cara que culmina em fadiga e atrofia técnica.
Sair do loop é construir os sistemas de governança capazes de direcionar e auditar a inferência probabilística dos modelos.
E no teu squad: já calculou oG-R Ratioda esteira hoje? Teu time tá conquistando alavancagem de verdade ou apenas afogando os seniors na revisão de diffs sintéticos? Deixa teu comentário aí ou me adiciona para trocarmos essa ideia:
Principal Engineer & Cloud Architect. Focado em arquitetura de software, IA agêntica, governança de código (SDD/Harness) e FinOps de inferência local. Menos hype, mais fundamentos e cicatrizes reais de produção.