Matryoshka: Engenharia de Contexto e Harness no AGENTS.md
Agente autônomo sem cerca determinística é estagiário com credencial de root e sem code review.
Colocar agentes num repositório legado é um pouco mais complicado do que declarar um AGENTS.md com algumas regras e esperar que funcione.
Nos projetos de fim de semana, ferramentas como Cursor, Claude Code, Zed ou Gemini CLI parecem resolver tudo no primeiro prompt. Já numa base existente de dezenas ou centenas de milhares de linhas, o agente entra no escuro: gasta turnos tentando adivinhar o test runner, desconhece onde ficam as rotas e os models, duplica funções utilitárias que já existiam em outra pasta e abre Pull Requests com 40 testes verdes no CI onde nenhum tem um único assert real — apenas mocks instanciados para fazer o teste passar12.
A reação instintiva dos times é criar um AGENTS.md, CLAUDE.md ou .cursorrules na raiz e empilhar regras em caixa alta (CRITICAL: NEVER DO X, ALWAYS CHECK Y) a cada tropeço novo do modelo.
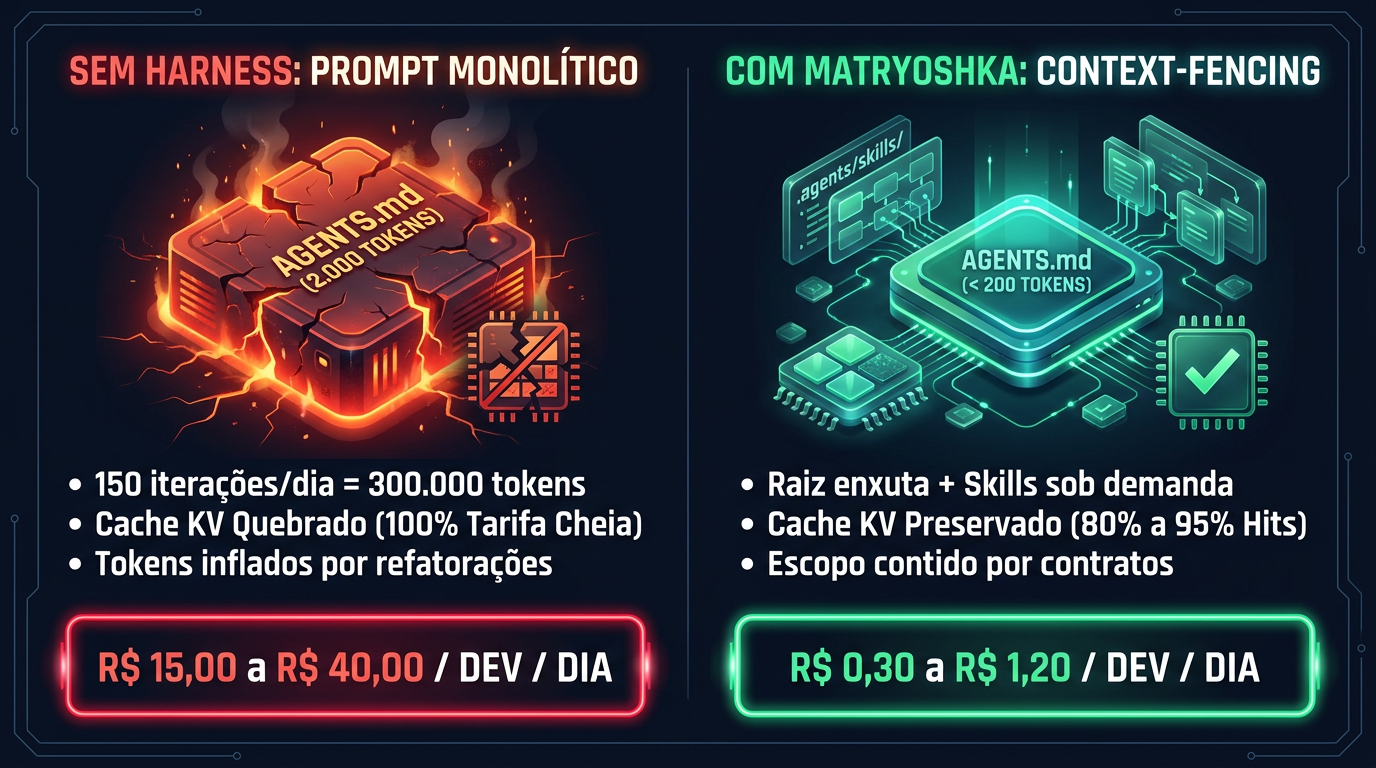
Addy Osmani3 e Lance Martin chamaram esse acúmulo de Instruction Debt ao apresentarem o prompt-audit4. Um AGENTS.md monolítico de 2.000 linhas cobra caro em duas frentes: primeiro, dilui a atenção do modelo logo na largada (Turno Zero), já que misturar regras de banco de dados, CSS, autenticação e testes no mesmo bloco faz o agente perder o foco das restrições críticas no meio de uma refatoração longa56; segundo, pesa na conta de FinOps, porque qualquer ajuste numa regra de UI ou de ORM altera o topo do prompt, invalida o Prompt Caching para o repositório inteiro e força o reprocessamento do contexto à tarifa cheia.
Criei o Matryoshka Harness7 (CLI baba / bbyg) para fazer essa preparação estrutural no repositório antes de soltar qualquer agente. Ele avalia na árvore do projeto as mesmas regras do paladini/harness-score (do nível L0 ao L4) e já gera o boilerplate completo que falta na base: um AGENTS.md travado abaixo de 200 tokens, um ARCHITECTURE.md preenchido com as rotas, models e controllers encontrados no código, o workflow de CI para a stack detectada e a configuração de MCP nos editores. Todo o conhecimento específico de cada matéria do projeto (ORM, banco, UI, autenticação e testes) sai do arquivo raiz e vai para skills especialistas em .agents/skills/ carregadas sob demanda, enquanto um linter de contexto e um scanner de AST em WebAssembly (< 200ms) barram desvios antes do commit.
1. O Que os Grandes Labs Dizem Sobre Harness Engineering (e Como Atendemos na Prática)
Nos últimos meses, tanto os bastidores da Software Factory da OpenAI (detalhados na entrevista ao The Pragmatic Engineer e no guia de Harness Engineering da equipe do Codex8) quanto as publicações da Anthropic (“Effective harnesses for long-running agents” e AI-Native SDLC Playbook9) convergiram para o mesmo diagnóstico: tentar controlar agentes autônomos apenas com prompts longos falha assim que a tarefa passa de uma sessão curta.
Os dois modelos mostram que fazer agentes operarem com consistência exige tirar as regras do improviso conversacional e levá-las para dentro do repositório: documentar a arquitetura e preparar o ambiente antes da execução (Initializer), manter um AGENTS.md curto funcionando como índice para carregar skills especialistas por domínio (infra, segurança, dados, UI) sob demanda, fornecer navegação estrutural precisa e aplicar gates determinísticos de revisão e risco antes de acionar a revisão humana.
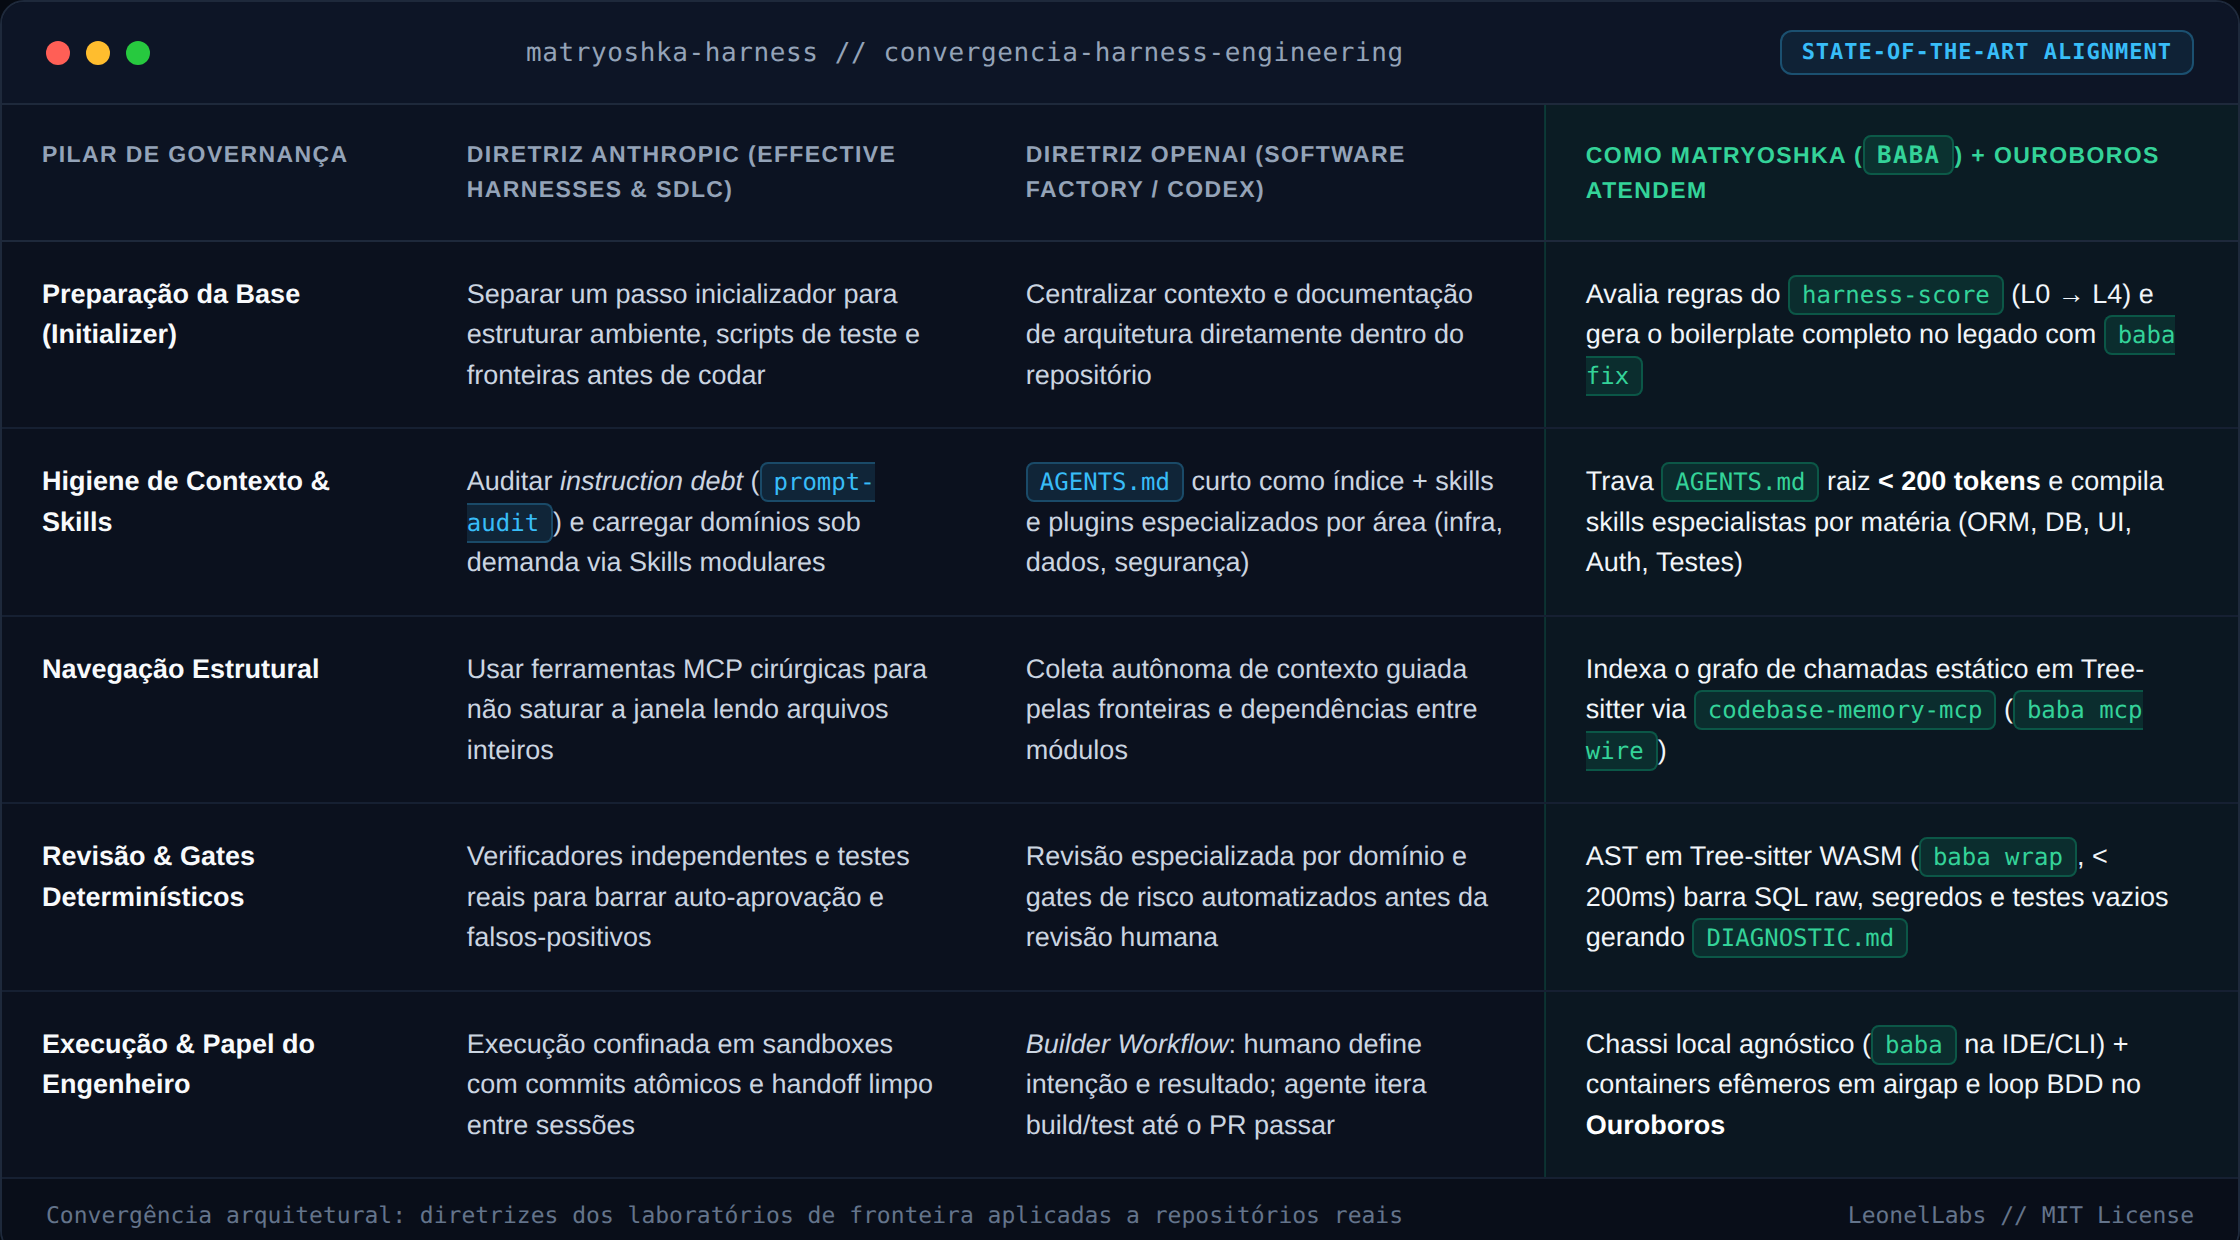
baba) + Ouroboros implementam cada diretriz em repositórios reais.
Sentimos o peso dessas lacunas logo no início do desenvolvimento do Ouroboros na LeonelLabs. Em projetos novos, a esteira subia os containers efêmeros e fechava o ciclo BDD (Red -> Green) em poucos minutos; mas bastava apontar para um repositório legado sem mapeamento para o agente queimar dezenas de turnos rodando grep no escuro, duplicar rotas existentes e estourar o orçamento de tokens antes de entregar o código.
Construímos uma camada de preparação e diagnóstico para corrigir esse comportamento antes da execução. Na prática, essa correção ficou tão redonda e agnóstica à esteira do Ouroboros que decidimos desacoplá-la como um subproduto independente e Open Source (licença MIT): o Matryoshka Harness (baba). Sozinho, ele tem um papel claro para qualquer dev no terminal ou na IDE (Claude Code, Cursor, Zed, Gemini CLI): ler um repositório desconhecido ou legado, avaliar sua estrutura contra as regras do harness-score, gerar os boilerplates dos gaps encontrados e ajudar tanto o time quanto o agente a entenderem o projeto que está sendo mapeado naquele momento.
A fronteira entre os dois é direta: como o Matryoshka roda 100% na CPU (sem chamadas de LLM embutidas na CLI), ele mapeia os arquivos reais do projeto e gera todo o boilerplate estrutural (AGENTS.md, ARCHITECTURE.md com a lista de rotas/models/controllers encontrados, skills por matéria em .agents/skills/, workflow de CI e o relatório .matryoshka/scan-report.md). No uso standalone do Matryoshka, após rodar o baba fix, é necessária mais uma rodada com o agente do próprio usuário (Claude Code, Cursor, Gemini CLI) para ler esse mapeamento e preencher os detalhes semânticos das lacunas encontradas — etapa que o Ouroboros já executa por padrão dentro do seu loop autônomo.
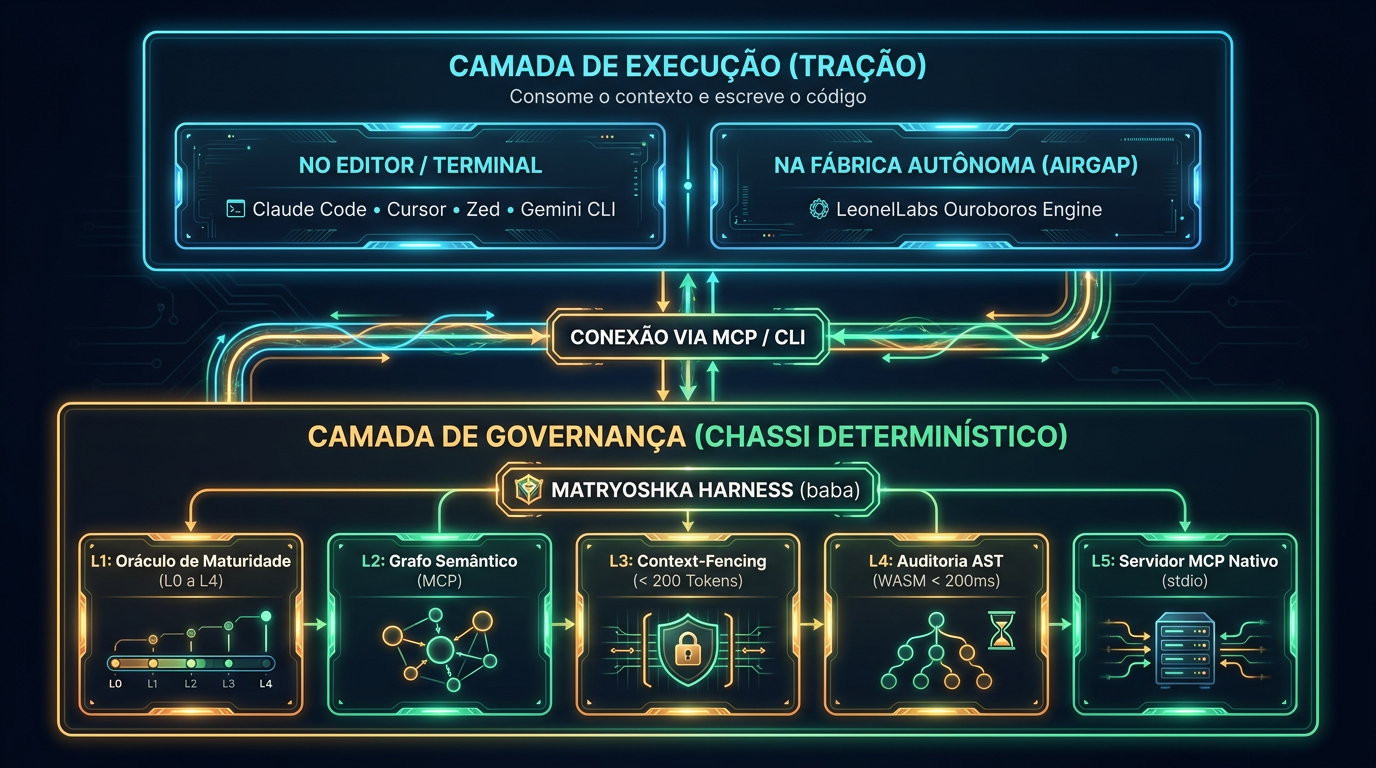
Quando colocamos o próprio repositório do Matryoshka para ser construído via ChatOps no GitHub a partir da Issue #1, esse módulo rodou logo na largada, detectou que a base começava com Score de 34% (L1), gerou os boilerplates e já disparou a rodada do agente no Ouroboros para preencher toda a camada de governança antes do primeiro commit de código.
2. FinOps de Agentes e Prompt Caching: O Impacto no Cache KV
Nos provedores de LLM, o cache KV funciona por correspondência estrita de prefixo (tools -> system/AGENTS.md -> messages). Um arquivo grande e 100% estático também entra em cache, mas manter o AGENTS.md da raiz abaixo de 200 tokens resolve dois gargalos práticos no dia a dia: reduz o peso base nas sessões frias (quando ocorre cache miss) e evita a invalidação constante do prefixo. Quando você tira as regras que mudam toda semana (convenções de ORM, rotas, componentes de UI) do arquivo principal e as isola em .agents/skills/ para carregamento sob demanda, uma edição na regra de banco para de invalidar o hash de cache do repositório inteiro.
Em uma rotina de ~150 interações diárias por desenvolvedor, essa estabilidade de prefixo muda o perfil da fatura:
Os números reais nos 15 PRs de construção do Matryoshka
Como relato empírico de construção (experience report, n = 1 — medindo a telemetria real de engenharia da ferramenta, e não um benchmark A/B sintético da mesma tarefa com e sem harness), consolidamos os logs de todos os 15 Pull Requests de desenvolvimento do próprio matryoshka-harness (abertos no board público do projeto no GitHub), somando 85 subtasks do zero até a versão atual (CLI, motor de AST em WASM, servidor MCP, migrador de regras, linter de contexto e suíte de testes):
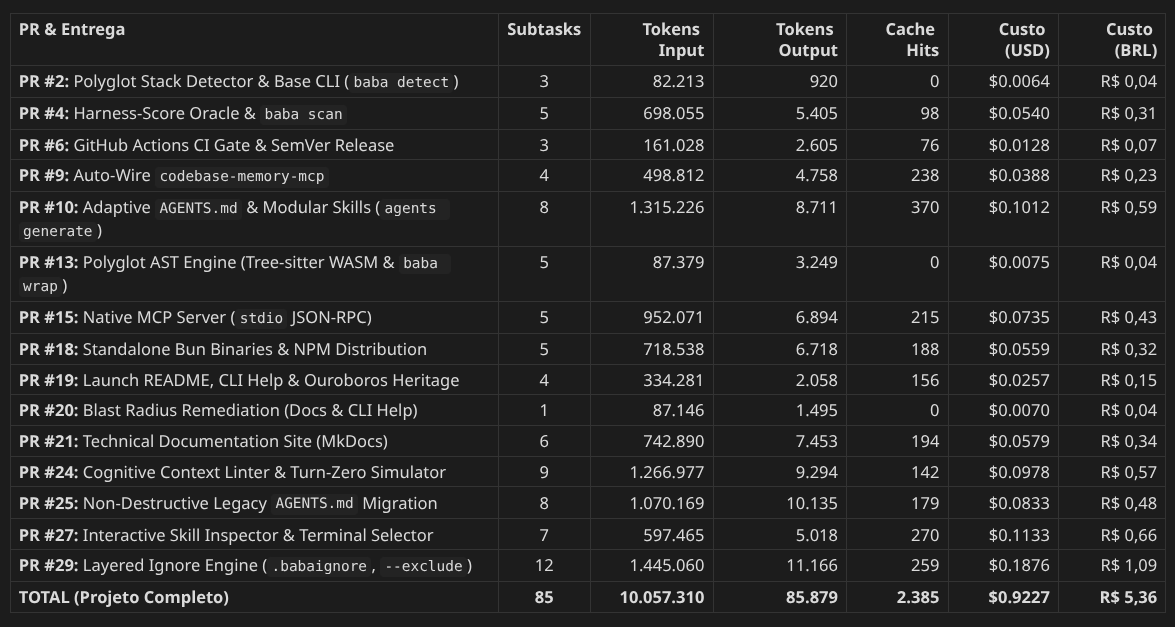
$0.9227 USD (R$ 5,36).
Ao longo dos 15 PRs, a esteira processou 10.057.310 tokens de entrada e 85.879 tokens de saída por $0.9227 USD (R$ 5,36) usando o modelo gemini-3.8-flash (com câmbio travado em R$ 5,80/USD). Mesmo somando as execuções intermediárias barradas nas issues #1 e #11, o desenvolvimento completo ficou abaixo de 1 dólar.
Na tabela acima, a coluna Cache Hits (2.385 no acumulado) indica a quantidade de turnos e requisições de API que bateram no prefixo aquecido em cache KV durante as 85 subtasks, e não tokens isolados. Como a maior parte do volume de entrada incidiu sobre a faixa de cached input tokens (que aplica desconto de 75% a 90% sobre a tarifa cheia do provedor), o custo efetivo médio caiu para cerca de $0.092 por milhão de tokens de entrada.
Também dá para notar na tabela por que PRs curtos (como o #2, #13 e #20, na faixa de 80 mil tokens divididos em subtasks rápidas) registraram 0 cache hits. Na API do Gemini, o Context Caching exige um piso mínimo de volume por requisição: começou em 32.768 tokens no Explicit Caching e hoje dispara via Implicit Caching a partir de 2.048 tokens (linha Gemini 2.5) ou 4.096 tokens (linhas Gemini 3). Nas entregas rápidas, os turnos rodaram abaixo desse piso. Já nas entregas mais densas, que acumularam de 500 mil a 1,4 milhão de tokens (PRs #10, #15, #24 e #29), a janela cruzou o piso logo nos primeiros turnos e engatou de 140 a 370 requisições cacheadas em sequência.
Como próximo passo de roadmap (Issue #31, ainda em desenvolvimento e não mesclado na CLI atual), estamos projetando um Fast-Gate de Sistema 1 integrado a encoders locais leves baseados em Jev / ModernBERT / Laya (NandhaKishorM/laya). Em vez de acionar um LLM grande para decisões binárias (como checar se um comando de terminal é destrutivo ou se um arquivo fere uma regra de pasta), um cliente local via POST /predict (HTTP ou Unix Domain Socket) classificará a intenção (noul, choice, score) na CPU com meta abaixo de 25ms a custo zero de tokens; se o daemon local passar do timeout de 50ms, o harness cairá automaticamente para as heurísticas em Tree-sitter WASM sem travar o terminal.
3. Fim do Instruction Debt em AGENTS.md e CLAUDE.md (baba agents audit)
Depois de enxugar o AGENTS.md e separar as matérias em .agents/skills/, o problema passa a ser o dia seguinte: impedir que novos PRs voltem a despejar regras soltas e exemplos gigantes na raiz do projeto.
Skills de revisão via LLM, como o /doctor prompt-audit4 em anthropics/skills, ajudam a fazer uma faxina semântica periódica quando o arquivo já acumulou instruções contraditórias. Já para rodar a cada commit no pre-commit ou no GitHub Actions sem gastar tokens nem depender de rede, o comando baba agents audit (PR #24) funciona como um linter estático direto na árvore do repositório:
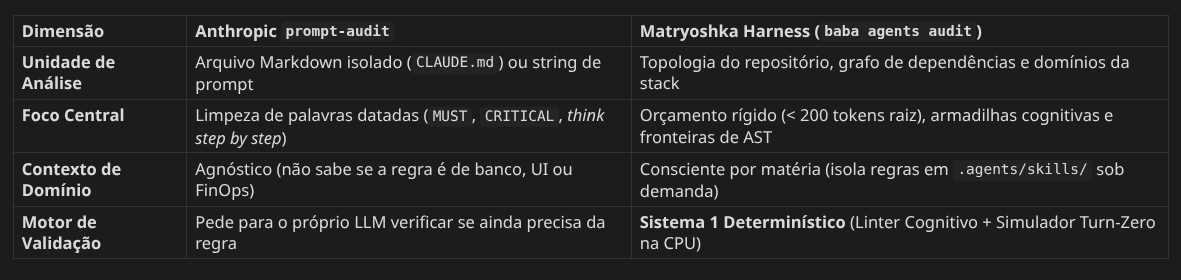
baba agents audit.
O baba agents audit valida primeiro o tamanho e a integridade estrutural do contexto: dispara um alerta quando o AGENTS.md passa de 200 tokens e falha o build (exit code 1) acima do teto rígido de 250 tokens (token-budget), barra blocos de código ou schemas com mais de 25 linhas na raiz que deveriam morar na skill específica da matéria (greedy-preload) e verifica no disco se todos os arquivos apontados em .agents/skills/ realmente existem (dead-skills), evitando que o agente gaste turnos tentando ler uma skill que foi movida ou apagada.
Em seguida, ele inspeciona o texto atrás de dois vícios comuns na escrita de regras: o acúmulo de proibições soltas (NEVER do X, DO NOT use Y) sem indicar qual padrão usar no lugar (negative-phrasing-trap), e instruções ambíguas como “tente usar”, “se possível” ou “considere” (permissive-leak). Para um LLM, sugestão vira escolha opcional; se uma regra é invariante do projeto, ela precisa estar escrita no imperativo.
4. A Arquitetura das 5 Camadas: Um Harness Dentro de um Harness (A Boneca Russa)
A metáfora da Matryoshka (a boneca russa) descreve cinco camadas de naturezas distintas que atuam em sequência, formando um harness dentro de outro. Depender apenas de instruções em Markdown (AGENTS.md) faz o modelo diluir regras no meio de uma sessão longa; depender só de linter sintático deixa o agente duplicar serviços por desconhecer a topologia do projeto. No Matryoshka, esse cercamento de contexto distribui a responsabilidade entre diagnóstico estrutural da base (L1), grafo de chamadas (L2), escopo de instruções e skills sob demanda (L3), árvore sintática em WASM (L4) e servidor MCP (L5). Quando uma camada externa deixa passar uma ambiguidade do modelo, o anel interno barra a execução de forma determinística antes do commit:
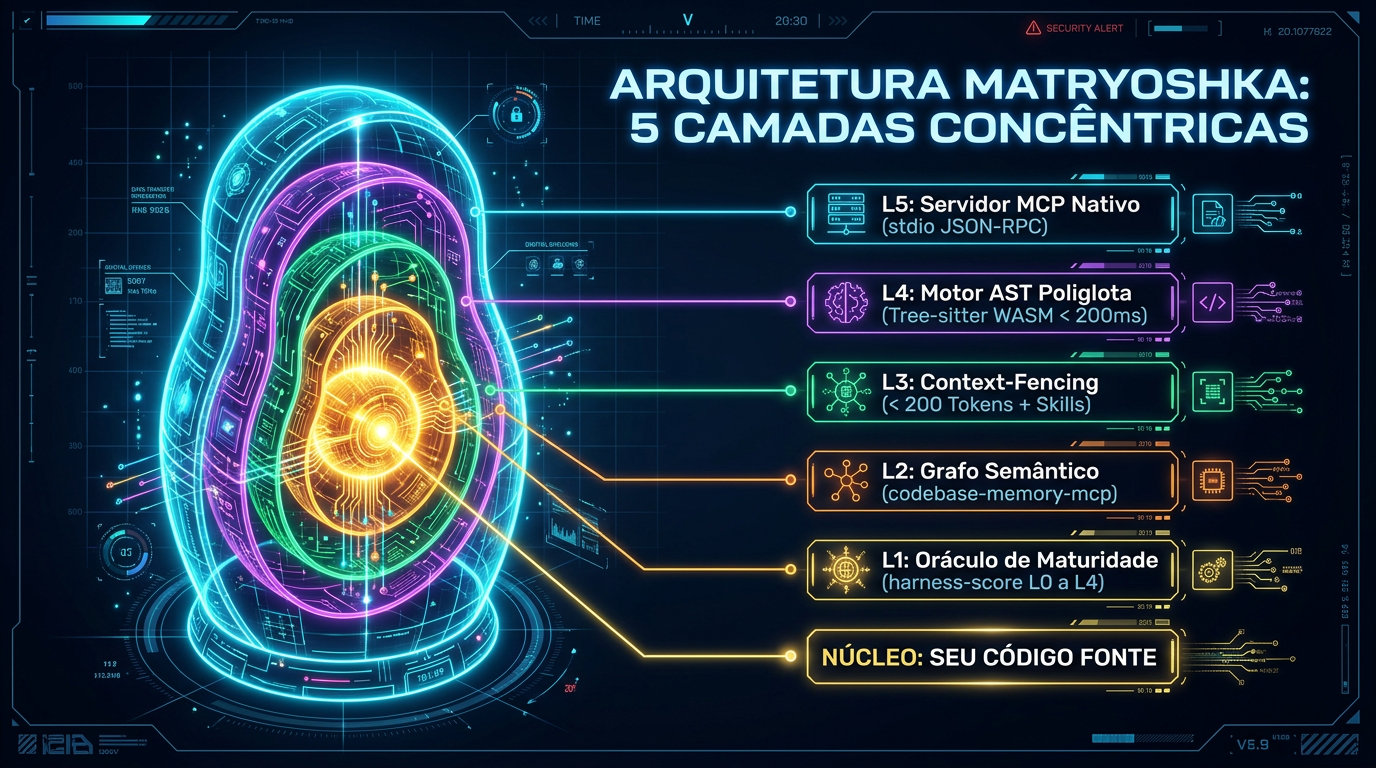
Camada 1: Avaliação de Regras (paladini/harness-score) e Reconciliação Semântica (baba scan)
Na base do núcleo, o comando baba scan [--badge] [--json] (PR #4 e PR #32) avalia os mesmos critérios do paladini/harness-score, executando o binário oficial se estiver disponível no PATH ou o avaliador equivalente embutido no próprio baba. A pontuação soma até 105 pontos distribuídos em cinco eixos: Context (CTX-01 a CTX-03, 30 pts), que verifica a presença do AGENTS.md (15 pts), do ARCHITECTURE.md (10 pts) e do README.md (5 pts); Skills (SKL-01, 15 pts), que checa o diretório modular .agents/skills/; Guardrails (CI-01, GRD-01 e GRD-03, 20 pts), cobrindo pipeline de CI (.github/workflows/, .gitlab-ci.yml), .gitignore e linter/formatter configurado (biome.json, ruff.toml, .golangci.yml, rustfmt.toml); Sensors (SNS-01 e SNS-02, 30 pts), que valida suíte de testes (tests/, spec/, __tests__) e manifesto de build (package.json, pyproject.toml, go.mod, Cargo.toml, Gemfile, composer.json); e Hygiene (HYG-01, 10 pts), referente ao arquivo LICENSE na raiz.
Essa nota enquadra o repositório nos cinco níveis de maturidade do harness-score, indo do L0 (Unharnessed), em que toda sessão parte do zero (cold-start), passando por L1 (Documented) com um AGENTS.md ou CLAUDE.md inicial e L2 (Guided) com regras escopadas em skills e higiene básica de Git, até chegar ao L3 (Sensing), onde testes, tipagem e CI validam o trabalho do agente, e ao L4 (Self-correcting), em que hooks de pre-commit e gates fecham o loop barrando padrões destrutivos e devolvendo instruções estruturadas de correção antes do merge.
Além de calcular o score, o baba scan cruza essas regras com a árvore real de arquivos do repositório (respeitando .gitignore e .babaignore). Ele varre o código para localizar rotas (routes/, api/, urls.py), controllers/views e models de dados — confirmando no código heranças e declarações de ORM como models.Model no Django, DeclarativeBase no SQLAlchemy, BaseModel no Pydantic, @Entity no TypeORM, schemas Prisma/Drizzle/Zod, structs gorm/db em Go ou derives Diesel/SeaORM/SQLx em Rust. Com isso, cada gap apontado na avaliação já sai acompanhado da lista exata de arquivos que precisam entrar no boilerplate.
Camada 2: Grafo Semântico (codebase-memory-mcp)
A segunda camada integra o DeusData/codebase-memory-mcp (PR #9) para dar navegação estrutural ao agente sem queimar dezenas de turnos rodando grep pela árvore de diretórios. Ao avaliar as ferramentas listadas no IAAR-Shanghai/Awesome-AI-Memory e em github.com/topics/agent-memory, ficou claro que a maior parte do ecossistema resolve outros problemas: projetos de memória episódica como akitaonrails/ai-memory e thedotmack/claude-mem focam em handoff de sessão entre Claude Code, Codex e Cursor, mas não montam o grafo de chamadas (call graph) do código; motores de memória conversacional como mem0ai/mem0, letta-ai/letta e getzep/zep extraem fatos de diálogos usando bancos vetoriais e chamadas extras de LLM; filesystems virtuais como volcengine/OpenViking organizam documentos sob protocolos de resumo (viking://); já no campo de código, o oraios/serena exige subir processos Language Server (LSP) por linguagem no host e o yamadashy/repomix concatena o repositório inteiro num único arquivo texto, o que estoura o orçamento de tokens em monólitos.
O DeusData/codebase-memory-mcp entrou na Camada 2 por resolver especificamente a memória estrutural de código num binário nativo único e estático, sem depender de servidores LSP externos, banco de dados separado ou chaves de API. Ele combina gramáticas Tree-sitter com inferência de tipos híbrida, indexa o repositório num snapshot local compactado (.codebase-memory/graph.db.zst) e expõe o grafo via MCP (search_graph, trace_path, get_code_snippet e query_graph em Cypher). Por operar 100% offline sobre stdio, o binário pode ter sua versão/hash fixada e rodar confinado em containers sem rede (--network none). Com um baba mcp wire, o agente rastreia a cadeia de chamadas (inbound/outbound) e carrega na janela de contexto apenas o snippet exato da função que vai alterar.
Camada 3: Boilerplate Estrutural, AGENTS.md Limitado e Skills Especialistas por Matéria (baba agents / baba fix)
Em vez de despejar um template estático igual para qualquer projeto, os comandos baba agents generate e baba fix (PR #10, PR #25 e PR #27) primeiro inspecionam os manifestos do repositório (package.json, pyproject.toml, requirements.txt, go.mod, Cargo.toml, Gemfile, composer.json), dependências instaladas e estrutura de pastas via baba agents profile, classificando a base em um de cinco arquétipos (api_backend, opinionated_monolith, reactive_frontend, systems_microservice ou fullstack_hybrid).
A partir desse diagnóstico, o Matryoshka gera o boilerplate estrutural que faltava para cobrir os requisitos do harness-score e separa o conhecimento do projeto em dois níveis. Na raiz, ele cria o esqueleto de ARCHITECTURE.md já listando as rotas, models e controllers encontrados na árvore (fechando o gap estrutural CTX-02 e deixando o .matryoshka/scan-report.md pronto para que uma rodada seguinte com o agente do usuário — ou o loop padrão do Ouroboros — preencha o detalhamento semântico da arquitetura), um workflow em .github/workflows/ci.yml ajustado para o test runner detectado (fechando o gap CI-01) e um AGENTS.md limitado a menos de 200 tokens (teto rígido de 250). Como o AGENTS.md da raiz é lido em todos os turnos, ele guarda apenas o mapa operacional: arquétipo, runtime, comandos exatos de build/test/lint da stack, três invariantes de escopo (YAGNI/DRY, zero refatoração fora da tarefa e validação obrigatória por teste) e a tabela de ponteiros para as skills.
Todo o conhecimento específico de cada matéria do repositório sai da raiz e vai para skills independentes dentro de .agents/skills/, cada uma com um cabeçalho YAML curto (< 40 tokens com name e description) para evitar que os editores carreguem o texto completo na largada da sessão. Cada skill é compilada sob medida para as bibliotecas encontradas nos manifestos: backend/SKILL.md traz as regras de transação e prevenção de N+1 do ORM detectado (como select_related/prefetch_related no Django, selectinload/joinedload no SQLAlchemy, include/select no Prisma ou Preload no GORM); database/SKILL.md cobre migrations zero-downtime e travas da engine de banco (CREATE INDEX CONCURRENTLY e lock_timeout no PostgreSQL, ALGORITHM=INPLACE, LOCK=NONE no MySQL ou PRAGMA journal_mode=WAL no SQLite); frontend/SKILL.md isola fronteiras de Server/Client Components, reatividade, A11y e CLS para o par de UI e CSS do projeto (Next.js, React, Vue/Nuxt, Svelte, Astro, Angular, Tailwind); security/SKILL.md adapta guardrails de sessão, RLS e proteção contra IDOR/SSRF à biblioteca de autenticação (Next-Auth, Clerk, Supabase Auth, JWT, Django Allauth, Passport); e testing/SKILL.md define o fluxo Red-to-Green para o runner instalado (bun test, vitest, jest, pytest, go test, cargo test, rspec, pest/phpunit, Playwright, Cypress). Se o repositório já tinha um AGENTS.md, CLAUDE.md ou .cursorrules escrito pelo time, o migrador (baba agents migrate ou baba fix) salva um backup .bak e preserva integralmente as regras humanas dentro de .agents/skills/<project-name>/SKILL.md:
<workspace_root>/
├── AGENTS.md                          # Cerca raiz (< 200 tokens, estável no topo do prompt)
├── ARCHITECTURE.md                    # Boilerplate com rotas, models e controllers detectados
├── .github/workflows/ci.yml           # Boilerplate de CI ajustado ao runtime e test runner
└── .agents/
    └── skills/                        # Carregadas sob demanda via índice YAML (< 40 tokens)
        ├── SKILL.md                   # Registro mestre do inventário de skills
        ├── backend/SKILL.md           # Regras específicas do ORM detectado (ex: Django, Prisma)
        ├── frontend/SKILL.md          # Regras do framework UI e CSS (ex: Next.js, Tailwind)
        ├── database/SKILL.md          # Migrations e locks da engine (ex: PostgreSQL, SQLite)
        ├── security/SKILL.md          # Guardrails de auth e OWASP (ex: Clerk, JWT, Allauth)
        ├── testing/SKILL.md           # Contrato Red-to-Green para o runner (ex: pytest, vitest)
        └── <project-name>/SKILL.md    # Regras humanas legadas migradas sem perda (.bak)
Quando a tarefa é criar uma migration no banco, em vez de carregar um monólito de 2.000 tokens cheio de regras de React, Tailwind e rotas de frontend, o agente lê apenas os ~180 tokens do AGENTS.md raiz + ~40 tokens do índice YAML e abre somente database/SKILL.md (~250 tokens), reduzindo de 75% a 85% o volume de instruções injetadas naquele turno. Atingir o score estrutural L4 no harness-score via baba fix coloca toda essa fundação mecânica (arquivos, skills, CI e hooks) no lugar, mas a autocorreção confiável em produção depende da rodada seguinte com o agente do usuário para preencher as regras de negócio apontadas no .matryoshka/scan-report.md e da qualidade da suíte de testes do projeto.
Camada 4: Análise de AST Poliglota em Tree-sitter WASM (baba wrap)
Linters tradicionais (ESLint, PyAST, plugins de compilador) exigem que o host tenha o runtime de cada linguagem e ambientes virtuais configurados, o que frequentemente falha em sandboxes efêmeras. Para remover essa dependência de ambiente, o comando baba wrap (PR #13) roda diretamente no Bun combinando parsers em WebAssembly (WASM) e inspeção estrutural de AST em memória.
O motor varre arquivos em TypeScript, JavaScript, Python, Go e Rust (pulando binários pelos primeiros 8KB, limitando arquivos a 500KB e aplicando timeout de 2.000ms por arquivo) atrás de três antipadrões recorrentes em código gerado por agentes. O primeiro gate (raw-sql / sql-interpolation, CWE-89) inspeciona nós de template literal, f-strings, concatenações dinâmicas com +/|| e chamadas como fmt.Sprintf contendo cláusulas SQL (SELECT ... FROM, INSERT INTO, UPDATE ... SET, DELETE FROM), exigindo queries parametrizadas. O segundo (assertionless-test, ativado via --include-tests) analisa o corpo das funções de teste (it/test, def test_*, func Test*, #[test]) e barra testes falsos-verdes que instanciam mocks mas terminam sem nenhuma asserção real — reconhecendo nativamente expect(...), assert(...), .should, t.throws (TS/JS), assert, self.assert*, pytest.raises/warns (Python), t.Fatal/Error, assert.*, require.* (Go) e assert!, assert_eq!, assert_matches! (Rust). Já o terceiro (hardcoded-credential) passa as strings literais por um funil para evitar falsos positivos em textos comuns como application/json (~3,4 bits de entropia): ele descarta leituras de ambiente (process.env, os.environ, os.Getenv, config., settings.), URLs, caminhos de arquivo e valores de mock (test, dummy, placeholder, localhost), e em seguida bloqueia prefixos conhecidos (sk_live_, ghp_, AKIA, AIza, xoxb-) ou atribuições a variáveis sensíveis (api_key, secret, token, password, jwt_secret) cuja string tenha >= 16 caracteres e Entropia de Shannon (H(S) = -∑ p(x) log₂ p(x)) acima de 3.0 bits/caractere.
O Ponto Cego da Casca Monoglota: Injeção em Profundidade (Nested Code Injection)
Ferramentas tradicionais de SAST e linters (ESLint, Biome, Sonar, Ruff, Bandit) enxergam a fronteira do arquivo, não a fronteira do payload: arquivos .ts recebem apenas regras de TypeScript e arquivos .py recebem apenas regras de Python. Em orquestradores de agentes, geradores de templates e workers de code-gen, porém, é comum um serviço em Node/TypeScript montar scripts Python ou Go on-the-fly dentro de uma template string para despachar num subprocesso ou sandbox, carregando ali dentro uma query vulnerável como f"SELECT * FROM users WHERE id = {user_id}".
Os linters estáticos convencionais deixam esse código passar porque, para a AST monoglota do TypeScript, uma string entre crases sem ${} é apenas um texto opaco (TemplateElement), enquanto o Ruff ou o Bandit sequer são acionados por conta da extensão .ts do arquivo hospedeiro. Como o motor do Matryoshka inspeciona nós sintáticos e assinaturas estruturais de injeção (TemplateLiteral, FormattedString, fmt.Sprintf, interpolação %s e cláusulas SQL) de forma independente da extensão do arquivo, o baba wrap atravessa a casca do orquestrador TypeScript e barra a query vulnerável embutida no payload Python.
Benchmarks de Referência, Limites da AST e a Origem do .babaignore (PR #29)
Nenhuma análise sintática estática sem type-checking semântico completo está livre de casos de borda. Bibliotecas de ORM que usam tagged template literals já parametrizados internamente (como sql`SELECT * FROM users WHERE id = ${id}` no Postgres.js ou Prisma) e suítes que delegam o expect() para funções helper externas podem acionar alertas se não forem escopadas.
Vimos essa detecção em profundidade atuar contra a nossa própria suíte quando rodei baba wrap --include-tests no repositório do matryoshka-harness (que possui 51 arquivos TypeScript/JavaScript de código-fonte e mais de 1.000 testes). Em uma máquina Linux local (8 vCPUs, 16GB RAM rodando Bun), a varredura dos 51 arquivos leva entre 45ms e 110ms (menos de 15ms por arquivo, abaixo do teto de 200ms). Na primeira execução incluindo a pasta de testes, porém, o score de AST caiu para zero com 53 violações críticas: o motor atravessou os arquivos .ts de teste e flagrou dezenas de payloads Python (FormattedString com f"SELECT ...") e Go (fmt.Sprintf) que estavam dentro de strings TypeScript como fixtures para testar o próprio detector. Para escopar esse tipo de caso (fixtures poliglotas de segurança, tagged templates auditados e pastas geradas), criamos no PR #29 o arquivo .babaignore e a flag --exclude com precedência sobre o .gitignore.
Camada 5: Servidor MCP Nativo via stdio e Isolamento de Stream (baba mcp)
Fechando o anel externo, o comando baba mcp serve (PR #15) expõe o Matryoshka como um servidor Model Context Protocol (MCP) nativo sobre stdio (JSON-RPC 2.0). Rodar sobre stdio em vez de abrir portas HTTP/SSE em localhost evita requisições locais não autenticadas e permite operação dentro de containers sem rede (--network none).
Como em conexões MCP via stdio qualquer console.log acidental no stdout corrompe o frame JSON-RPC e derruba a sessão no editor, o servidor ativa o interceptador installStderrLoggingGuard, redirecionando logs para stderr e reservando o stdout exclusivamente para mensagens do protocolo. Conectado ao Cursor, Claude Code, Zed ou Gemini CLI, o servidor disponibiliza quatro tools (detect_stack, scan_harness, generate_agents e wrap_context), os resources matryoshka://agents e matryoshka://diagnostic, e o prompt audit_repository. Para configurar os editores sem editar JSON na mão, o comando baba mcp wire faz um deep merge idempotente em .cursor/mcp.json, .claude/mcp.json e .gemini/settings.json, preservando os demais servidores MCP já instalados na máquina.
5. O Contrato de Auto-Remediação (DIAGNOSTIC.md): Erros Compilados para a Janela de Atenção
Quando um linter tradicional ou um step de CI falha num repositório grande, ele despeja centenas de linhas de stacktrace e warnings desordenados no stdout. Copiar essa saída bruta e colar no prompt do agente queima milhares de tokens de uma vez e espalha o foco do modelo, que acaba consertando um aviso cosmético de formatação enquanto deixa uma query SQL interpolada ou um teste sem asserção passar batido.
Uma verificação determinística fecha o loop de forma econômica quando a própria saída do verificador funciona como uma interface estruturada para o agente probabilístico. Ao rodar baba wrap, o diagnóstico já sai compilado como instrução de reparo no arquivo DIAGNOSTIC.md:
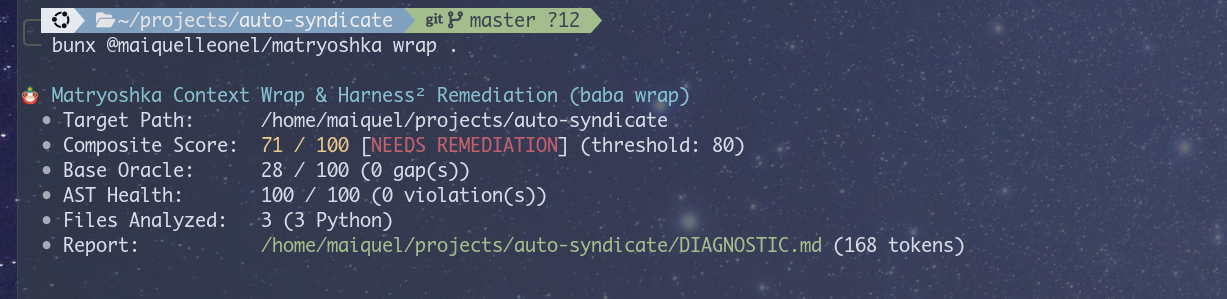
baba wrap no terminal: cálculo do Harness² Composite Score e geração do contrato DIAGNOSTIC.md com orçamento controlado de tokens.
Repare na última linha do terminal (168 tokens num serviço Python enxuto de 3 arquivos, ou ~420 tokens ao varrer os 51 arquivos TypeScript/JavaScript do próprio matryoshka-harness com score estrutural 90/100). O gerador grava um relatório enxuto na raiz do repositório:
# 🛡️ Matryoshka Diagnostic & Harness² Remediation Report

**Generated:** 2026-11-05T01:52:36.755Z
**Target Repository:** `/home/maiquel/projects/matryoshka-harness`
**Harness² Composite Score:** **95 / 100** [Status: PASS]

---

## 📊 Score Breakdown
- **Base Repository Hygiene (Oracle):** 90 / 100
- **AST Context-Fencing Health:** 100 / 100
- **Total Files Analyzed:** 51 files (42 TypeScript, 9 JavaScript)
- **Violations Detected:** None (Clean — test fixtures scoped via .babaignore)

---

## 🚨 Detected AST Violations
No AST context-fencing violations detected. Repository is clean!

---

## 🎯 Step-by-Step Surgical Action Plan
1. [x] All governance gates and AST context-fencing rules satisfied.
2. [ ] Re-run `baba wrap --strict` in CI to ensure continuous compliance.
E quando o motor de AST encontra violações no código (como um SQL Injection ou um teste falso-verde), a seção Detected AST Violations lista cada falha com coordenada exata na árvore sintática:
### 1. [CRITICAL] Unparameterized SQL Query (SQL Injection Hazard)
- **File:** `src/db/users.ts:42`
- **Node Type:** `TemplateLiteral`
- **Remediation:** Use parameterized queries or bound arguments (e.g., 'SELECT * FROM users WHERE id = $1', [userId]) instead of string interpolation.

### 2. [HIGH] Assertionless Test Case (False Green Hazard)
- **File:** `tests/billing.test.ts:18`
- **Node Type:** `CallExpression`
- **Remediation:** Add at least one explicit assertion or expectation (e.g., expect(...).toBe(...), assert.strictEqual(...)) to verify behavior.
Para que o agente localize e corrija essas falhas no turno seguinte sem estourar a janela de contexto, o gerador do DIAGNOSTIC.md aplica um teto rígido de 1.500 tokens (MAX_DIAGNOSTIC_TOKENS = 1.500), calculando o peso em tempo real e reservando até 250 tokens para o plano de ação do rodapé; se um monólito legado tiver 300 violações e encostar nesse limite, o relatório trunca o excedente e aponta para baba wrap --json. Além disso, todas as falhas são ordenadas por severidade estrita (CRITICAL, depois HIGH, MEDIUM e LOW, desempatando por arquivo e linha) para posicionar vulnerabilidades de SQL/credenciais e testes sem asserção no topo do arquivo, onde a atenção do modelo é mais forte. Cada item já entrega o caminho relativo, linha, tipo do nó (Node Type) e a instrução de refatoração, sendo gravado de forma atômica (.tmp seguido de rename) e exposto via MCP em matryoshka://diagnostic para que o agente valide a correção rodando baba wrap --strict antes de abrir o PR.
6. Testando num Repositório Existente (Leitura e Boilerplate)
Modelos novos saem a cada trimestre, mas continuam sem adivinhar as fronteiras de um repositório que não expõe sua topologia. Enquanto todas as convenções do projeto ficarem misturadas num único AGENTS.md gigante e a validação depender só de revisão visual humana, o time continua pagando por invalidação de cache KV e deixando testes sem assert passarem no CI.
Escrevi o Matryoshka em Bun (distribuído via bunx no NPM e como binários nativos para Linux, macOS e Windows) expondo três aliases para o mesmo executável: baba (quatro letras alternadas no teclado para uso rápido no terminal), bbyg (referência à Baba Yaga do folclore eslavo, usado nas sandboxes de automação para disparar bbyg fix --yes) e matryoshka (o nome explícito para pipelines de CI/CD). Os comandos de diagnóstico (detect, scan, agents audit e wrap --dry-run) rodam localmente na CPU e não alteram nenhum arquivo no disco:
# 1. Mapa instantâneo da stack, runtime e test runner (evita turnos de ls/grep)
bunx @maiquelleonel/matryoshka detect

# 2. Avaliar os 5 eixos do harness-score (0 a 105 pts) e o nível de maturidade (L0 a L4)
bunx @maiquelleonel/matryoshka scan

# 3. Auditar o AGENTS.md / CLAUDE.md atual contra instruction debt e teto de 200 tokens
bunx @maiquelleonel/matryoshka agents audit

# 4. Varrer a AST (< 200ms) atrás de testes sem assert, SQL interpolado e segredos
bunx @maiquelleonel/matryoshka wrap --include-tests --dry-run
E para gerar o boilerplate completo no repositório (AGENTS.md < 200 tokens, ARCHITECTURE.md, skills especialistas em .agents/skills/, workflow .github/workflows/ci.yml e configuração do MCP nos editores):
# Instalar globalmente via Bun (ou baixar o binário nativo nas Releases do GitHub)
bun add -g @maiquelleonel/matryoshka

# 1. Gerar os boilerplates estruturais, migrar regras legadas e gravar .matryoshka/scan-report.md
baba fix

# 2. Rodar mais um turno com o seu agente local (Claude Code, Cursor, Gemini CLI)
#    apontando para .matryoshka/scan-report.md e DIAGNOSTIC.md para preencher as lacunas mapeadas
#    (no Ouroboros, essa segunda rodada já roda por default na esteira)

# 3. Gate determinístico para GitHub Actions / hook de pre-commit
baba agents audit --strict && baba wrap --include-tests --strict
Quando você rodou o baba scan e o baba wrap --include-tests --dry-run no seu projeto principal, qual foi o Score de 0 a 100 e em qual nível entre L0 e L4 ele caiu? Conta aí nos comentários — principalmente se o motor de AST desmascarou algum teste falso-verde que estava passando limpo no seu CI.
📚 Fontes, Código-Fonte e Leituras Recomendadas
Projetos e Ecossistema Citados no Artigo:
- Oráculo de Maturidade (Camada 1):
paladini/harness-score - Grafo Semântico de Código via MCP (Camada 2):
DeusData/codebase-memory-mcp - System-1 Fast-Gate / ModernBERT (Issue #31):
NandhaKishorM/laya - Execution Harness Autônomo (SDD): Ouroboros Engine — LeonelLabs
-
Maiquel Leonel — O Harness, o SDD e o Vibe Coding: Uma Abordagem de Engenharia (Blog, 2026). ↩
-
Maiquel Leonel — O SDLC Agêntico: Um Caminho pra Sair do Loop (Blog, 2026). ↩
-
Addy Osmani — Instruction Debt em arquivos CLAUDE.md / AGENTS.md e
prompt-audit(LinkedIn, 2026). ↩ -
Lance Martin / Anthropic —
prompt-audit.md: Auditing CLAUDE.md and Agent Instructions for Instruction Debt (anthropics/skillsno GitHub, 2026). ↩ ↩2 -
Daniel Jaroslawicz, Brendan Whiting, Parth Shah & Karime Maamari (Distyl AI) — How Many Instructions Can LLMs Follow at Once? (IFScale) (arXiv:2507.11538, 2025) · Keno Harada et al. — Curse of Instructions: Large Language Models Cannot Follow Multiple Instructions at Once (ManyIFEval) (ICLR 2025). ↩
-
Kelly Hong, Anton Troynikov & Jeff Huber (Chroma Research) — Context Rot: How Increasing Input Tokens Impacts LLM Performance (Technical Report, 2025) · Nelson F. Liu et al. (Stanford) — Lost in the Middle: How Language Models Use Long Contexts (TACL / arXiv:2307.03172, 2024). ↩
-
Matryoshka Harness (
baba) — Repositório Oficial (MIT) · Pacote NPM@maiquelleonel/matryoshka· Documentação & Hotsite · Roadmap Público (GitHub Project #4). ↩ -
Gergely Orosz / OpenAI — Inside OpenAI’s agentic software factory (The Pragmatic Engineer, 2026) · Ryan Lopopolo (OpenAI) — Harness engineering: leveraging Codex in an agent-first world (OpenAI Engineering, 2026). ↩
-
Anthropic — Effective harnesses for long-running agents & The AI-Native SDLC Playbook (Anthropic Engineering, 2025–2026). ↩
