Harness Engineering na Prática: Do AGENTS.md Infinito ao Context-Fencing com Matryoshka
Agente autônomo sem cerca determinística é estagiário com credencial de root e sem code review.
Se você já abriu um Pull Request gerado por IA e encontrou uma suíte de 40 testes verdes onde nenhum deles tinha um único assert, você sabe exatamente como é bater no Vibe Coding Cliff.
Quando você tira ferramentas como Cursor, Claude Code, Zed ou Gemini CLI dos projetos de fim de semana e coloca para rodar em um repositório corporativo de centenas de milhares de linhas, o problema raramente é sintaxe. Compilador e linter pegam erro de digitação na hora. O desgaste real aparece nos atalhos silenciosos que passam pelo CI: testes falsos-verdes (assertion-free tests, equivalentes a um expect(true).toBe(true) disfarçado com mocks), abstrações especulativas com três camadas de indireção para resolver um bug de cinco linhas e utilitários duplicados porque o agente não mapeou a árvore do projeto.
Para tentar estancar essa bagunça, a reação instintiva dos times é criar um arquivo AGENTS.md, CLAUDE.md ou .cursorrules na raiz e ir empilhando proibições em caixa alta (CRITICAL: NEVER DO X, ALWAYS CHECK Y) a cada tropeço novo da máquina.
Semanas atrás, Addy Osmani trouxe luz a esse problema ao destacar o comando prompt-audit (criado por Lance Martin no ecossistema do Claude Code) e o conceito de Instruction Debt (dívida de instrução). O diagnóstico deles é cirúrgico: conforme os modelos evoluem, esses arquivos de configuração acumulam “cicatrizes” (scar tissue) cheias de regras contraditórias e rituais manuais que degradam o raciocínio nativo dos modelos de fronteira. No fim das contas, um AGENTS.md monolítico de 2.000 linhas cobra dois impostos caros:
- Diluição de atenção no Turno Zero: Despejar regras de banco de dados, estilo de CSS e travas de segurança num único bloco satura a janela de contexto. No meio de uma refatoração longa, o mecanismo de atenção perde o foco das restrições críticas e o agente volta a operar apenas pela plausibilidade (como explorei no laboratório com o Savage Worlds Dice Roller e no ensaio sobre o SDLC Agêntico).
- Quebra de cache KV e sangria de FinOps: Enviar milhares de tokens estáticos ao longo de 150 iterações diárias queima orçamento com leitura repetida. Pior: toda vez que alguém edita uma linha nesse arquivo global, o prefixo do prompt muda, invalidando o Prompt Caching na API do provedor e forçando a cobrança da tarifa cheia em todas as chamadas seguintes.
Só que há um ponto mais fundo que apenas limpar arquivos Markdown: a maior parte do instruction debt nasce porque os times tentam resolver “no grito” (no prompt) o que deveria ser barrado por compilador, AST e grafo de chamadas.
Para resolver essa equação na arquitetura do repositório, estou abrindo o código do Matryoshka Harness (acessível no terminal pelo binário baba). Ele implementa o Cercamento Concêntrico de Contexto (Concentric Context-Fencing): cinco anéis determinísticos que mantêm o arquivo raiz abaixo de 200 tokens, carregam skills por domínio sob demanda, indexam o código num grafo semântico via MCP e rodam um motor de AST em WebAssembly (em menos de 200ms na CPU) para barrar testes vazios e falhas de segurança antes do commit.
1. Arquitetura de Harness Engineering: Harness Cognitivo vs. Fábrica de Execução
O Matryoshka foi extraído diretamente da trincheira de construção do Ouroboros na LeonelLabs, uma engine de entrega autônoma orientada a Spec-Driven Development (SDD).
Antes de entrar nos detalhes, vale separar duas camadas que o mercado vive misturando: Execution Harness e Context & Governance Harness.
Na engenharia tradicional (e na própria origem da palavra harness, o arreio de um cavalo), o modelo de linguagem é a força bruta de tração. Se você soltar essa força sem freio e sem rédeas num repositório legado, ela corre para o precipício. A governança se divide em dois papéis complementares:
- Context & Governance Harness (Matryoshka /
baba): Governa a cognição e as fronteiras do repositório. Ele prepara o terreno, compila umAGENTS.mdenxuto, orquestra as skills por domínio, fornece o grafo de chamadas via MCP e audita a AST localmente. Ele se pluga nativamente nos agentes que você já usa na sua máquina (Claude Code, Cursor, Zed, Gemini CLI) sem substituir o seu editor. - Execution Harness (Ouroboros Engine): Governa o silício e o isolamento físico. É a fábrica autônoma (Outcome-as-a-Service) onde o engenheiro atua como Tech Lead na fronteira do sistema (The Seam): você aprova o contrato BDD (
/ready4dev) e a engine sobe containers Linux efêmeros em airgap (--network none), roda o cicloRed -> Greene abre o Pull Request testado por centavos, sem você precisar assistir vídeo de terminal (como no Devin a $500/mês) ou ler diffs gigantes no escuro.
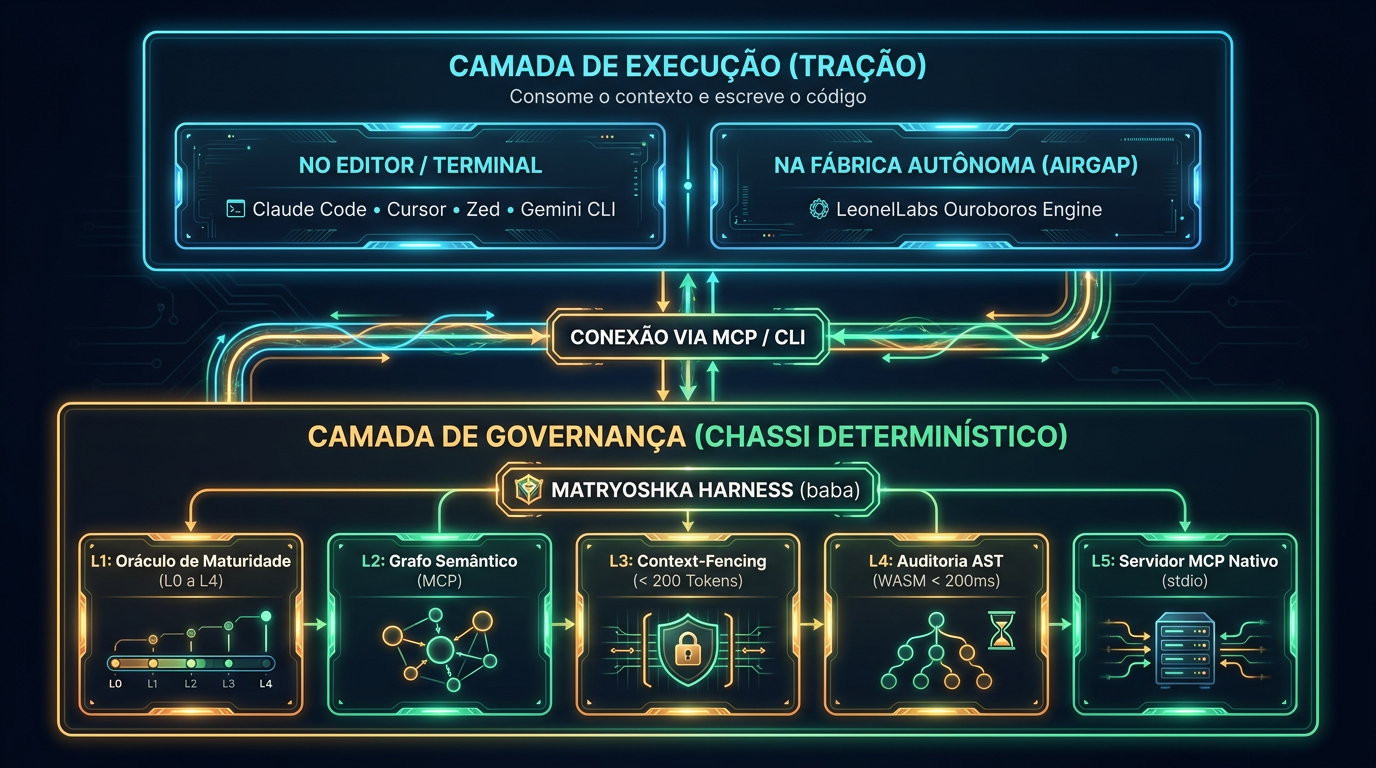
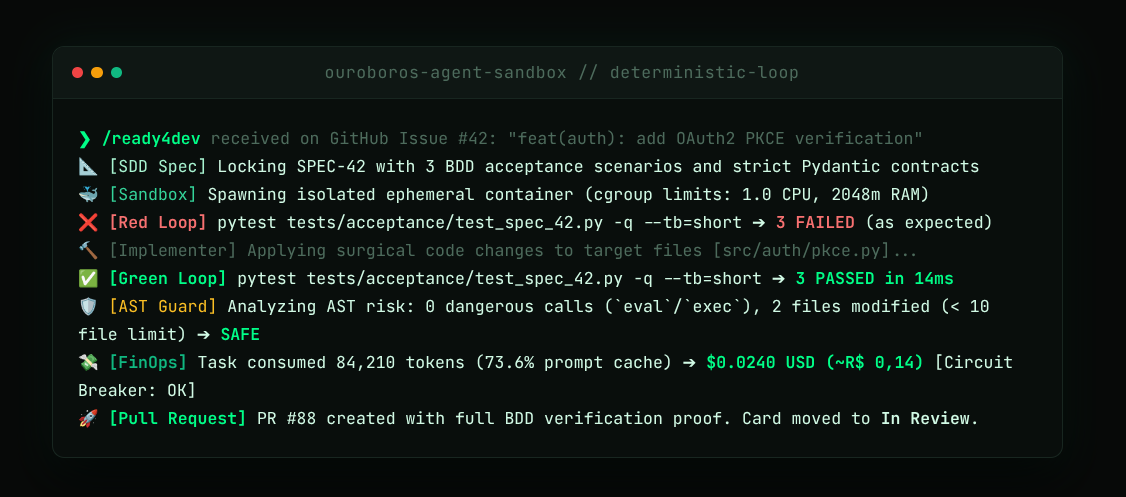
Dentro do Ouroboros, toda issue passa por cinco travas determinísticas: o Protocolo Socrático (/spec) fatia o PRD em cenários BDD atômicos; o Congelamento do Contrato (/ready4dev) trava os critérios de aceite com o Tech Lead; a Sandbox Airgap (--network none) isola a execução em topologia shared-nothing com o grafo MCP pré-aquecido (0ms cold-start); o agente cumpre o Ciclo Red -> Green em milissegundos; e a Dupla Contenção (AST + FinOps) inspeciona a árvore sintática enquanto um Circuit Breaker bimoeda (USD/BRL) corta a execução se o gasto encostar no teto de centavos:
O Gargalo do “Day One” e o Ponto Cego dos Grandes Labs
Enquanto eu rodava o Ouroboros em projetos novos (greenfield) ou em repositórios que já nasceram com contratos SDD, os pods entregavam features completas em minutos gastando frações de dólar. O choque de realidade veio quando apontei a esteira para monólitos legados e repositórios reais de clientes.
Quando você analisa os playbooks dos dois maiores laboratórios de IA hoje, o AI-Native SDLC da Anthropic e a Software Factory da OpenAI, há uma premissa silenciosa que quase nunca aparece nas apresentações: aqueles fluxos assumem microsserviços recém-criados ou os monorepos internos da própria OpenAI, que já foram desenhados para leitura de máquina. No chão de fábrica das empresas reais, o código que paga os boletos mora em bases full wild: repositórios antigos sem instruções para agentes (ou com um AGENTS.md de 2.000 linhas que estoura o cache), sem grafo de chamadas e com suítes de teste cheias de buracos.
| Dimensão de Engenharia | Anthropic (AI-Native SDLC) | OpenAI (Software Factory) | Matryoshka Harness (baba) + Ouroboros |
|---|---|---|---|
| Adoção em Legado | Idealizado para novos microsserviços (greenfield) | Moldado para os monorepos internos da própria OpenAI | Assimila monólitos legados no Day One (baba scan L0 -> L4) |
| Higiene de Contexto | /doctor prompt-audit via LLM sobre CLAUDE.md |
Schemas internos e documentação proprietária | Context-Fencing determinístico (< 200 tokens raiz + Skills modulares) |
| Navegação de Código | Busca textual e toolsets MCP genéricos | Índices internos fechados | Grafo Semântico de Chamadas local (codebase-memory-mcp) |
| Proteção de Escopo | Revisão via LLM ou regras em prompt de sistema | Ambientes efêmeros internos proprietários | AST Poliglota em Tree-sitter WASM (< 200ms na CPU, $0.00) |
| Soberania de Modelo | Lock-in exclusivo no ecossistema Claude | Lock-in na API e runtime da OpenAI | Agnóstico (Cursor, Claude Code, Zed, Gemini CLI e Ouroboros) |
Soltar um agente autônomo num repositório legado sem preparação fazia o modelo queimar dezenas de turnos rodando grep às cegas para descobrir quem chamava uma função, duplicar rotas que já existiam em outra pasta e acionar o Blast Radius Guard ou o Circuit Breaker financeiro antes de terminar a tarefa.
Ficou claro que uma fábrica autônoma precisa de um chassi de governança no repositório de destino. Para o Ouroboros assimilar qualquer base legada já no Day One, construí o motor de preparação de terreno (Matryoshka Auto-Harness): antes de escrever a primeira linha de feature em um repositório desconhecido, o sistema mede a maturidade da base, indexa o grafo semântico via MCP, fatia as regras da stack em skills sob demanda e arma as travas de AST.
Quando coloquei o próprio Ouroboros para construir o repositório do Matryoshka no GitHub, a primeira resposta automática na Issue #1 registrou esse protocolo de assimilação rodando na prática:
🛡️ [Matryoshka Harness L4 Configurado]
Detectei que este repositório ainda não possuía a cerca de governança necessária
para execução agêntica segura (Score inicial: 34%).
O agente estruturou automaticamente a camada de harness na branch task/issue-1...
Olhando para esse log na Issue #1, decidi dar um passo além. A dor do “Score 34%” no primeiro dia acontece com todo engenheiro que abre o Cursor, o Claude Code, o Zed ou o Gemini CLI numa base corporativa. Separei a engine inteira de assimilação e governança dos pods privados do Ouroboros e abri como uma biblioteca Open Source independente: o Matryoshka Harness.
2. FinOps de Agentes e Prompt Caching: A Conta Real dos PRs em Centavos
Governança de IA em produção se mede na ponta do lápis: tokens de entrada, tokens de saída, taxa de acerto de cache (cache hits), latência e custo por PR.
Os próprios Pull Requests de construção do matryoshka-harness (abertos no board público do projeto no GitHub) servem de prova. Como desenvolvi a ferramenta inteira pelo fluxo do Ouroboros (decomposição de PRDs em subtarefas BDD e validação contínua), cada entrega registrou a telemetria real de consumo:
Telemetria Completa dos PRs do Matryoshka
| PR & Entrega | Subtasks | Tokens Input | Tokens Output | Cache Hits | Custo (USD) | Custo (BRL) |
|---|---|---|---|---|---|---|
PR #2: Polyglot Stack Detector & Base CLI (baba detect) |
3 | 82.213 | 920 | 0 | $0.0064 | R$ 0,04 |
PR #4: Harness-Score Oracle & baba scan |
5 | 698.055 | 5.405 | 98 | $0.0540 | R$ 0,31 |
| PR #6: GitHub Actions CI Gate & SemVer Release | 3 | 161.028 | 2.605 | 76 | $0.0128 | R$ 0,07 |
PR #9: Auto-Wire codebase-memory-mcp |
4 | 498.812 | 4.758 | 238 | $0.0388 | R$ 0,23 |
PR #10: Adaptive AGENTS.md & Modular Skills (agents generate) |
8 | 1.315.226 | 8.711 | 370 | $0.1012 | R$ 0,59 |
PR #13: Polyglot AST Engine (Tree-sitter WASM & baba wrap) |
5 | 87.379 | 3.249 | 0 | $0.0075 | R$ 0,04 |
PR #15: Native MCP Server (stdio JSON-RPC) |
5 | 952.071 | 6.894 | 215 | $0.0735 | R$ 0,43 |
| PR #18: Standalone Bun Binaries & NPM Distribution | 5 | 718.538 | 6.718 | 188 | $0.0559 | R$ 0,32 |
| PR #19: Launch README, CLI Help & Ouroboros Heritage | 4 | 334.281 | 2.058 | 156 | $0.0257 | R$ 0,15 |
| PR #20: Blast Radius Remediation (Docs & CLI Help) | 1 | 87.146 | 1.495 | 0 | $0.0070 | R$ 0,04 |
| PR #21: Technical Documentation Site (MkDocs) | 6 | 742.890 | 7.453 | 194 | $0.0579 | R$ 0,34 |
| PR #24: Cognitive Context Linter & Turn-Zero Simulator | 9 | 1.266.977 | 9.294 | 142 | $0.0978 | R$ 0,57 |
PR #25: Non-Destructive Legacy AGENTS.md Migration |
8 | 1.070.169 | 10.135 | 179 | $0.0833 | R$ 0,48 |
| PR #27: Interactive Skill Inspector & Terminal Selector | 7 | 597.465 | 5.018 | 270 | $0.1133 | R$ 0,66 |
PR #29: Layered Ignore Engine (.babaignore, --exclude) |
12 | 1.445.060 | 11.166 | 259 | $0.1876 | R$ 1,09 |
| TOTAL (Projeto Completo) | 85 | 10.057.310 | 85.879 | 2.385 | $0.9227 | R$ 5,36 |
Olhando para o acumulado da tabela: construí a ferramenta inteira do zero (CLI, motor de AST em WASM, servidor MCP nativo, migrador não-destrutivo, linter cognitivo, site de documentação e uma suíte com mais de 1.000 testes) processando mais de 10 milhões de tokens de entrada por $0.92 USD (R$ 5,36). Mesmo somando as execuções intermediárias barradas pelo Blast Radius Guard nas issues #1 e #11, o projeto completo custou menos de 1 dólar.
Como a conta fecha em centavos
O segredo aqui está na mecânica do KV Cache (Context Caching) dos provedores e no fatiamento de contexto:
- Prefixos estáveis e gatilhos de volume do Cache KV: Provedores como Google e Anthropic dão de 75% a 90% de desconto nos tokens de entrada quando o prefixo do prompt se mantém idêntico entre chamadas. Na documentação oficial da API do Gemini, o Context Caching opera com pisos mínimos por requisição: começou exigindo 32.768 tokens (32k) no Explicit Caching inicial e hoje dispara automaticamente via Implicit Caching a partir de 2.048 tokens (linha Gemini 2.5) ou 4.096 tokens (linhas Gemini 3 e 4). Isso explica o comportamento da tabela acima: em PRs curtos (como o
#2,#13e#20, na casa dos 80 mil tokens diluídos em subtarefas rápidas), as chamadas rodam abaixo da faixa de retenção (0cache hits). Já nas entregas pesadas que batem de 500 mil a 1,4 milhão de tokens acumulados (como os PRs#10,#15,#24e#29), a janela cruza o piso mínimo logo nos primeiros turnos e engata de 140 a 370 cache hits seguidos. - Isolamento do arquivo raiz (Hash de Prefixo): O cache KV do Google funciona por correspondência estrita de prefixo (prefix matching do byte zero até o ponto de mutação). Quando o
AGENTS.mdraiz é enxuto (< 200 tokens) e estático no topo do prompt, o hash inicial nunca muda e todo o bloco pesado que vem abaixo (schemas das tools MCP, contrato da Spec e árvore de arquivos) permanece congelado no cache. Já quando você pendura umAGENTS.mdmonolítico de 2.000 linhas na raiz e edita esse arquivo toda hora, você altera o começo do prompt, invalida o prefixo do cache KV a cada turno e paga tarifa cheia sobre milhões de tokens.
Olhando para o consumo diário de um desenvolvedor, a diferença fica clara:
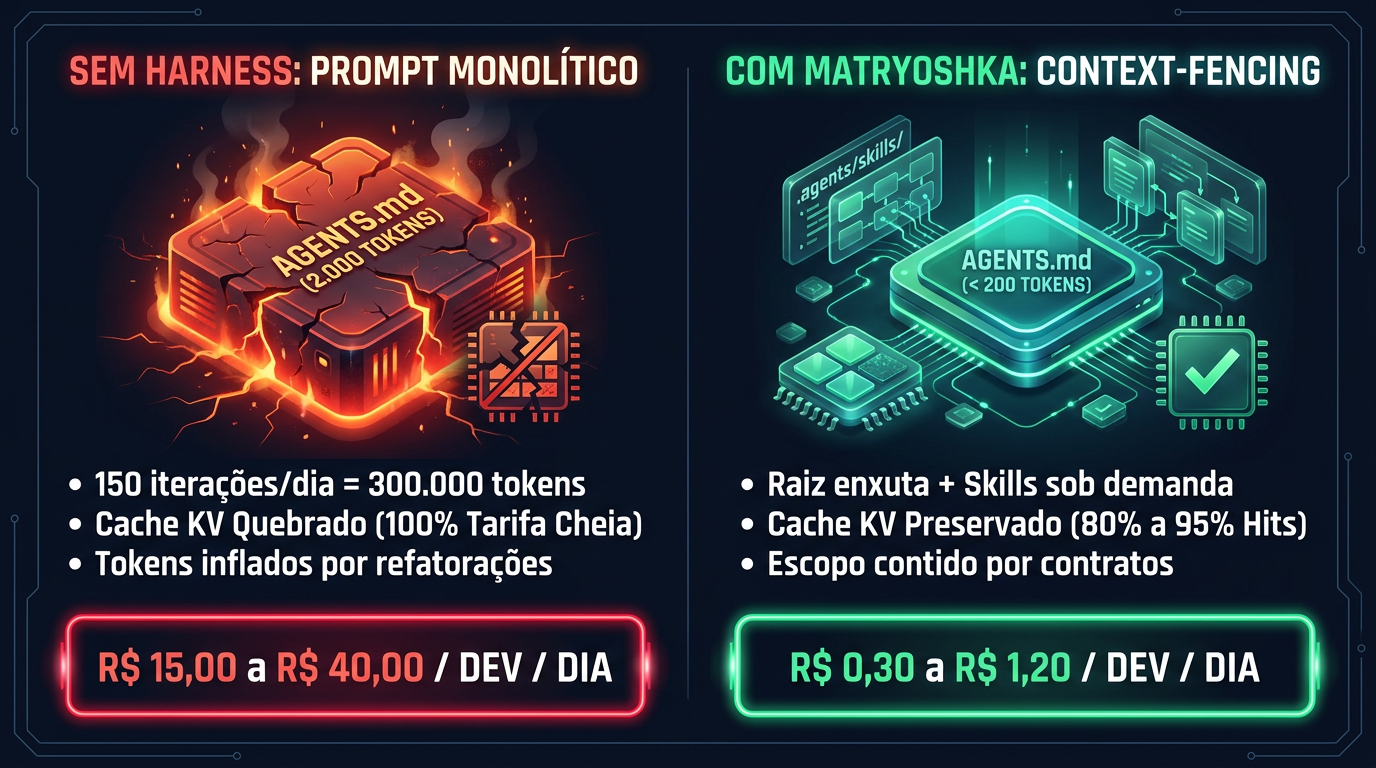
Num time de 20 pessoas rodando agentes o dia inteiro, essa diferença no fim do mês define se a esteira agêntica se paga ou se vira um centro de custo insustentável.
O Próximo Passo no Board: System-1 Fast-Gate (Jev / Laya)
No board público do projeto no GitHub, a Issue #31 traz o próximo passo dessa redução de custo: um Fast-Gate de Sistema 1.
Acionar um modelo autorregressivo grande (Claude Sonnet, GPT-4o ou modelos 70B+) para decisões binárias, como checar se um comando de terminal é destrutivo ou se um arquivo fere uma regra de pasta, desperdiça tempo e dinheiro.
A Issue #31 adiciona um cliente via POST /predict (HTTP ou Unix Domain Socket) integrado a encoders leves baseados em Jev / ModernBERT / Laya (NandhaKishorM/laya). As classificações (noul, choice, score) rodam na CPU em menos de 25ms e sem gastar tokens de API. O cliente trabalha com um timeout rígido de 50ms: se o daemon local não responder a tempo, o harness cai para as heurísticas em Tree-sitter WASM sem travar o fluxo do dev.
3. Fim do Instruction Debt em AGENTS.md e CLAUDE.md: O Linter Cognitivo (baba agents audit)
Enquanto o mercado começa agora a discutir instruction debt e a rodar scripts via LLM (como o /doctor prompt-audit em anthropics/skills) para caçar pressure language (CRITICAL, MUST, NEVER) e rituais obsoletos em arquivos Markdown isolados, o comando baba agents audit (adicionado no PR #24) trata o problema no nível da arquitetura do repositório e roda de forma determinística na CPU, sem gastar um único token de API.
| Dimensão | Anthropic prompt-audit |
Matryoshka Harness (baba agents audit) |
|---|---|---|
| Unidade de Análise | Arquivo Markdown isolado (CLAUDE.md) ou string de prompt |
Topologia do repositório, grafo de dependências e domínios da stack |
| Foco Central | Limpeza de palavras datadas (MUST, CRITICAL, think step by step) |
Orçamento rígido (< 200 tokens raiz), armadilhas cognitivas e fronteiras de AST |
| Contexto de Domínio | Agnóstico (não sabe se a regra é de banco, UI ou FinOps) | Consciente por matéria (isola regras em .agents/skills/ sob demanda) |
| Motor de Validação | Pede para o próprio LLM verificar se ainda precisa da regra | Sistema 1 Determinístico (Linter Cognitivo + Simulador Turn-Zero na CPU) |
Na prática, o baba agents audit combina o Cognitive Context Linter e o Turn-Zero Prompt Simulator para auditar cinco regras mecânicas:
- Orçamento do arquivo raiz (
Rule 1: token-budget): Dispara aviso aos 200 tokens e quebra o build (exit code 1) se o arquivo principal passar de 250 tokens, preservando o KV Cache Hit Rate. - Links órfãos (
Rule 2: dead-skills): Verifica na árvore de diretórios se oAGENTS.mdaponta para arquivos em.agents/skills/que foram movidos ou apagados, evitando que o agente perca turnos tentando ler caminhos inexistentes. - Armadilha de negação (
Rule 3: negative-phrasing-trap): Empilhar proibições no prompt de sistema (“NEVER do X”, “DO NOT use Y”) costuma produzir o efeito inverso, no estilo do clássico problema de pedir para alguém “não pensar num elefante cor-de-rosa”. Como você coloca o token proibido em evidência no mecanismo de atenção, a chance de o modelo reproduzir o padrão aumenta. O linter aponta o excesso de negativas e exige a reescrita na forma afirmativa. - Linguagem frouxa (
Rule 4: permissive-leak): Pega termos como “tente usar”, “se possível” ou “considere”. Para um LLM, sugestão vira escolha opcional; regra inegociável precisa de verbo no imperativo. - Despejo de código na raiz (
Rule 5: greedy-preload): Barra blocos de código ou schemas longos (> 25 linhas) dentro doAGENTS.md. Exemplos extensos e schemas devem morar na skill específica daquele domínio.
4. A Arquitetura das 5 Camadas (A Boneca Russa)
O nome Matryoshka vem das bonecas russas: cinco camadas concêntricas onde cada anel filtra o contexto e protege o código no núcleo.
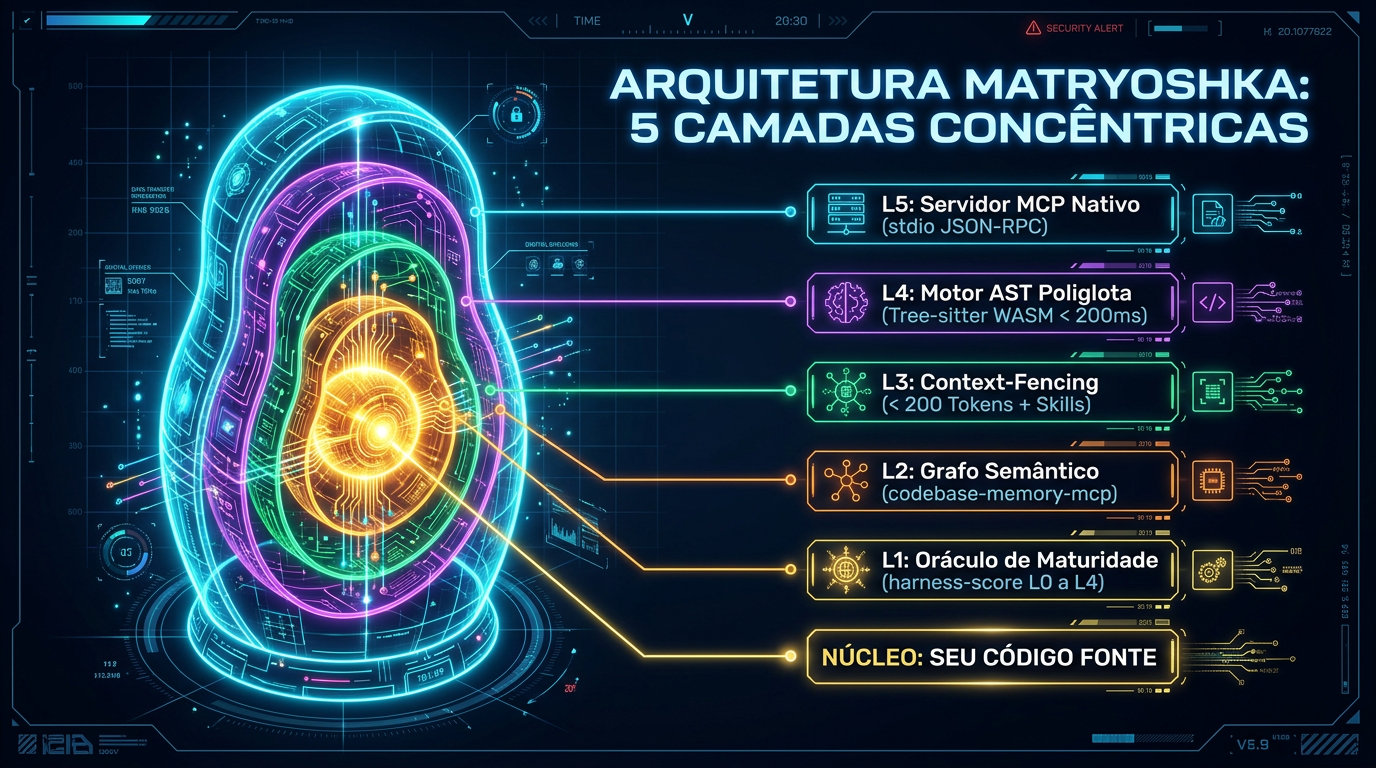
Camada 1: Repository Maturity Oracle (harness-score)
Para não reinventar a roda na medição da fundação do repositório, o comando baba scan [--badge] [--json] (PR #4 e PR #32) usa direto o paladini/harness-score, que já resolve essa auditoria estrutural e classifica a base nos cinco níveis definidos pela ferramenta:
- L0: Unharnessed (Cold-start every session): Repositório sem contexto nem estrutura para agentes. Toda sessão parte do zero (cold-start), forçando o modelo a redescobrir o projeto no escuro e deixando erros passarem direto se um humano não revisar no braço.
- L1: Documented (
AGENTS.mdorients the agent): Presença de um documento substantivo na raiz (AGENTS.mdouCLAUDE.md) explicando o que é o projeto, como buildar e testar, e em quais pastas ou arquivos o agente não deve tocar. - L2: Guided (Rules, skills, workflow, and hygiene): A orientação ganha implementação estrutural: regras escopadas (ex:
.cursor/rules/), comandos ou skills para tarefas repetidas e higiene básica de repositório (.gitignoreadequado, licença definida e zero segredos vazados). - L3: Sensing (Tests, types, and CI verify work): O repositório estabelece um loop de feedback verificável: test runner, linter, checagem estrita de tipos e pipeline de CI revalidando cada push para o próprio agente conferir o resultado do que escreveu.
- L4: Self-correcting (Hooks close the loop): O loop se fecha em tempo de execução: gate hooks tornam ações incorretas ou destrutivas estruturalmente impossíveis (e não apenas desencorajadas), enquanto inline feedback hooks formatam e rodam lint automaticamente no código.
Camada 2: Grafo Semântico (codebase-memory-mcp)
Pela mesma filosofia de usar o que já resolve o problema com excelência, a segunda camada integra o DeusData/codebase-memory-mcp (PR #9) para dar visão de raio-X ao agente sem queimar turnos rodando grep às cegas pela árvore de diretórios.
Quando auditei os mais de 110 projetos open source mapeados no IAAR-Shanghai/Awesome-AI-Memory e no catálogo de github.com/topics/agent-memory, ficou claro que a indústria de memória para agentes se dividiu em quatro frentes que atacam problemas diferentes do que o Matryoshka precisava:
- Memória Episódica e Handoff entre Agentes de Código (
akitaonrails/ai-memory,agent-memory.devethedotmack/claude-mem): Oai-memorydo Akita (em Rust) manda muito bem mantendo uma wiki em Markdown no Git para compartilhar decisões arquiteturais e histórico ao alternar entre Claude Code, Codex e Cursor; já oagent-memory.deve oclaude-memcapturam e comprimem as observações locais da sessão. Eles resolvem a amnésia conversacional entre turnos e ferramentas, mas não montam a AST nem o grafo de chamadas (call graph) para responder quem invoca uma função no código agora. - Motores de Memória de Longo Prazo e Grafos Cognitivos (
supermemoryai/supermemory,mem0ai/mem0,letta-ai/letta,getzep/zep,topoteretes/cognee,vectorize-io/hindsighteMemTensor/MemOS): São plataformas parrudas para extrair fatos, preferências de usuário, documentos e grafos temporais de diálogos, mas foram desenhadas para memória semântica/pessoal do agente (e muitas dependem de bancos vetoriais, APIs em nuvem ou chamadas extras de LLM para sumarizar memórias), não para inspecionar dependências estáticas de código em sub-milissegundos. - Bancos de Contexto em Filesystem Virtual (
volcengine/OpenViking): Criado pelo time da ByteDance/Volcengine, organiza memórias, documentos e skills num filesystem virtual (viking://) em camadas de resumo (ls,tree,read), focando na hierarquia de conhecimento do agente e não na resolução de tipos e rotas do repositório. - Toolkits MCP acoplados a Language Servers (
oraios/serena) e Empacotadores (yamadashy/repomix): Oserenanavega bem por símbolos, mas exige runtime Python e sobe processos Language Server (LSP) completos por linguagem no host; já orepomixdespeja o repositório inteiro num único arquivo texto no prompt inicial, o que estoura o orçamento de tokens em monólitos.
O DeusData/codebase-memory-mcp entrou na Camada 2 porque entrega memória estrutural de código empacotada num binário nativo único, estático e 100% portável (zero dependências de runtime, sem servidores LSP externos, sem banco de dados separado e sem chaves de API). Ele combina gramáticas Tree-sitter para mais de 150 linguagens com inferência de tipos híbrida embutida, indexa repositórios inteiros em segundos num snapshot compactado (.codebase-memory/graph.db.zst) e expõe o grafo via MCP (search_graph, trace_path, get_code_snippet e query_graph em Cypher). Com um único baba mcp wire, o Matryoshka injeta esse servidor de forma não-destrutiva no Cursor, Claude Code, Zed e Gemini CLI (além de já vir pré-instalado nas sandboxes --network none do Ouroboros): o agente rastreia a cadeia de chamadas (inbound/outbound) e carrega na janela de contexto apenas o snippet cirúrgico da função que vai alterar.
Camada 3: Context-Fencing, Arquétipos e Skills Modulares (baba agents)
Em vez de despejar um template genérico igual para todo projeto, o comando baba agents generate (PR #10, PR #25 e PR #27) passa primeiro pelo Archetype Profiler (baba agents profile). Ele inspeciona manifestos, dependências e rotas para classificar o repositório em cinco arquétipos canônicos (api_backend, opinionated_monolith, reactive_frontend, systems_microservice ou fullstack_hybrid) e monta a cerca em dois níveis:
- Tier 1:
AGENTS.mdraiz ultracompacto (< 200 tokens, teto rígido < 250): É o único bloco carregado em todos os turnos. Contém apenas a identidade do arquétipo, os comandos exatos de build/test/lint daquela stack, três travas anti-slop (YAGNI/DRY, zero refatoração fora do pedido e validação por teste) e a lista de ponteiros para as skills. - Tier 2: Skills escopadas por domínio com Frontmatter YAML obrigatório: Sem frontmatter, editores modernos fazem pre-fetch do corpo inteiro dos arquivos na inicialização da sessão. Por isso, cada skill gerada pelo Matryoshka exige
nameedescriptionno cabeçalho YAML (menos de 40 tokens por módulo):
<workspace_root>/
├── AGENTS.md                          # Cerca raiz (< 200 tokens, preserva o KV Cache)
└── .agents/
    └── skills/                        # Carregadas sob demanda via índice YAML (< 40 tokens)
        ├── backend/SKILL.md           # Padrões de ORM, transações e prevenção de N+1
        ├── frontend/SKILL.md          # Reatividade, A11y e prevenção de Layout Shift (CLS)
        ├── database/SKILL.md          # Migrations zero-downtime e índices concorrentes
        ├── security/SKILL.md          # Defesas OWASP Top 10 e sanitização de inputs
        ├── testing/SKILL.md           # Contrato de TDD Red-to-Green e fronteira de mocks
        └── <project-name>/SKILL.md    # Regras humanas legadas migradas sem perda
Se a tarefa é criar uma migration, o agente lê apenas os 40 tokens do índice YAML, abre database/SKILL.md e mantém as regras de React, Tailwind e ORM fora da janela de contexto (cortando mais de 85% do consumo de tokens por turno). E se o repositório já tinha um AGENTS.md antigo escrito pelo time, o migrador não-destrutivo (PR #25) faz backup em .bak e encapsula 100% das regras humanas legadas dentro de .agents/skills/<project-name>/SKILL.md antes de enxugar a raiz.
Camada 4: Polyglot AST Engine em Tree-sitter WASM (baba wrap)
Linters tradicionais (ESLint, PyAST, plugins de compilador) exigem que o host tenha o runtime da linguagem, compiladores C/C++ ou ambientes virtuais configurados, o que vive quebrando em sandboxes efêmeras e runners de CI. Para eliminar essa dependência, empacotei os parsers do Tree-sitter em WebAssembly (WASM) (PR #13) rodando 100% em memória dentro do Bun.
O motor varre árvores em TypeScript, JavaScript, Python, Go e Rust na CPU em menos de 200ms (pulando binários pelos primeiros 8KB, limitando arquivos a 500KB e aplicando timeout de 2.000ms por arquivo) para auditar três regras estruturais na AST:
raw-sql(CWE-89 SQL Injection): Percorre nós de chamada (query,execute,raw,exec) e barra interpolações dinâmicas de string (TemplateLiteralcom expressões em TS/JS,JoinedStr/ f-strings em Python efmt.Sprintfem Go), exigindo queries parametrizadas.assertionless-test(Testes Falsos-Verdes via--include-tests): Inspeciona o corpo das funções de teste (it/test,def test_*,func Test*,#[test]). Se o teste instancia classes e roda mocks mas termina com zero chamadas reais de verificação (expect,assert,t.Fatal,assert_eq!), o harness bloqueia antes do push.hardcoded-credential(Assinaturas + Entropia de Shannon): Além de pegar prefixos conhecidos (sk_live_,ghp_,AKIA,AIza,xoxb-) e variáveis sensíveis atribuídas a literais, o motor calcula a Entropia de Shannon ($H(S) = -\sum p(x)\log_2 p(x)$) em cada string literal: chaves com comprimento $\ge 16$ caracteres e entropia $H > 3.0$ são barradas na hora (isentando leituras seguras viaprocess.envouos.environ).
Ao final da varredura, o baba wrap compila o relatório DIAGNOSTIC.md com um teto rígido de 1.500 tokens, garantindo que o plano de correção possa ser devolvido ao agente sem inflar a janela de contexto.
Camada 5: Servidor MCP Nativo via stdio e Isolamento de Stream (baba mcp)
Fechando o anel externo, o comando baba mcp serve (PR #15) expõe todo o motor do Matryoshka como um servidor Model Context Protocol (MCP) nativo sobre stdio (JSON-RPC 2.0):
- Zero portas de rede expostas: Rodar sobre
stdioem vez de subir servidores HTTP/SSE locais elimina o risco de execução remota não autenticada via localhost e permite que o servidor rode dentro de containers em airgap (--network none). - Blindagem de Stream (
installStderrLoggingGuard): Em conexões MCP viastdio, qualquerconsole.logacidental impresso nostdoutcorrompe o frame JSON-RPC e derruba a sessão do agente no editor. O servidor aplica um interceptador de stream que redireciona qualquer telemetria ou log parastderr, mantendo ostdoutexclusivo para envelopes JSON-RPC. - 4 Tools, Resources (
matryoshka://) e Auto-Wiring Idempotente: O próprio agente dentro do Cursor, Claude Code, Zed ou Gemini CLI ganha acesso direto às toolsdetect_stack,scan_harness,generate_agentsewrap_context, além dos resources dinâmicosmatryoshka://agentsematryoshka://diagnostice do prompt guiadoaudit_repository. Para configurar tudo sem editar JSON na unha, o comandobaba mcp wirefaz um deep merge idempotente e não-destrutivo em.cursor/mcp.json,.claude/mcp.jsone.gemini/settings.json, preservando 100% dos outros servidores MCP e preferências que você já tem na máquina.
5. Runtime Bun, Folclore Eslavo e a História dos Comandos
Ferramenta de governança que dá trabalho para instalar ou que exige digitar um nome complicado no terminal acaba ignorada pelo time no segundo dia. Por isso escrevi o Matryoshka em Bun (com publicação direta via bunx no NPM e binários standalone nativos para Linux, macOS e Windows nas releases do GitHub) e expus três executáveis que apontam para o mesmo motor:
baba(A Matriarca Eslava): Digitarmatryoshkatoda hora no terminal é pedir para errar consoante.babatem quatro letras alternadas no teclado, zero atrito de digitação e virou o binário padrão para o dia a dia do dev.bbyg(Baba Yaga): No folclore eslavo, a Baba Yaga é a guardiã implacável da fronteira da floresta: se você cumpre o contrato e responde certo, ela abre o caminho; se chega no improviso, ela te engole. Dentro das sandboxes do Ouroboros,bbygvirou o atalho dos pods autônomos para disparar a auto-remediação pesada (bbyg fix --yes).matryoshka(O Nome Canônico): Mantido para scripts de CI/CD, GitHub Actions e hooks de pre-commit, onde ler o nome completo no YAML ajuda na auditoria do pipeline.
Como cada comando nasceu de uma cicatriz real
Nenhum subcomando da CLI foi desenhado em quadro branco; cada um entrou no repositório para estancar um vazamento específico de tokens ou de qualidade durante a construção dos PRs:
baba detect [path] [--json](PR #2): Nasceu quando percebi que agentes autônomos queimavam os primeiros quatro ou cinco turnos rodandolse lendopackage.jsonoupyproject.tomlsó para adivinhar qual era o test runner (pytest,bun test,go test) e o framework da base. Odetectentrega essa radiografia mastigada em milissegundos.baba scan [--badge] [--json](PR #4 e PR #32): Criado logo depois do susto do “Score 34%” na Issue #1. Ele roda o oráculo de maturidade (L0aL4), reconcilia os achados com a árvore do projeto e já exporta um badge SVG (--badge ./harness-badge.svg) para estampar o nível de governança no README.baba agents [generate | profile | audit | migrate | check | skill](PRs #10, #24, #25 e #27): A suíte cirúrgica de contexto. Começou com oprofile(que classifica o arquétipo do projeto) e ogenerate(que compila a raiz< 200 tokense as skills em.agents/skills/, com modo--interactiveem TUI para escolher os módulos no terminal). Quando esbarrei em repositórios que já tinham regras antigas escritas pelo time, criei omigrate(que faz backup e preserva o conhecimento legado na skill do projeto); e quando a discussão de instruction debt ganhou corpo, adicionei oaudite ocheckpara quebrar o build se alguém inflar oAGENTS.mdou colocar armadilhas de negação.baba wrap [--strict] [--threshold 80] [--include-tests](PR #13): O comando que “embrulha” e blinda a entrega antes do commit. Roda o motor Tree-sitter WASM em menos de 200ms na CPU, caça SQL raw, segredos por entropia de Shannon e suítes de teste sem asserção, e grava o contratoDIAGNOSTIC.md.baba mcp [wire | serve](PRs #9 e #15): Nasceu do cansaço de editar.cursor/mcp.json,.claude/mcp.jsone.gemini/settings.jsonna mão a cada repositório novo (e do risco de quebrar um JSON existente). Owireinjeta ocodebase-memory-mcpcom deep merge idempotente, enquanto oservesobe o próprio Matryoshka como servidor MCP viastdio.bbyg fix [--yes] [--dry-run](O Botão de Assimilação no Turno Zero): O comando que junta a orquestra inteira num único disparo de sub-segundo para tirar um repositório legado doL0(Unharnessed) e levar direto aoL4(Self-correcting): descobre a stack, gera oAGENTS.mdenxuto, cria as skills modulares, monta um blueprint inicial de arquitetura (ARCHITECTURE.md), cria um workflow base de CI em.github/workflows/ci.ymladaptado ao seu test runner e já faz o auto-wire do MCP nos editores:
# 1. Radiografia instantânea da stack e do arquétipo
baba detect

# 2. Medir a maturidade (L0 a L4) e gerar o badge SVG do repositório
baba scan --badge

# 3. Migrar um AGENTS.md legado sem perder regras humanas e auditar instruction debt
baba agents migrate
baba agents audit --strict

# 4. Varrer a AST em WASM (< 200ms) incluindo suítes de teste e gerar o DIAGNOSTIC.md
baba wrap --include-tests --strict

# 5. Ou rodar a assimilação completa de Turno Zero (do L0 ao L4 num único comando)
bbyg fix --yes
6. O Segredo do Contrato de Auto-Remediação (DIAGNOSTIC.md)
Quando um linter tradicional ou um step de CI falha num repositório grande, ele despeja centenas de linhas de stacktrace e warnings desordenados no stdout. Se você copia essa saída bruta e joga no prompt do agente, duas coisas acontecem: você queima milhares de tokens de uma vez e o modelo se perde no barulho, arrumando um aviso cosmético de formatação enquanto deixa uma query SQL vulnerável ou um teste sem asserção passar batido.
Uma verificação determinística só fecha o loop de verdade quando a própria mensagem de erro já vem formatada como instrução de reparo para a máquina. É exatamente esse o papel do DIAGNOSTIC.md gerado ao rodar baba wrap:
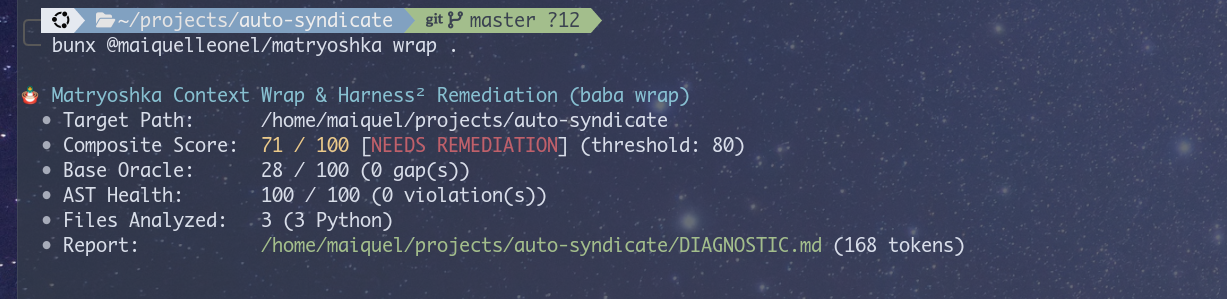
Repare na última linha do terminal ali na imagem: Report: .../DIAGNOSTIC.md (168 tokens). O compilador do relatório não joga texto livre no disco; ele constrói um contrato determinístico de auto-remediação na raiz do repositório:
# 🛡️ Matryoshka Diagnostic & Harness² Remediation Report

**Generated:** 2026-11-04T20:48:25.212Z
**Target Repository:** `/home/maiquel/projects/auto-syndicate`
**Harness² Composite Score:** **71 / 100** [Status: NEEDS REMEDIATION]

---

## 📊 Score Breakdown
- **Base Repository Hygiene (Oracle):** 28 / 100
- **AST Context-Fencing Health:** 100 / 100
- **Total Files Analyzed:** 3 files (3 Python)
- **Violations Detected:** None (Clean)

---

## 🚨 Detected AST Violations No AST context-fencing violations detected. Repository is clean!

---

## 🎯 Step-by-Step Surgical Action Plan
1. [x] All governance gates and AST context-fencing rules satisfied.
2. [ ] Re-run `baba wrap --strict` in CI to ensure continuous compliance.
E quando o motor de AST encontra violações no código (como um SQL Injection ou um teste falso-verde), a seção Detected AST Violations lista cada falha com endereço cirúrgico na árvore sintática:
### 1. [CRITICAL] Unparameterized SQL Query (SQL Injection Hazard)
- **File:** `src/db/users.ts:42`
- **Node Type:** `CallExpression`
- **Remediation:** Replace dynamic string interpolation with parameterized queries and bound variables.

### 2. [HIGH] Assertionless Test Case (False Green Hazard)
- **File:** `tests/billing.test.ts:18`
- **Node Type:** `CallExpression`
- **Remediation:** Add explicit behavioral assertions (`expect`, `assert`) verifying the output of the tested function.
Por trás desse arquivo Markdown aparentemente simples, existem quatro travas de engenharia que fazem o agente consertar o código num único turno sem estourar o orçamento:
- Orçamento rígido de FinOps (
MAX_DIAGNOSTIC_TOKENS = 1.500): Enquanto monta o relatório, o compilador calcula o peso em tokens em tempo real (e já reserva até 250 tokens para o plano de ação do rodapé). Se você apontar obaba wrappara um monólito legado com 300 violações e o texto encostar no teto de 1.500 tokens, o compilador trunca o restante da lista automaticamente e insere um aviso apontando parababa wrap --json. Assim, o relatório nunca explode a janela de contexto do modelo. - Ordenação determinística para o mecanismo de atenção: Antes de escrever a primeira linha, o motor ordena todas as falhas por severidade estrita (
CRITICAL, depoisHIGH,MEDIUMeLOW, desempatando por ordem alfabética de arquivo e número da linha). Isso garante que vulnerabilidades de segurança (raw-sqlehardcoded-credential) e testes falsos-verdes fiquem sempre no topo absoluto do arquivo, onde a atenção do LLM é mais forte. - Coordenada de AST pronta para edição (
File+Node Type+Remediation): Em vez de obrigar o agente a abrir o arquivo inteiro para procurar onde está o problema, cada item já entrega o arquivo, a linha exata, o tipo do nó na AST do Tree-sitter e a instrução imperativa de como refatorar. - Escrita atômica e Loop Fechado via MCP (
matryoshka://diagnostic): O relatório é gravado de forma atômica (.tmpseguido derename) e fica disponível instantaneamente para qualquer editor conectado via MCP pelo URImatryoshka://diagnostic. No fim do arquivo, o último item doStep-by-Step Surgical Action Plansempre instrui o agente a rodarbaba wrap --strictnovamente para provar que zerou as violações antes de abrir o Pull Request.
7. O Desafio dos 15 Segundos: Qual é o Score do Seu Repositório Hoje?
Modelos de fronteira vão continuar ficando mais rápidos a cada trimestre, mas nenhum modelo novo conserta um repositório mudo. Enquanto as regras do seu projeto morarem num AGENTS.md de 2.000 linhas escrito no improviso e a verificação depender de boa vontade no code review, o seu time vai continuar pagando pedágio de cache KV e caçando teste falso-verde no braço.
A boa notícia é que você não precisa pedir permissão, subir container nem alterar uma única linha do seu projeto para tirar a prova real agora. Os comandos de diagnóstico rodam 100% locais na CPU e não modificam nada no disco.
Abra o terminal na raiz do repositório que paga os boletos da sua empresa e rode o teste dos 15 segundos:
# 1. Descubra o Score (0 a 100) e o nível real do seu repositório (L0 a L4)
bunx @maiquelleonel/matryoshka scan

# 2. Audite o seu AGENTS.md / CLAUDE.md contra instruction debt e quebra de cache KV
bunx @maiquelleonel/matryoshka agents audit

# 3. Varra a AST em WebAssembly (< 200ms) atrás de testes sem assert, SQL raw e segredos
bunx @maiquelleonel/matryoshka wrap --include-tests --dry-run
Se curtir o diagnóstico e quiser instalar o binário baba globalmente para blindar o repositório, ligar o grafo semântico no seu editor (Cursor, Claude Code, Zed ou Gemini CLI) e travar o seu CI contra regressões:
# Instalar globalmente via Bun (ou baixar o binário nativo nas Releases do GitHub)
bun add -g @maiquelleonel/matryoshka

# Assimilar o repositório (gera AGENTS.md < 200 tokens, skills modulares e conecta o MCP)
bbyg fix

# Trava de qualidade para colocar no seu GitHub Actions / hook de pre-commit
baba agents audit --strict && baba wrap --include-tests --strict
Construa Junto, Deixe sua Estrela e Conheça o Ouroboros
O Matryoshka nasceu na trincheira para resolver uma dor real de produção e tem código 100% aberto (licença MIT). Se você curte engenharia de contexto, compiladores, Tree-sitter WASM e FinOps de agentes, tem espaço de sobra para construir junto:
- ⭐ Deixe uma estrela e acompanhe no GitHub: github.com/maiquelleonel/matryoshka-harness (ajuda demais o projeto a furar a bolha e chegar em mais times de engenharia)
- 📋 Roadmap Público e Issues Abertas: github.com/users/maiquelleonel/projects/4 (PRs com novas regras de AST, suporte a mais linguagens no detector e novas skills de frameworks são muito bem-vindos)
- 🌐 Hotsite Interativo: matryoshka-harness.leonellabshq.dev
- 📚 Documentação Completa: matryoshka-harness.leonellabshq.dev/docs/
- 📦 Pacote Oficial no NPM:
@maiquelleonel/matryoshka - 🐍 Ouroboros Engine (O Próximo Passo): Se depois de cercar o seu repositório com o Matryoshka você cansar de ficar preso na frente da IDE dando prompt de turno em turno e quiser delegar da Issue/PRD direto ao Pull Request verde em sandboxes airgap (
--network none) por centavos, conheça a nossa fábrica autônoma em ouroboros.leonellabshq.dev e garanta seu lugar na waitlist do beta privado.
Agora é com você: quando você rodou o baba scan e o baba wrap --include-tests no seu projeto principal, qual foi o Score de 0 a 100 e em qual nível entre L0 e L4 ele caiu? Conta aí nos comentários (principalmente se o motor de AST desmascarou algum teste falso-verde que estava passando limpo no seu CI).
Menos mágica, mais engenharia.
